Intelligence de processus intuitive

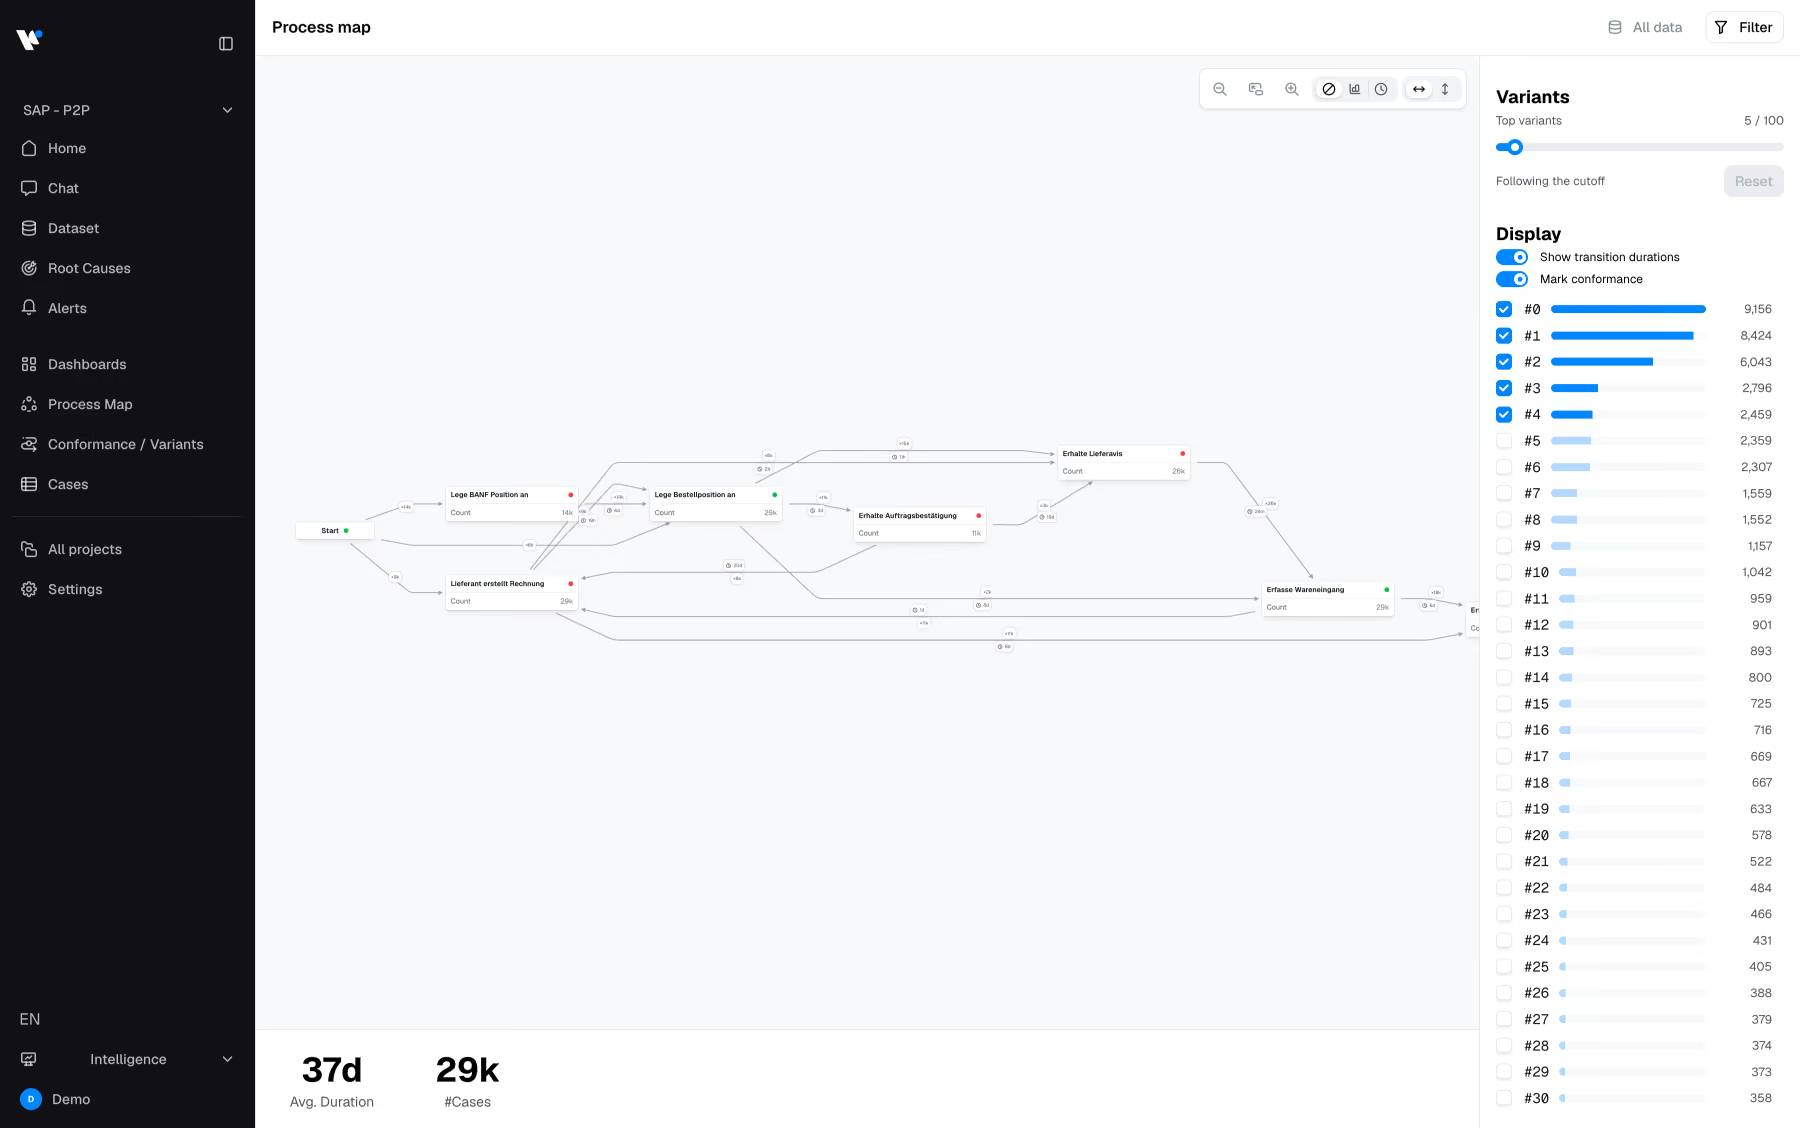
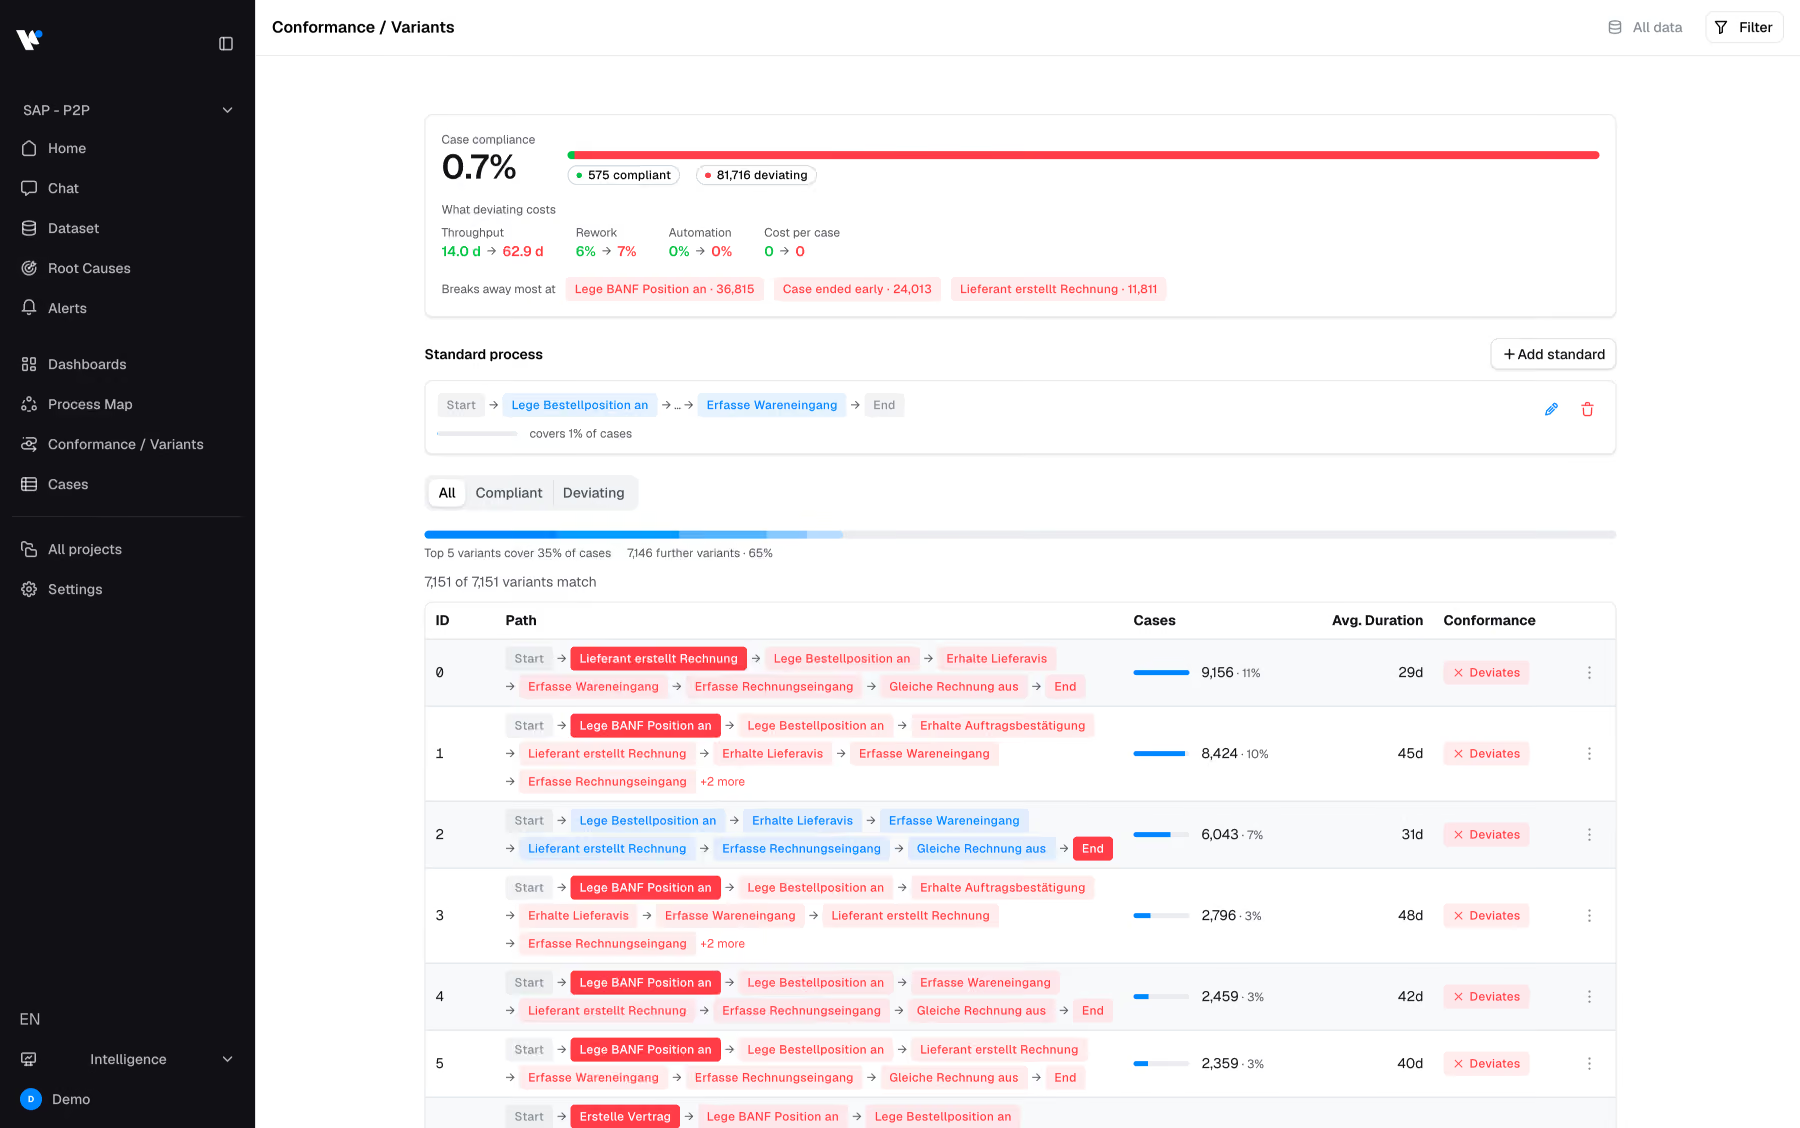

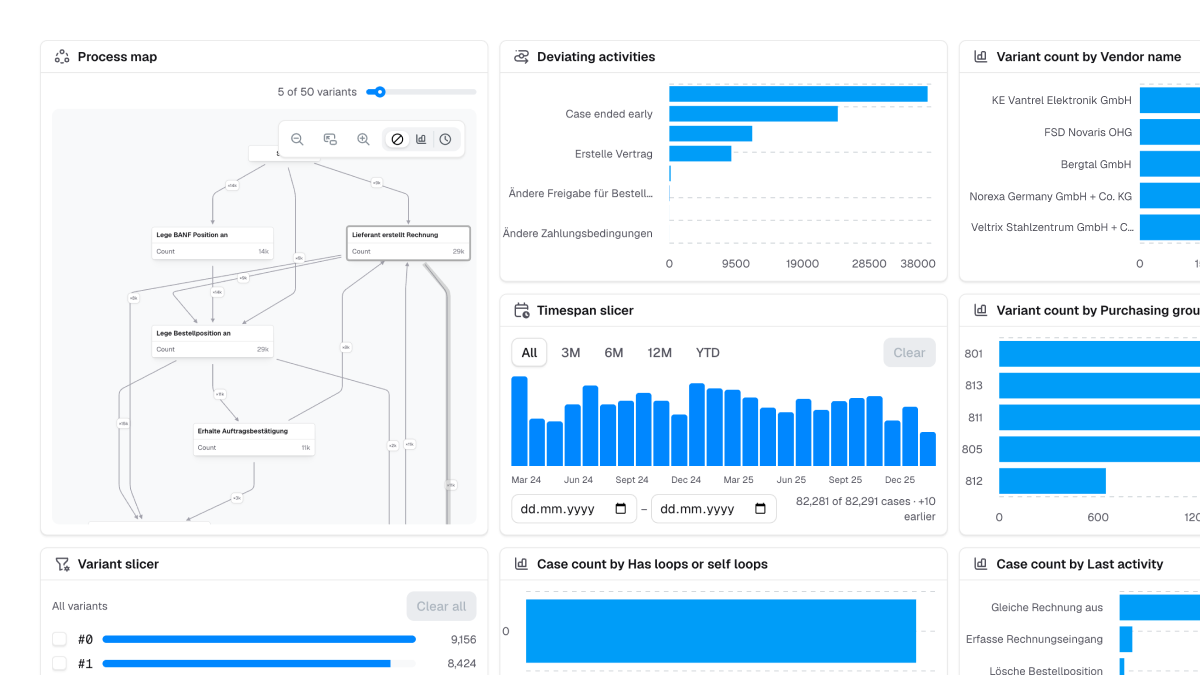
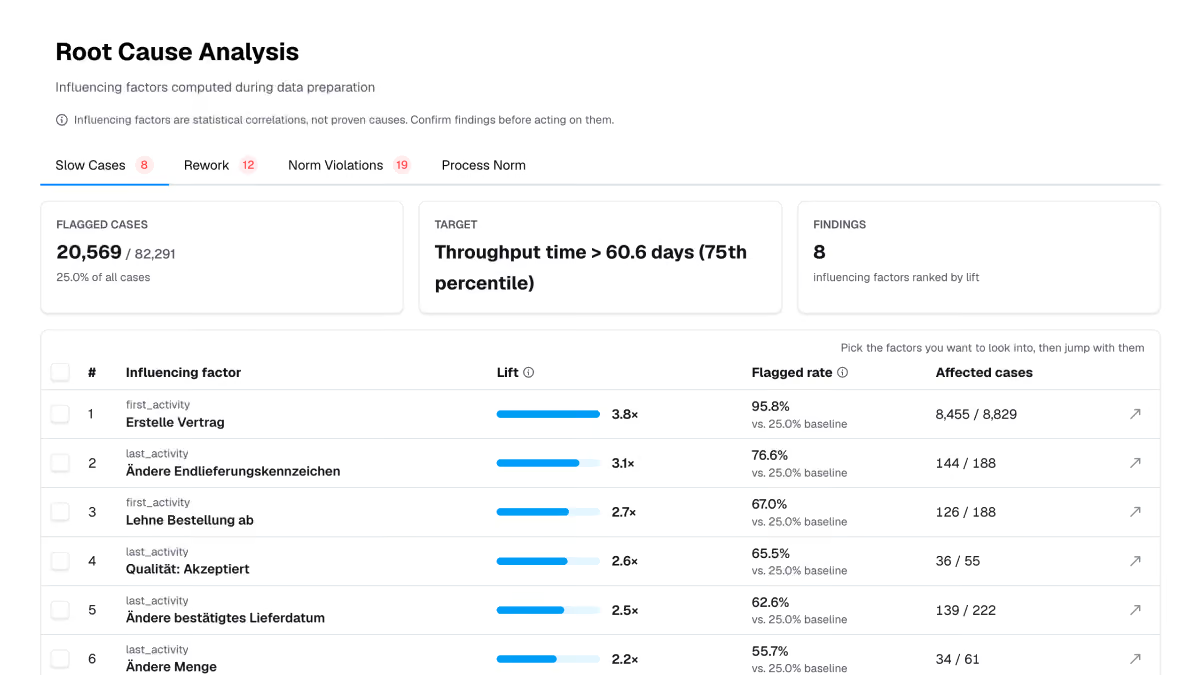
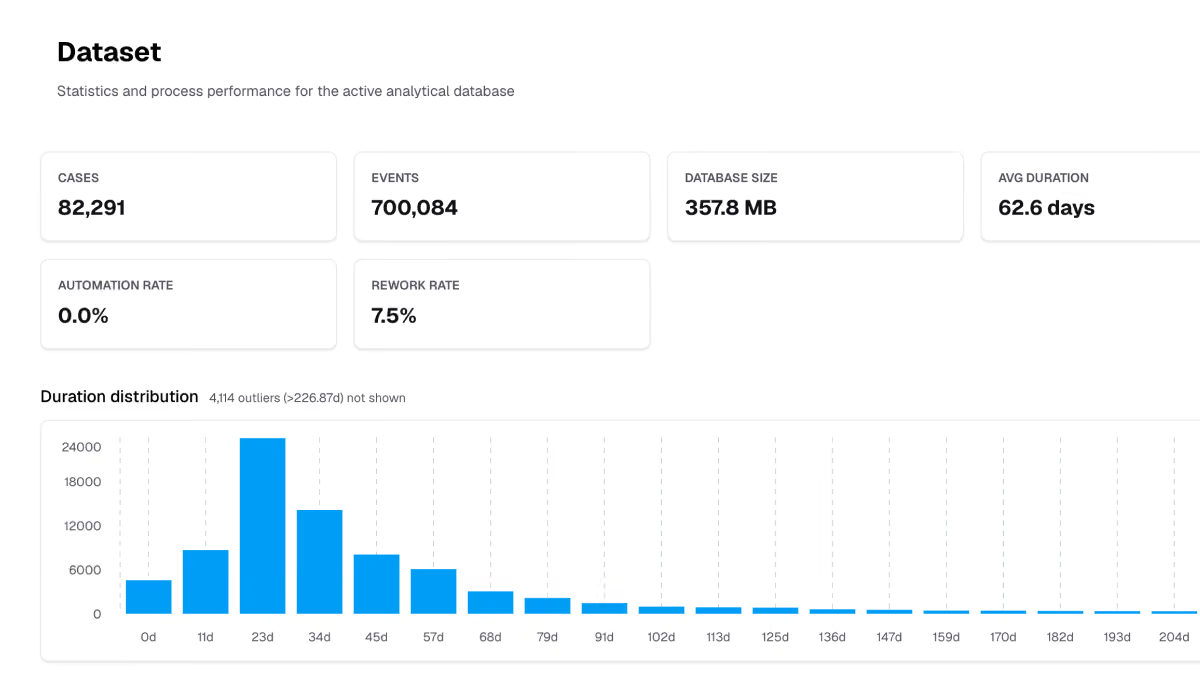
Données extraites de vos systèmes opérationnels, généralement votre ERP, ce qui représente souvent une poignée de tables pour la plupart des processus. Notre outil de préparation de données les transforme en un journal d'événements propre, vous évitant ainsi d'avoir à en fournir un vous-même. Si vous disposez déjà d'un journal d'événements, nous pouvons également l'utiliser.
Non. Contrairement à nos intégrations bien connues pour Microsoft ou Qlik, process.science Intelligence est conçu comme une plateforme totalement autonome. Tout ce dont vous avez besoin, ce sont vos données ERP extraites.
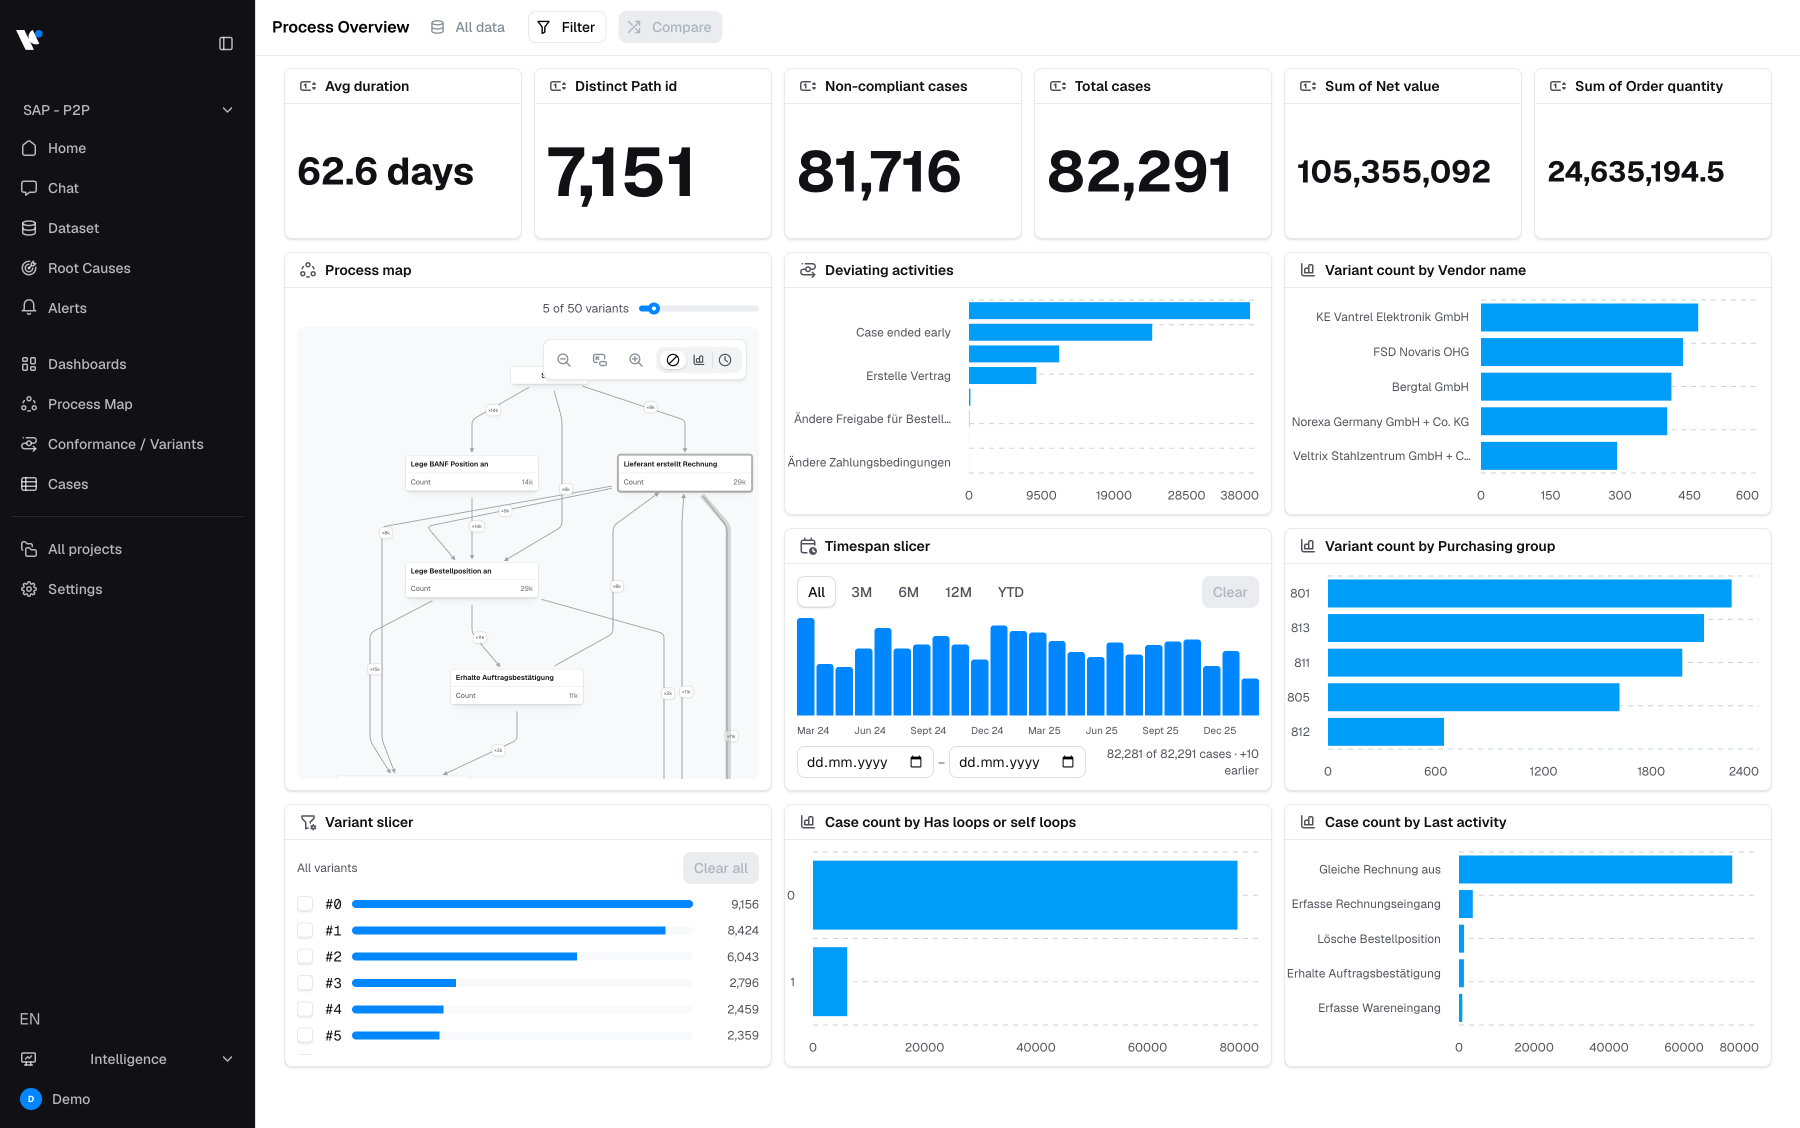
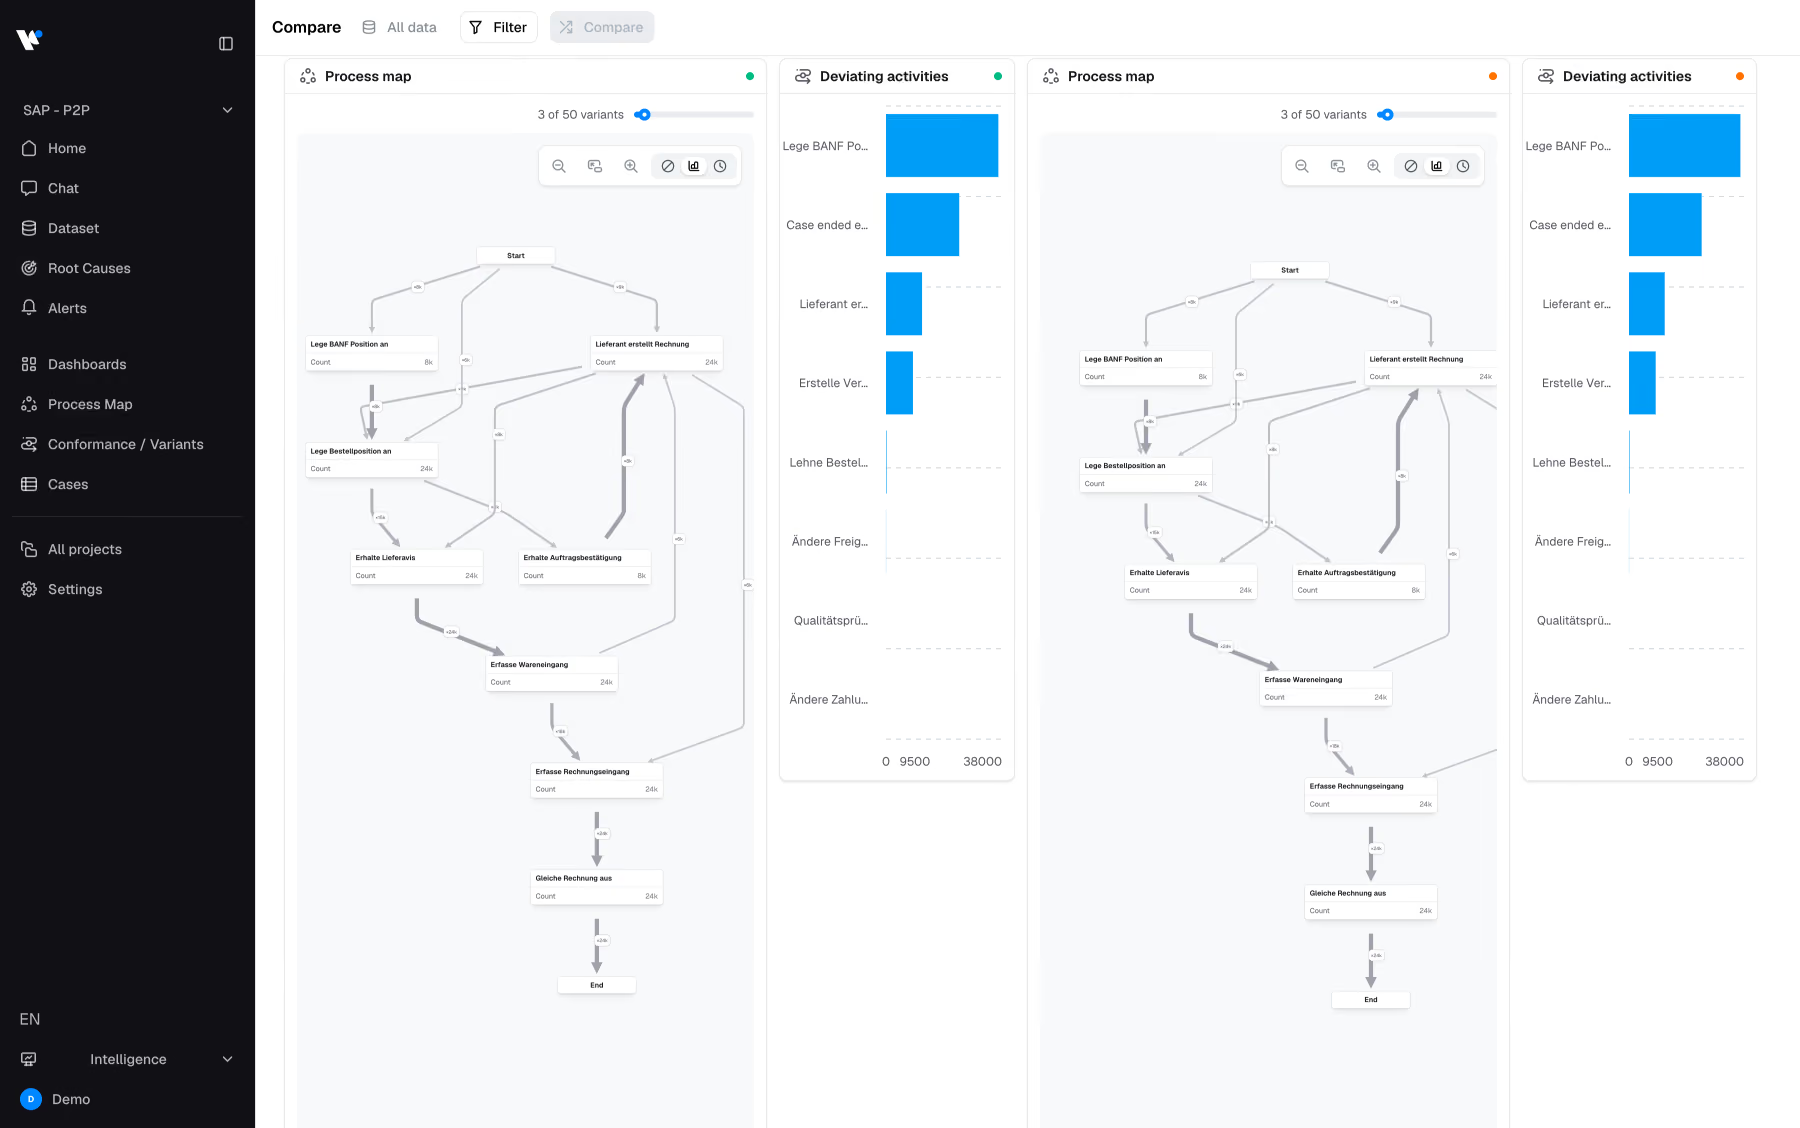
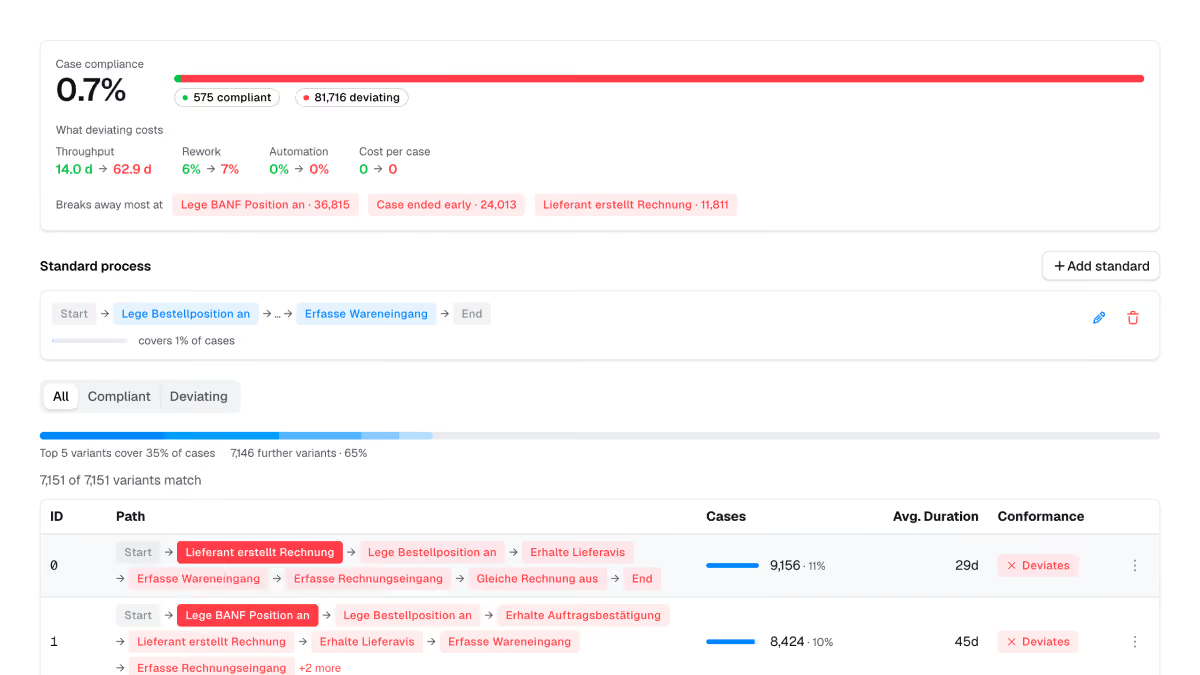
Intelligence est fourni avec des normes de processus par défaut qui couvrent les écarts courants : boucles de retravail, étapes sautées, séquences interrompues, temps d'attente inhabituels. Le suivi commence donc dès votre premier jeu de données. Dans la configuration, vous pouvez affiner ces normes ou enregistrer un processus cible comme référence, dès que vous souhaitez être plus précis concernant votre propre activité.
Vous n'avez pas besoin de formuler une hypothèse pour ensuite filtrer vos données en ce sens. Intelligence recherche lui-même dans vos données les facteurs à l'origine d'un problème — par exemple, un fournisseur, une usine ou un type de commande apparaissant de manière disproportionnée parmi les cas retardés — et les classe selon leur degré de corrélation. Il vous montre ensuite les preuves derrière chaque constat, afin que le résultat puisse être vérifié plutôt que simplement cru. La dernière étape, qui consiste à décider si un facteur est bien la cause profonde et à agir en conséquence, reste entre les mains des experts métier.
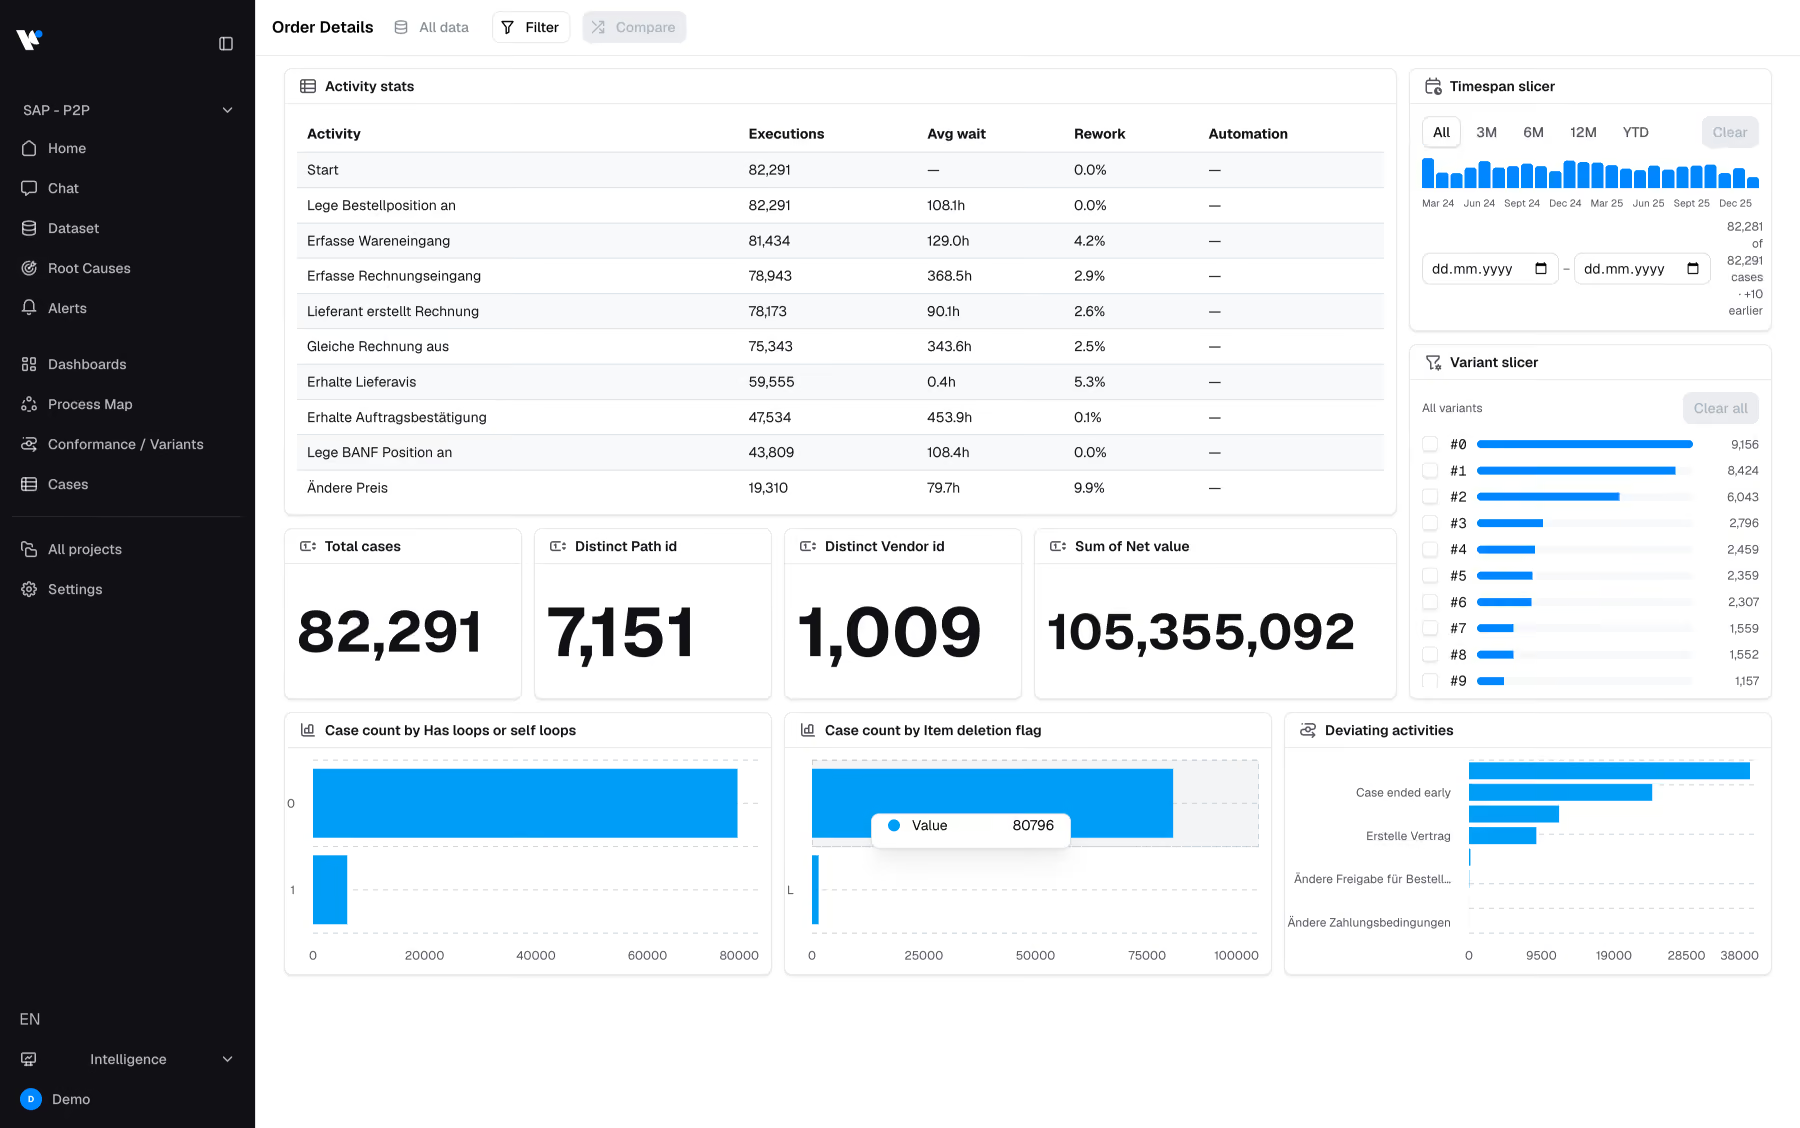
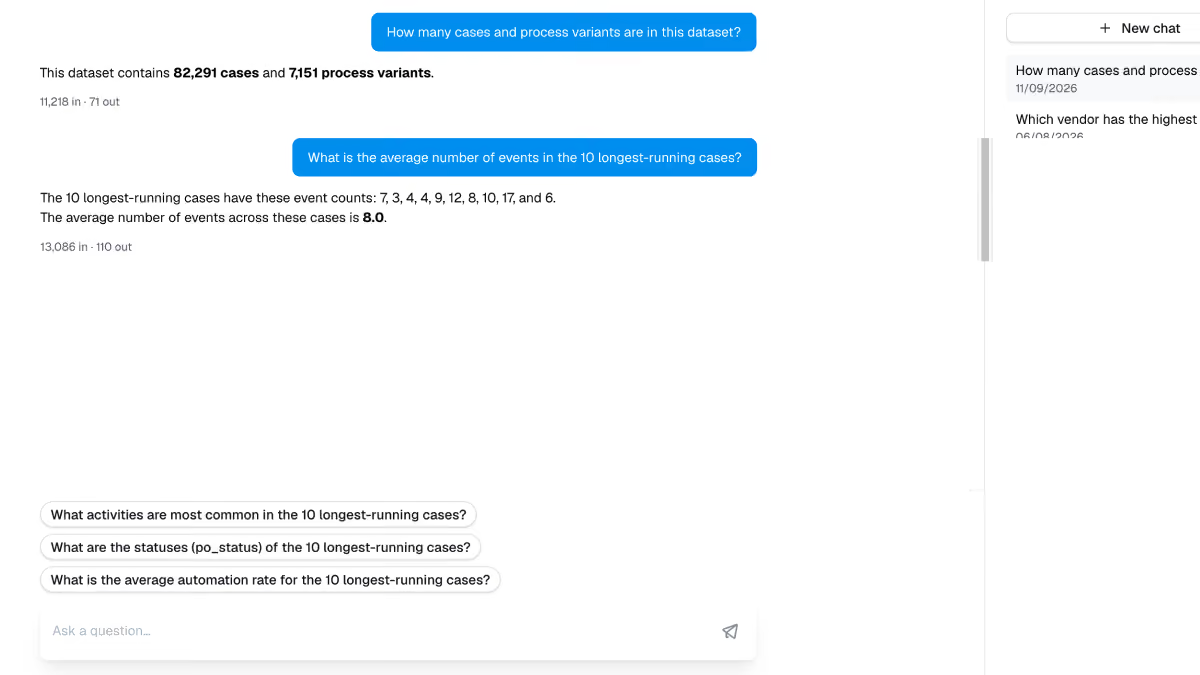
Oui, car le chat ne fait pas d'estimations. Votre question est traduite en une requête sur vos données de processus, et la réponse provient des mêmes calculs que ceux qui génèrent les vues d'analyse. Chaque résultat que vous enregistrez en tant qu'insight conserve l'outil, la période, les filtres, la sélection, la population concernée et la version du jeu de données, afin que quiconque puisse vérifier le chiffre ultérieurement.
Aucune expertise en science des données n'est requise. Il existe trois rôles : un administrateur pour les projets et les jeux de données, un analyste qui configure les paramètres et exécute les analyses, et des utilisateurs métier qui consultent les informations et posent des questions via le chat. L'utilisation quotidienne incombe principalement aux personnes qui connaissent le processus, et non la base de données.
Vos données de processus restent dans l'environnement convenu et ne sont jamais utilisées pour entraîner des modèles publics. Les modèles de langage que nous utilisons sont des modèles d'entreprise isolés. Process.Science est conforme au RGPD et certifié ISO 27001, et les droits d'accès contrôlent les processus et les données que chaque utilisateur peut interroger.
L'outil de préparation des données crée et gère les journaux d'événements, Intelligence les analyse, et l'IoT Miner ajoute les données des machines et des capteurs là où votre processus atteint l'atelier. Ils fonctionnent ensemble, mais chacun peut également être utilisé de manière autonome.