Préparation automatisée des données

Évitez le plus difficiledu Process Mining

L'outil de préparation de données de Process.Science transforme les données brutes issues de SAP, Microsoft Dynamics 365 et de vos propres bases de données en journaux d'événements prêts à l'analyse. Aucun projet d'ingénierie de données, aucun ETL écrit à la main. Choisissez un processus prêt à l'emploi, connectez votre système, et chaque exécution planifiée fournit un journal d'événements complet vers Power BI ou Process.Science Intelligence.

Tout ce qui précède l'analyse,déjà résolu

Rapide à mettre en place, flexible avec vos systèmes et rigoureux sur la qualité des journaux d'événements, car c'est sur cette base que repose toute votre analyse ultérieure.
Page de synthèse d'un pipeline Purchase-to-Pay dans le Data Preparation Tool, avec l'historique des exécutions et les activités
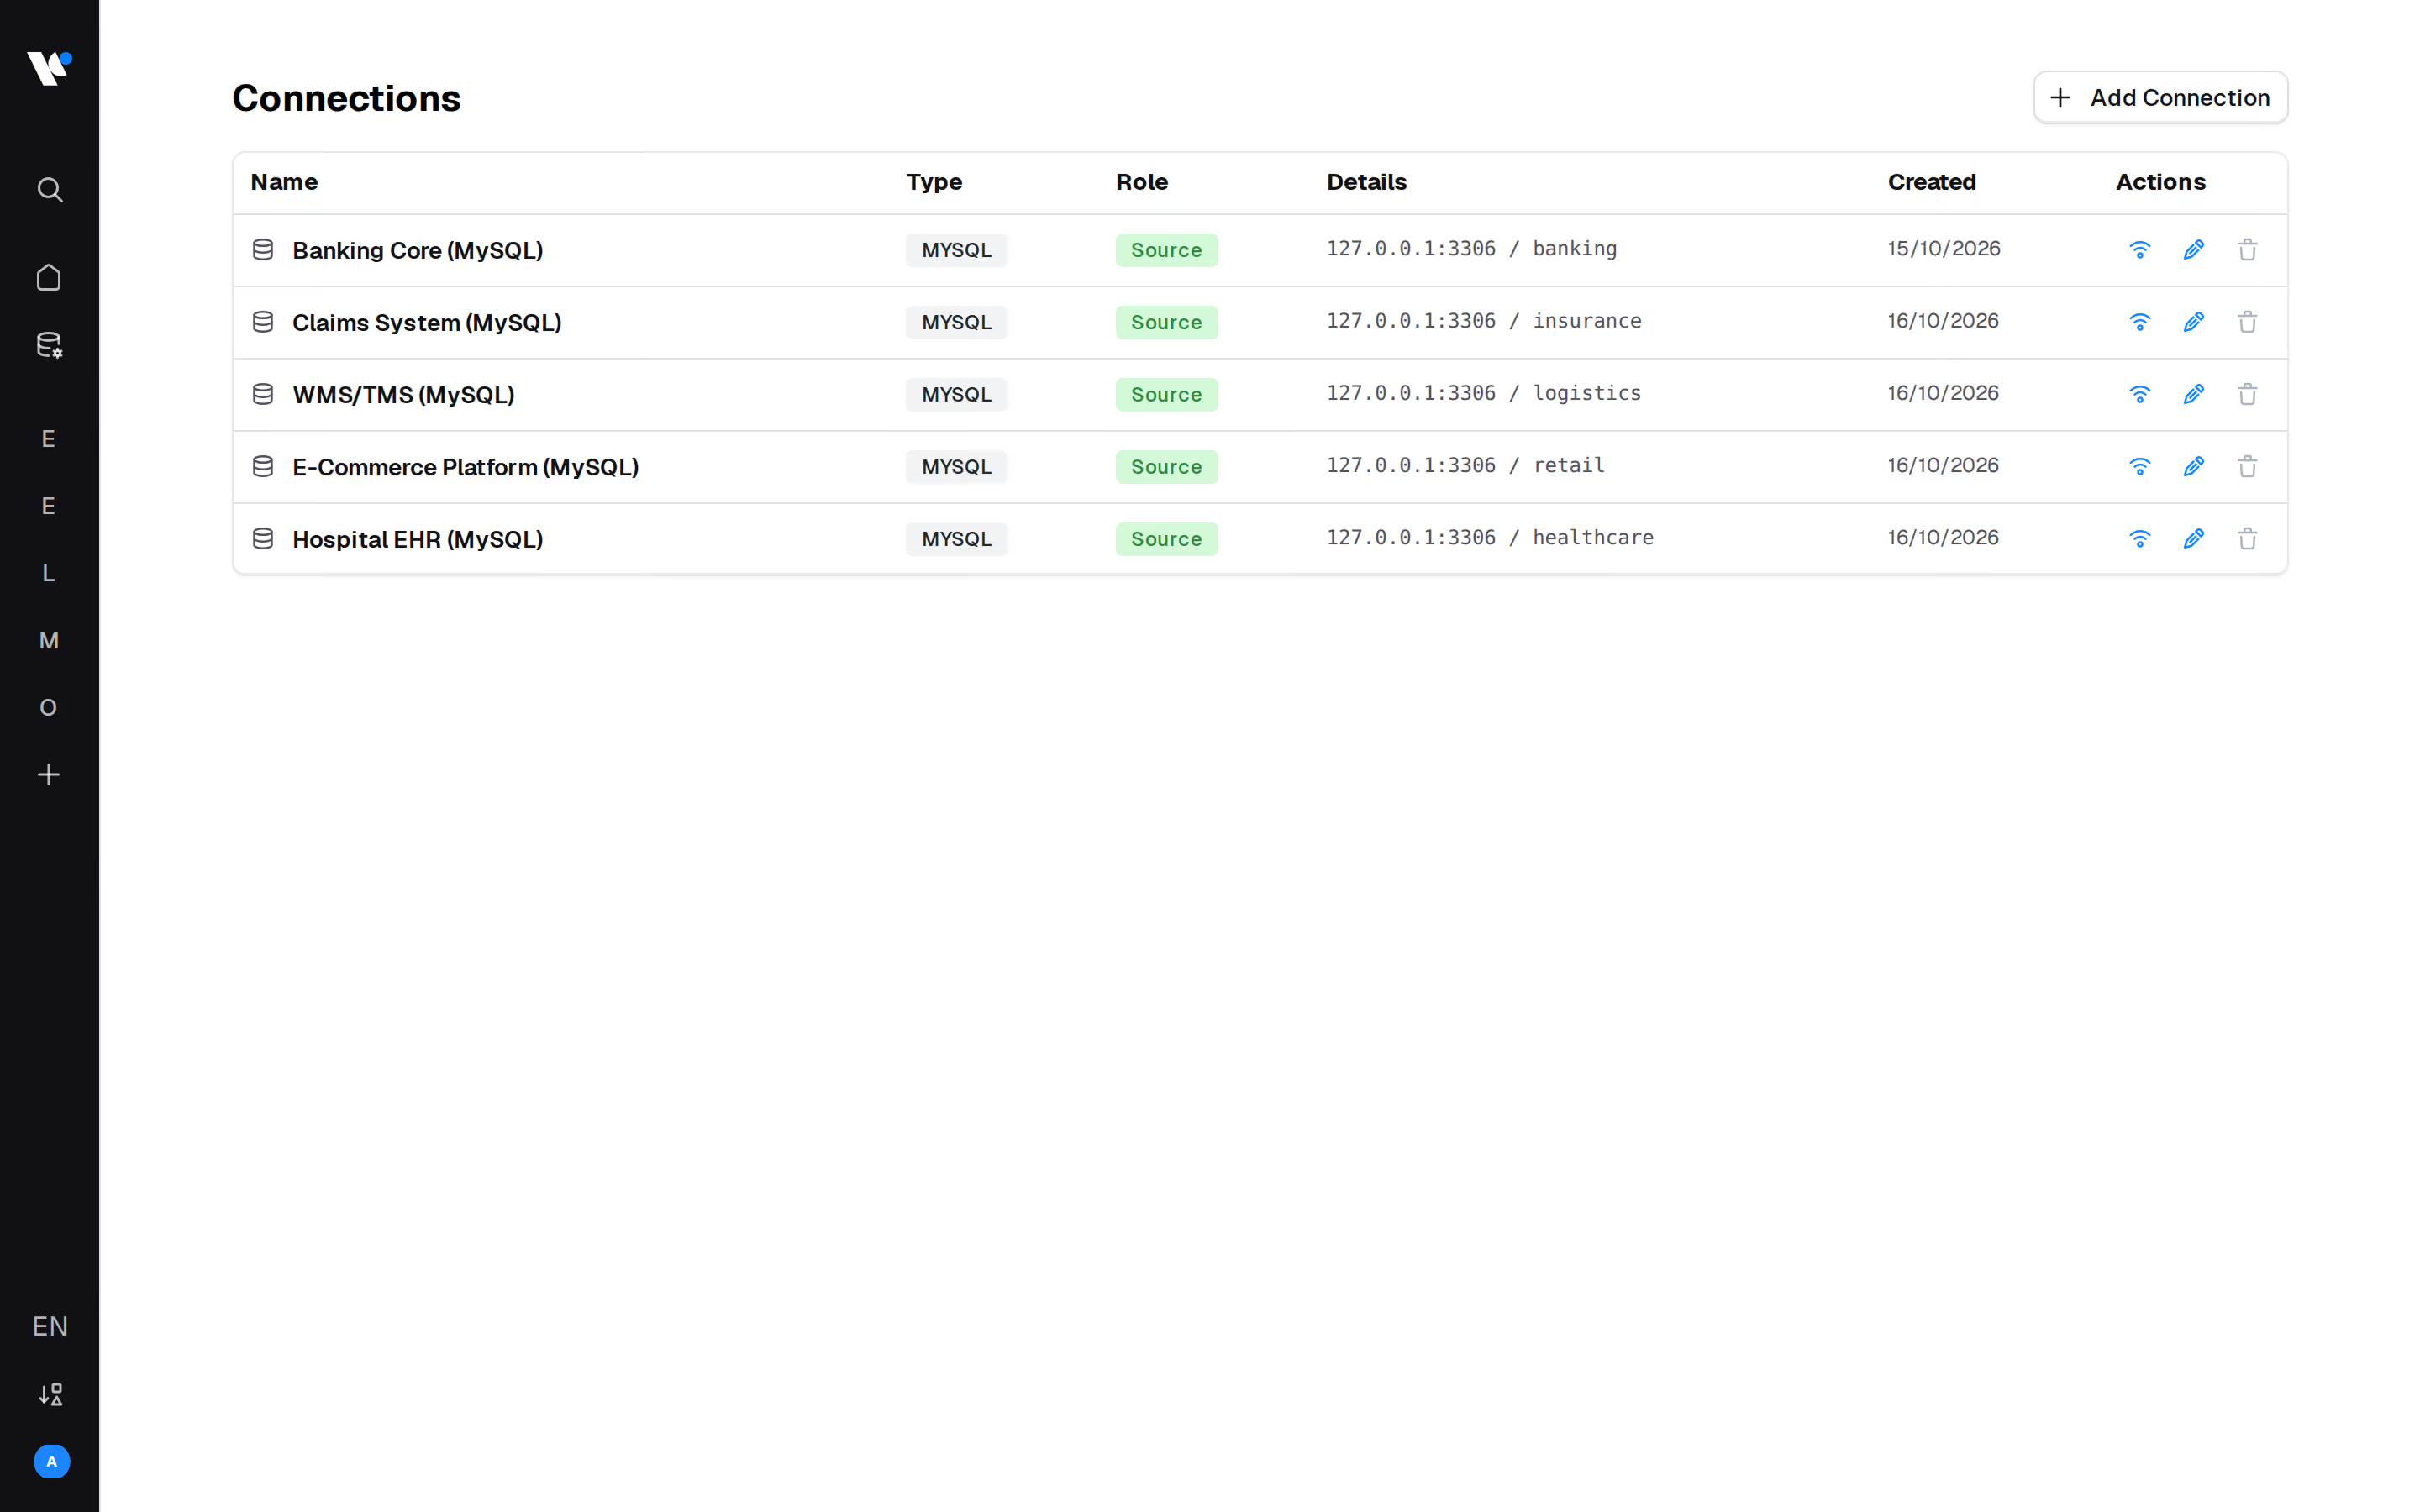
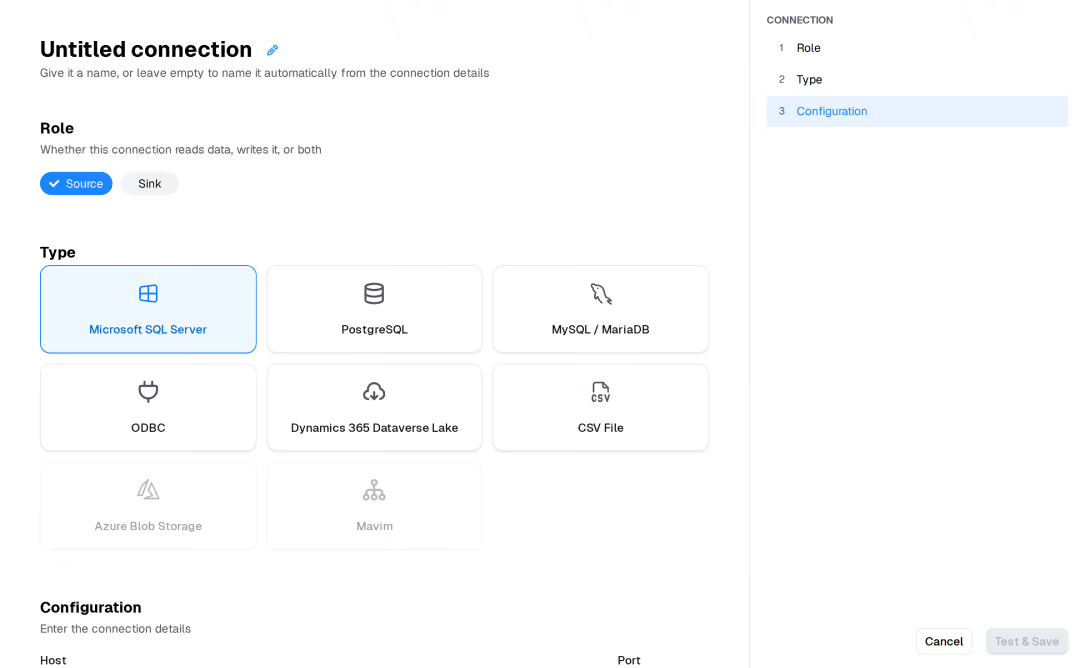
Vue d'ensemble des connexions configurées vers les systèmes sources et cibles dans le Data Preparation Tool
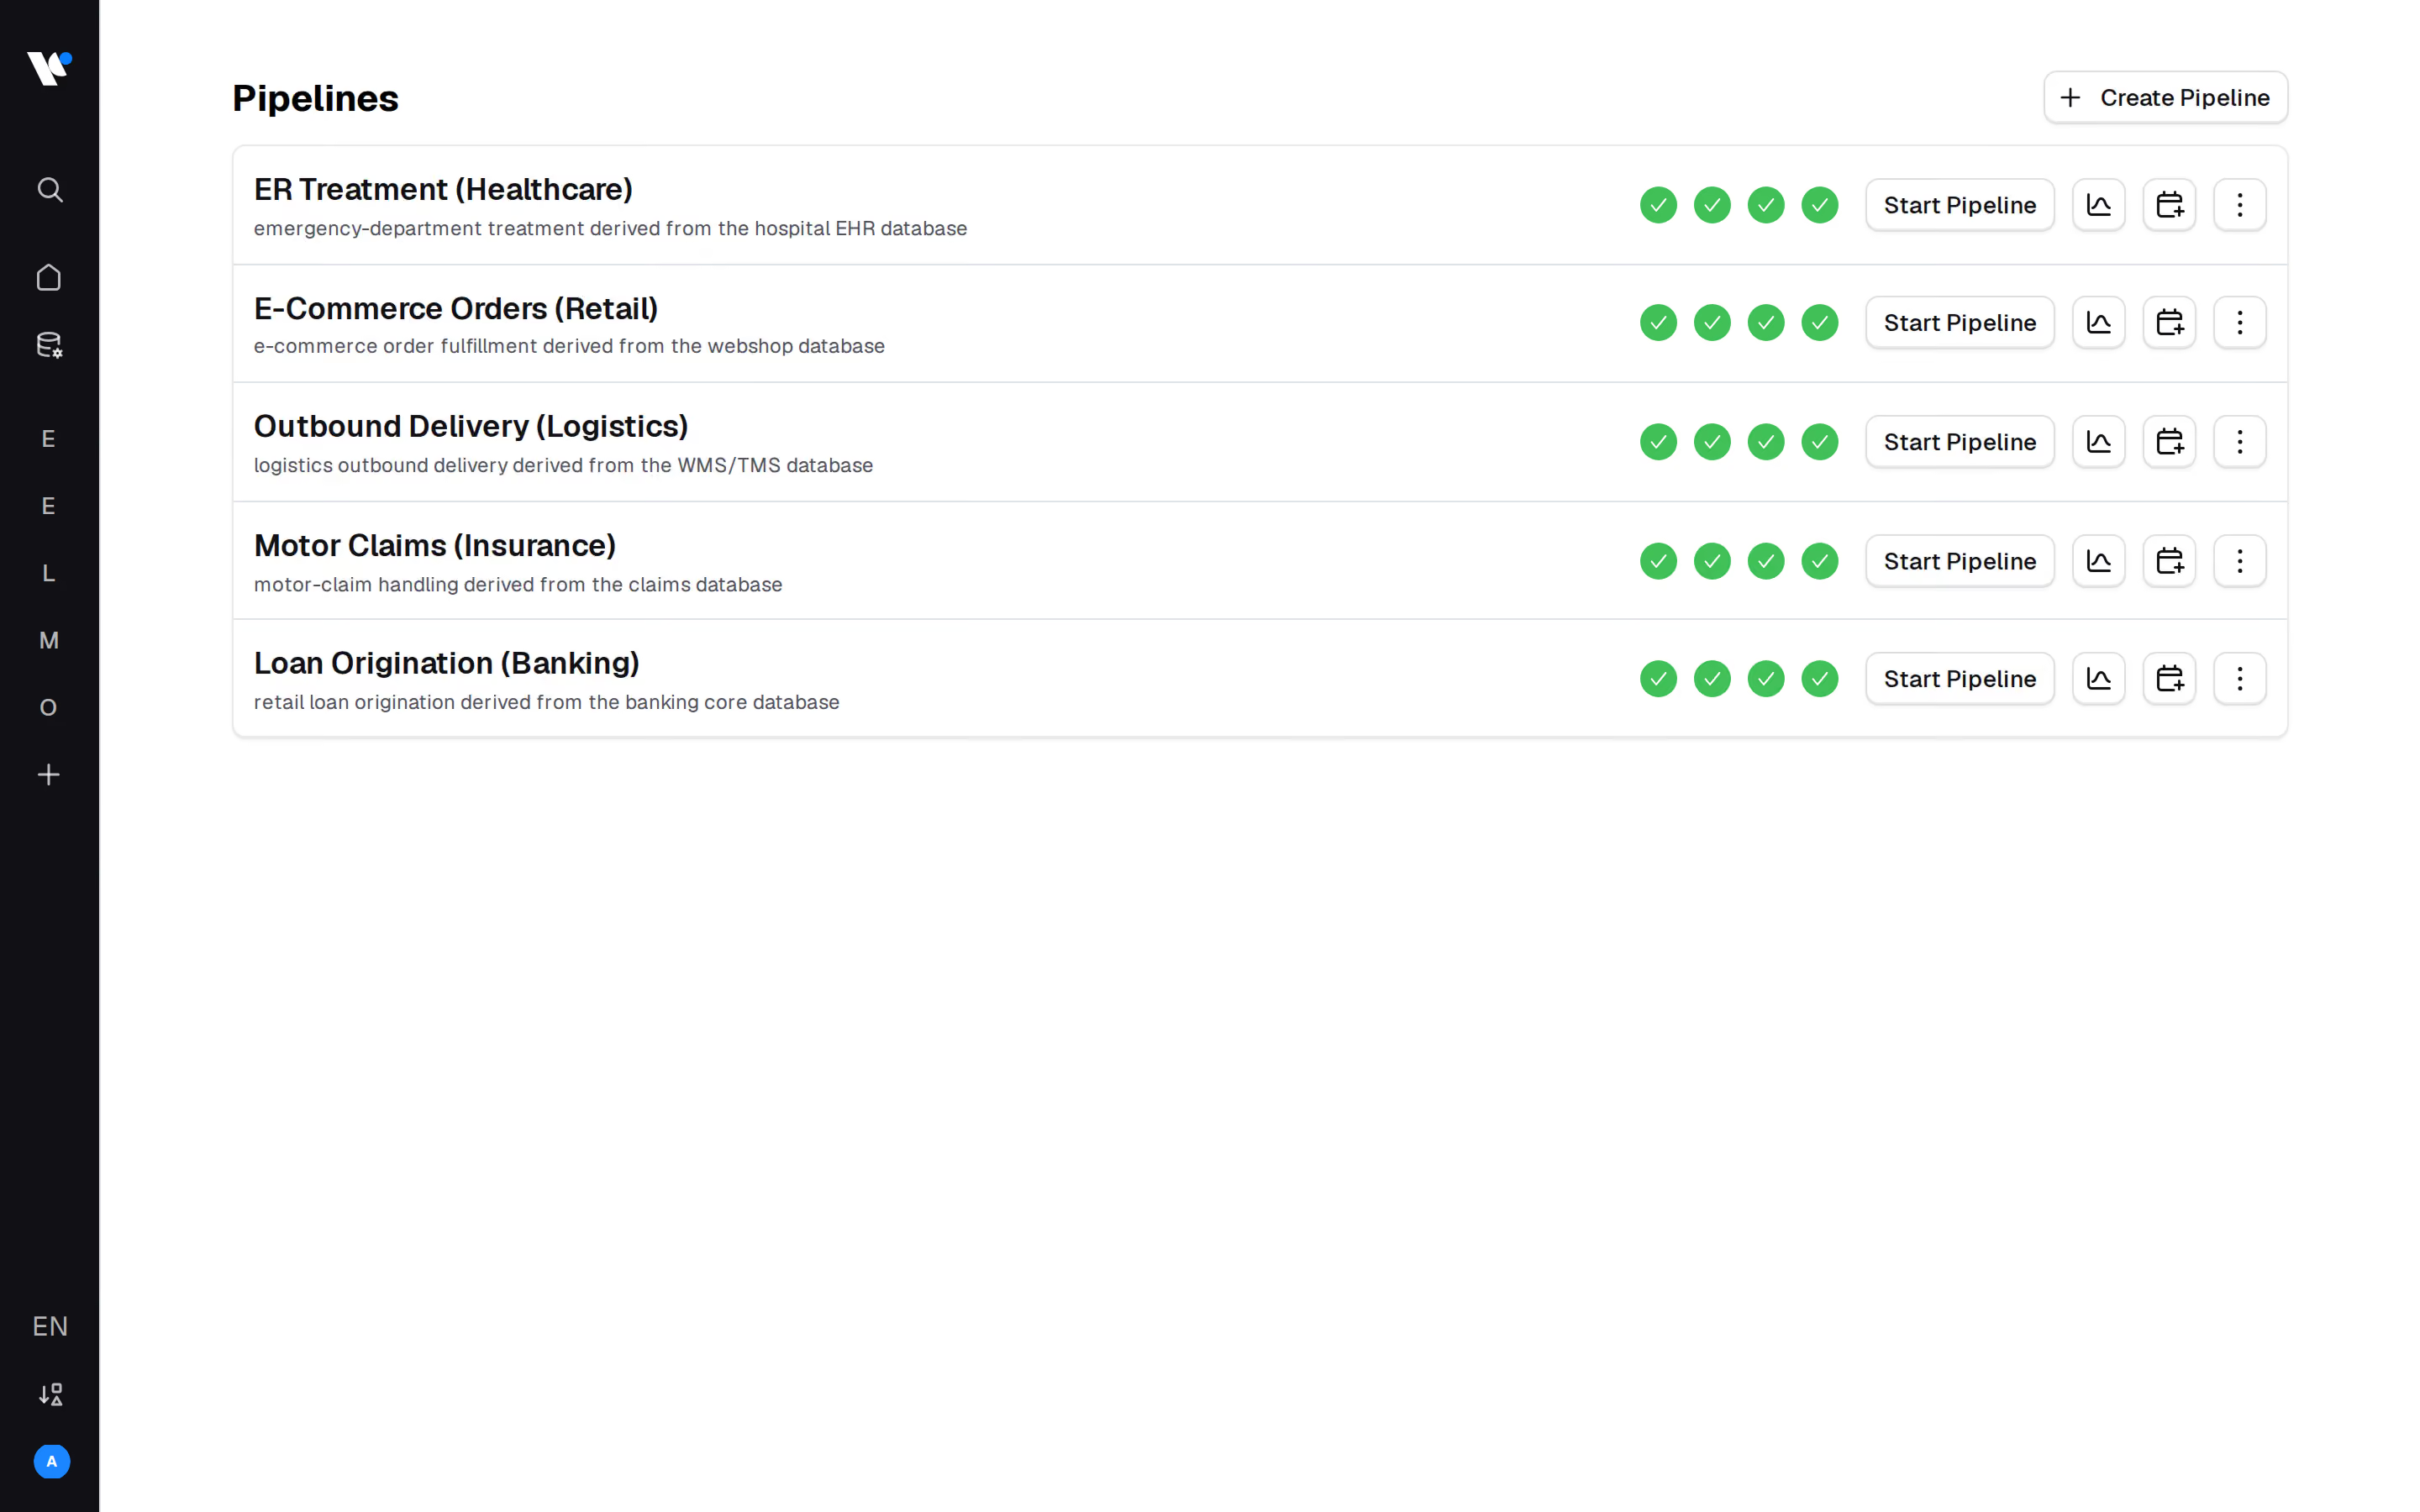
Vue d'ensemble des pipelines configurés dans le Data Preparation Tool
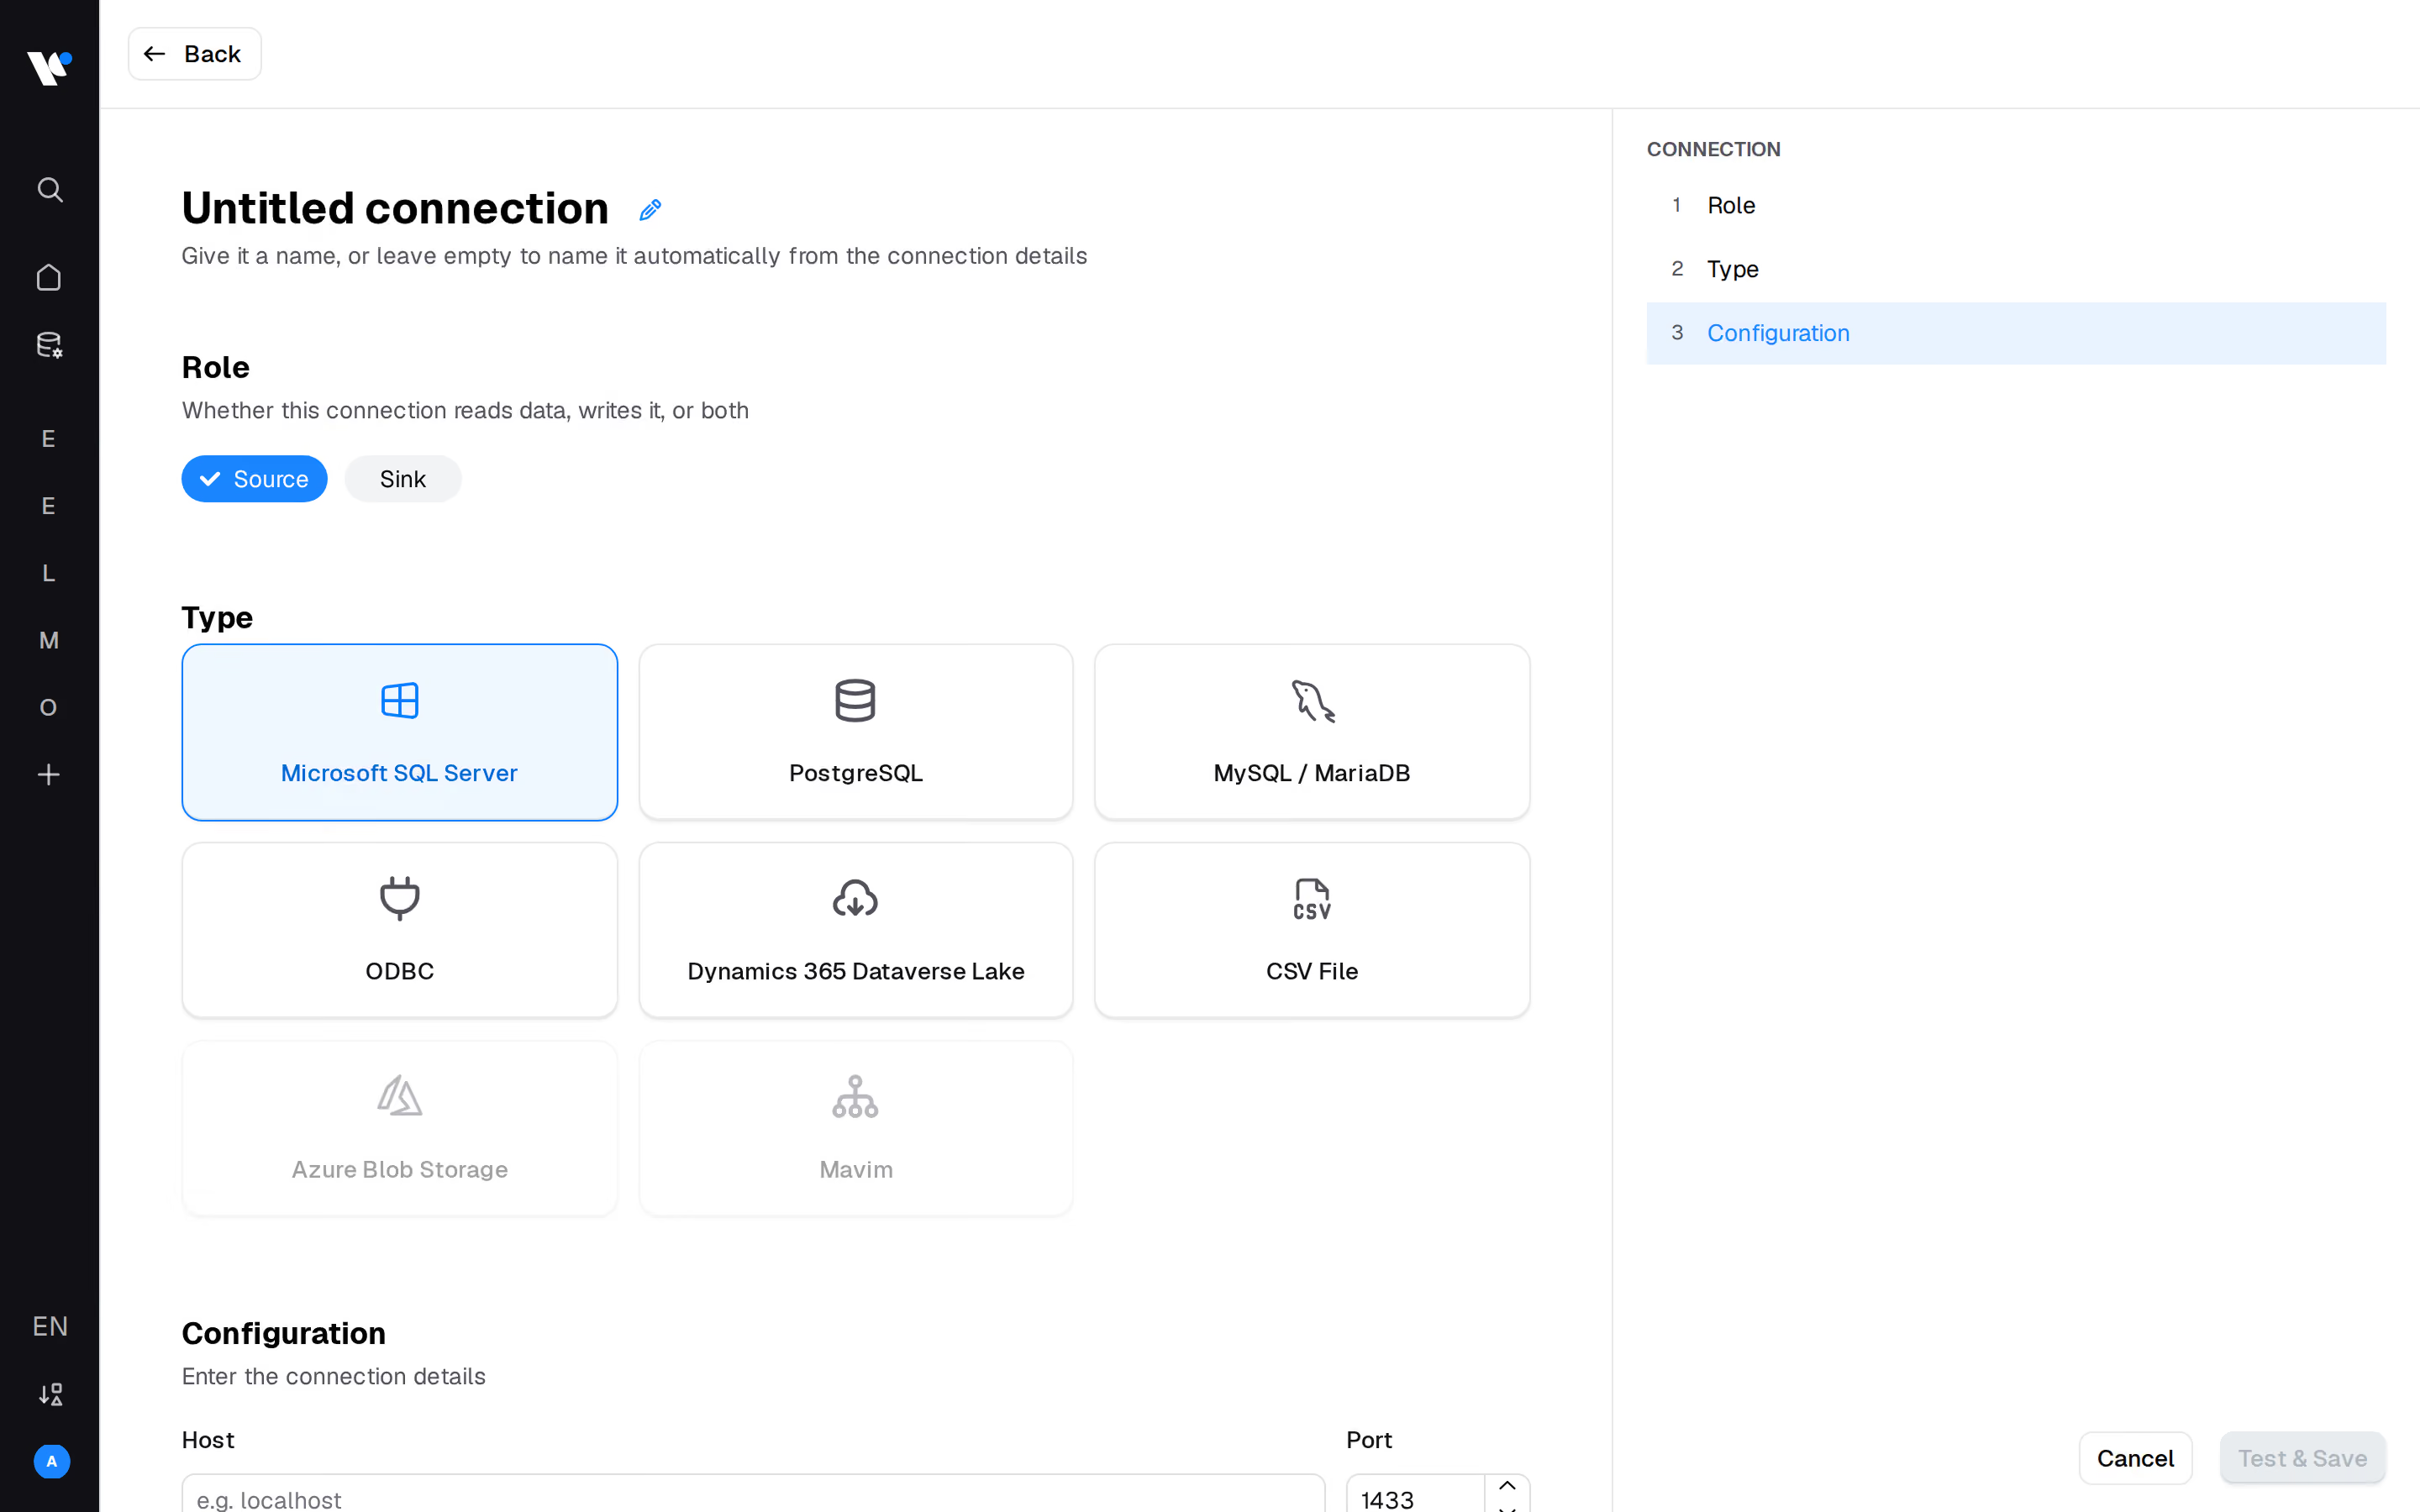
Formulaire de création d'un nouveau pipeline dans le Data Preparation Tool, avec sélection de processus prédéfinis
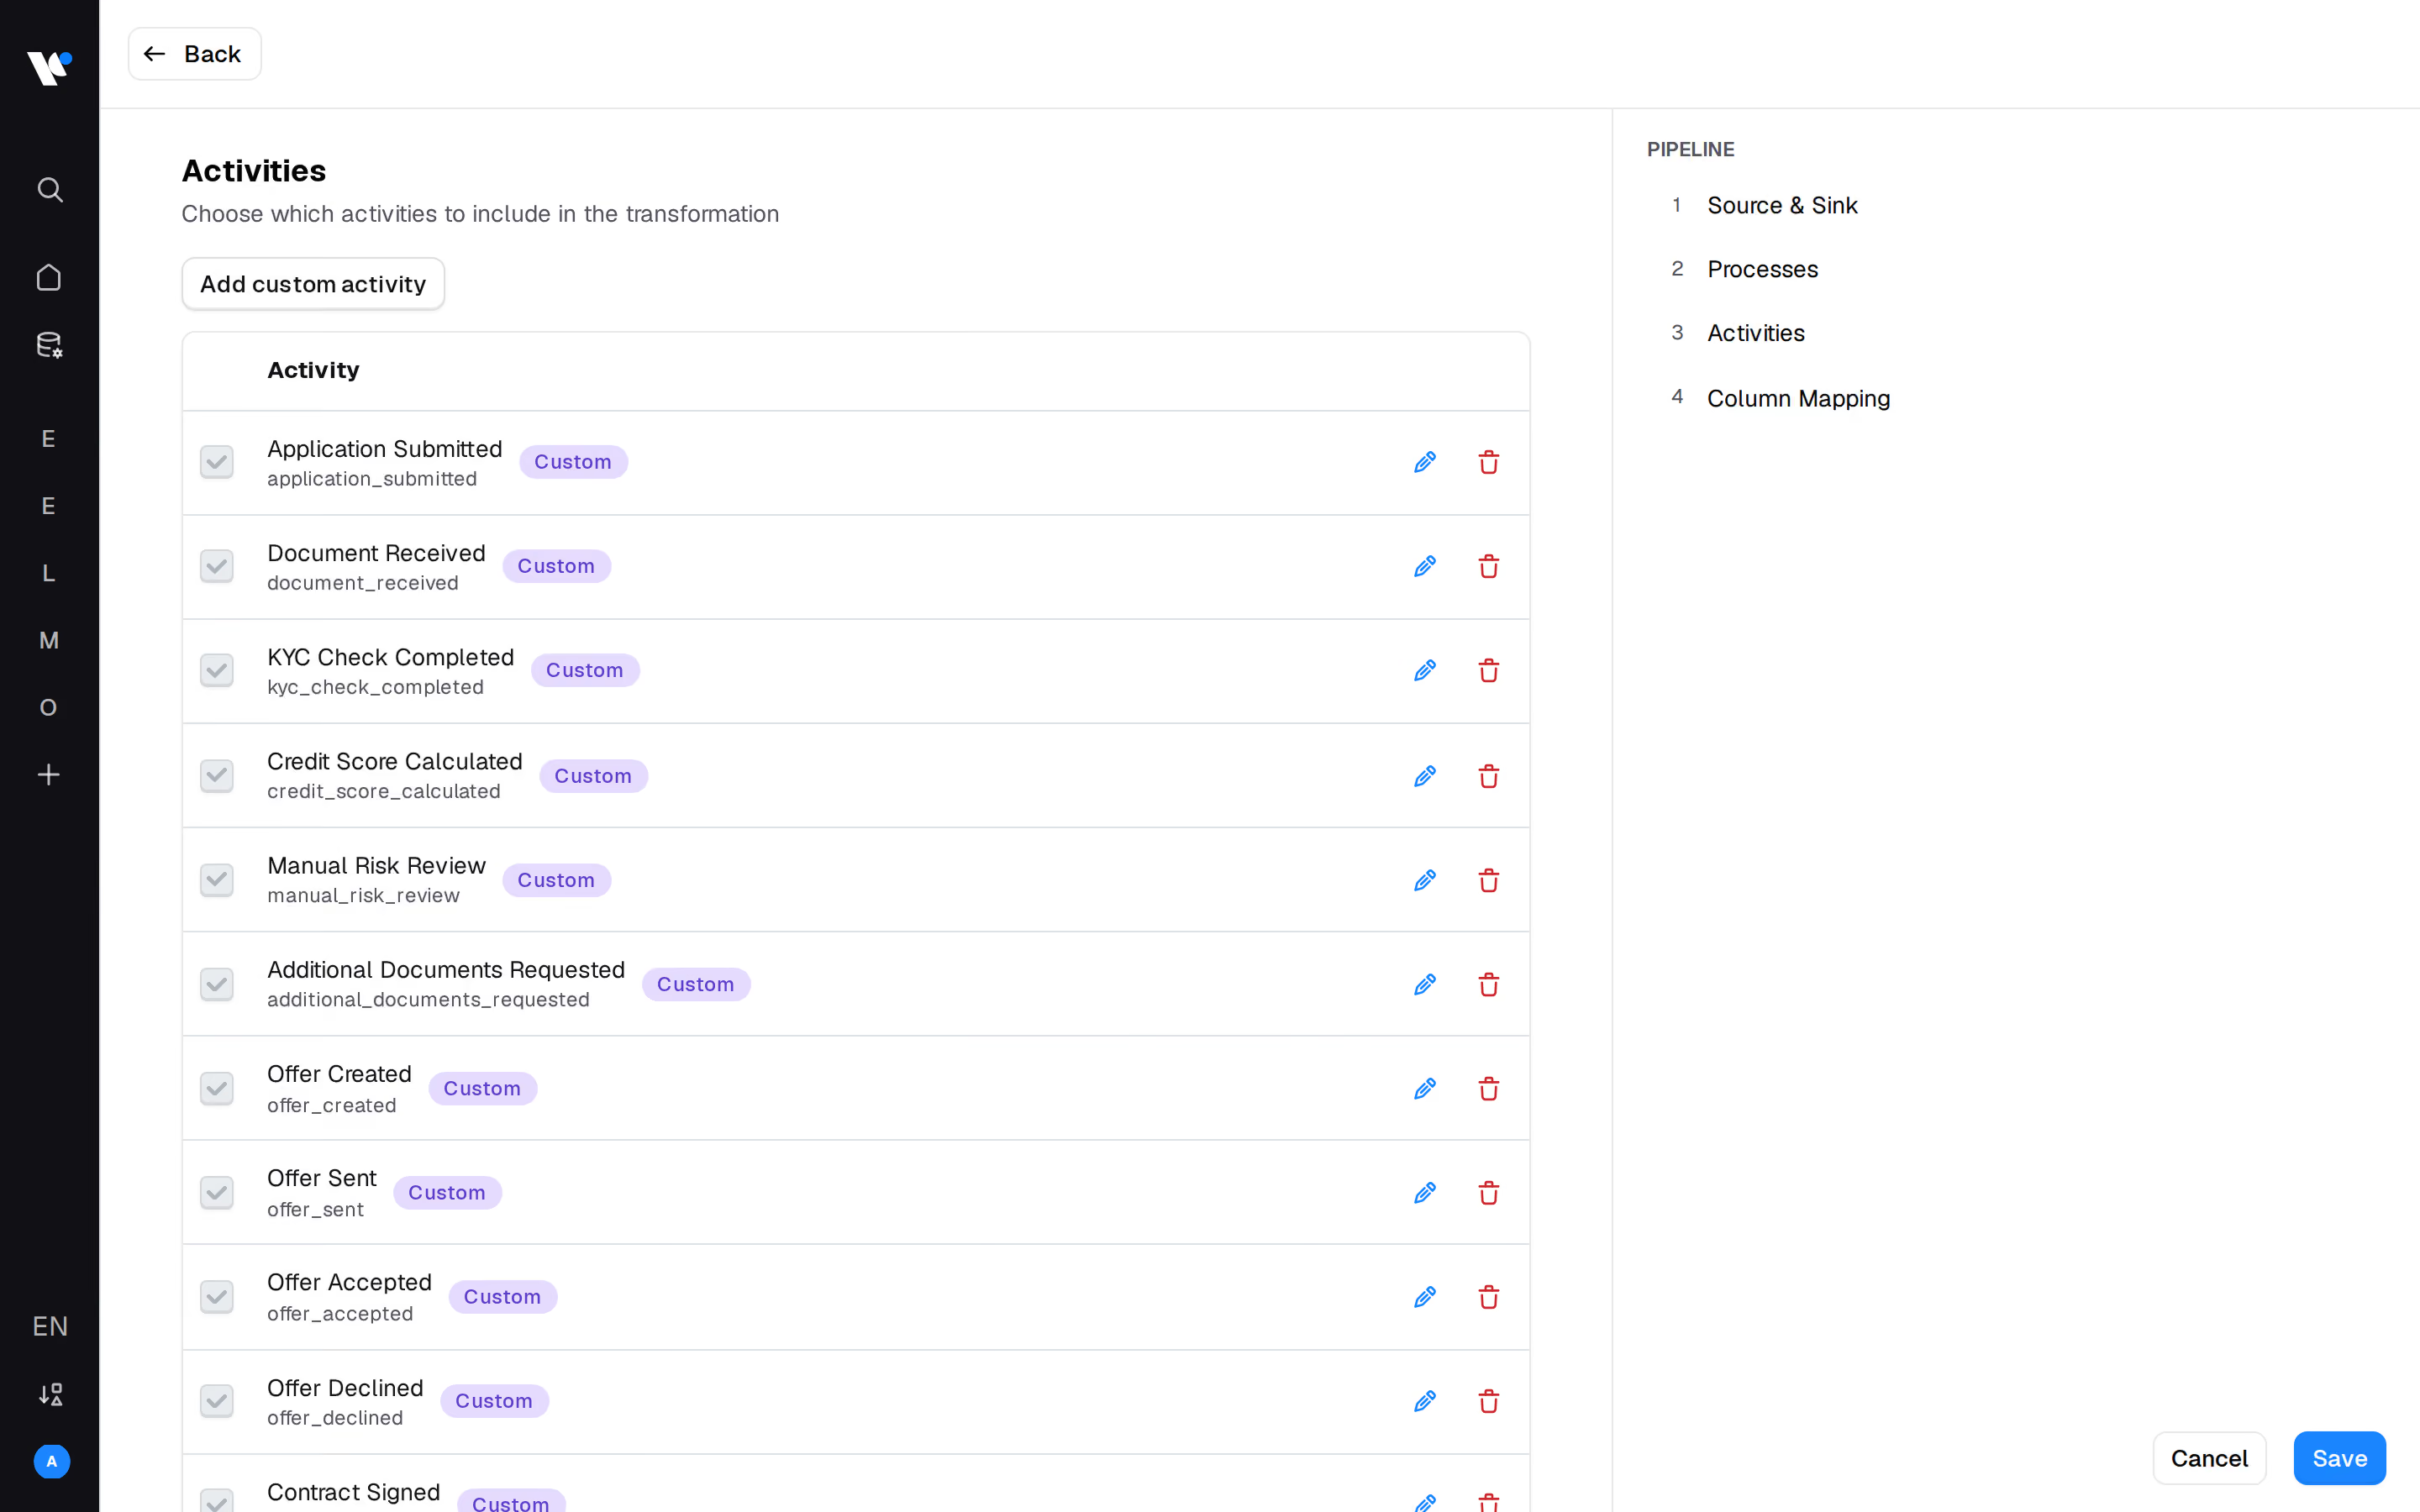
User interface displaying a list of custom activities to include in a transformation, with checkboxes marked for each: Application Submitted, Document Received, KYC Check Completed, Credit Score Calculated, Manual Risk Review, Additional Documents Requested, Offer Created, Offer Sent, Offer Accepted, Offer Declined, and Contract Signed. Each activity has an edit and delete icon. On the right, a pipeline navigation with steps: Source & Sink, Processes, Activities, and Column Mapping. Buttons for Back, Cancel, and Save are visible.

Le problème du 80/20, inversé

Dans la plupart des projets de process mining, l'essentiel de l'effort est consacré à la recherche et à la préparation des données. Grâce aux modèles et à l'enrichissement automatique, ce travail est effectué dès le début du projet, une fois pour toutes.

Le labyrinthe des systèmes, déjà cartographié

Les systèmes ERP, CRM et ITSM contiennent des dizaines de milliers de tables. Nous avons décodé celles qui sont pertinentes pour les processus les plus courants, afin que personne n'ait à chercher quel champ contient l'horodatage.

Bien plus que des cas, des activités et des horodatages

Un journal d'événements brut ne suffit pas. Chaque exécution arrive enrichie de données de référence, de durées, de variantes, de coûts et d'indicateurs d'automatisation, afin que l'analyse puisse commencer immédiatement, sans passer par la modélisation.
La formule Process.Science

Moins d'ingénierie de données,plus d'analyse de processus

Scripts SQL manuels

Fonctionne, jusqu'à ce que le système source change. Difficile à documenter, difficile à transmettre, et une simple mise à jour du schéma peut briser toute la logique.

Suites ETL lourdes

Conçus pour l'entreposage de données, pas pour le process mining. Ils déplacent les données de manière fiable, mais ne savent pas ce qu'est une activité, un cas ou une variante.

Outil de préparation de données Process.Science

Conçu pour une seule mission : transformer les données opérationnelles en journaux d'événements. Il comprend les processus, les enrichit avec des données de référence et fournit la même structure de sortie pour chaque processus et chaque système source.
Prêt pour l'analyse ? Choisissez votre système cible :

Trois étapes des données brutesau journal d'événements final

Connectez votre système, choisissez votre processus, planifiez-le. À partir de là, chaque exécution génère le même journal d'événements complet.

01. Connectez

Choisissez votre système : Microsoft SQL Server ou Azure SQL, PostgreSQL, MySQL ou MariaDB, Microsoft Dynamics 365 ou un simple téléchargement CSV. Saisissez les détails de connexion, testez et enregistrez, puis choisissez la destination des résultats.

02. Choisissez votre processus

Partez d'un modèle prêt à l'emploi comme SAP Purchase-to-Pay et sélectionnez les activités qui vous intéressent. Les modèles identifient déjà les colonnes contenant le cas, l'activité et l'horodatage.

03. Exécutez-le ou planifiez-le

Lancez le pipeline une fois, ou programmez-le de manière horaire, quotidienne, hebdomadaire, mensuelle ou selon votre propre expression cron. Vous pouvez également déclencher une exécution depuis vos propres outils via l'API.
Configuration prête à l'emploi

Des modèles éprouvés, ouverts jusqu'à la dernière ligne de SQL

Ne partez pas de zéro. Nous avons décodé les structures de tables des systèmes les plus utilisés par les entreprises, et chaque modèle reste entièrement modifiable par vos soins.
Prêt pour vos processus clés :SAP P2P, de la demande d'achat à la compensation de facture. SAP O2C, du devis à la facturation et au paiement. Microsoft Dynamics 365 P2P et O2C. Pour SAP P2P, il existe également une variante centrée sur les objets, couvrant les demandes, les commandes, les réceptions de marchandises et les factures, ainsi que leurs relations mutuelles.
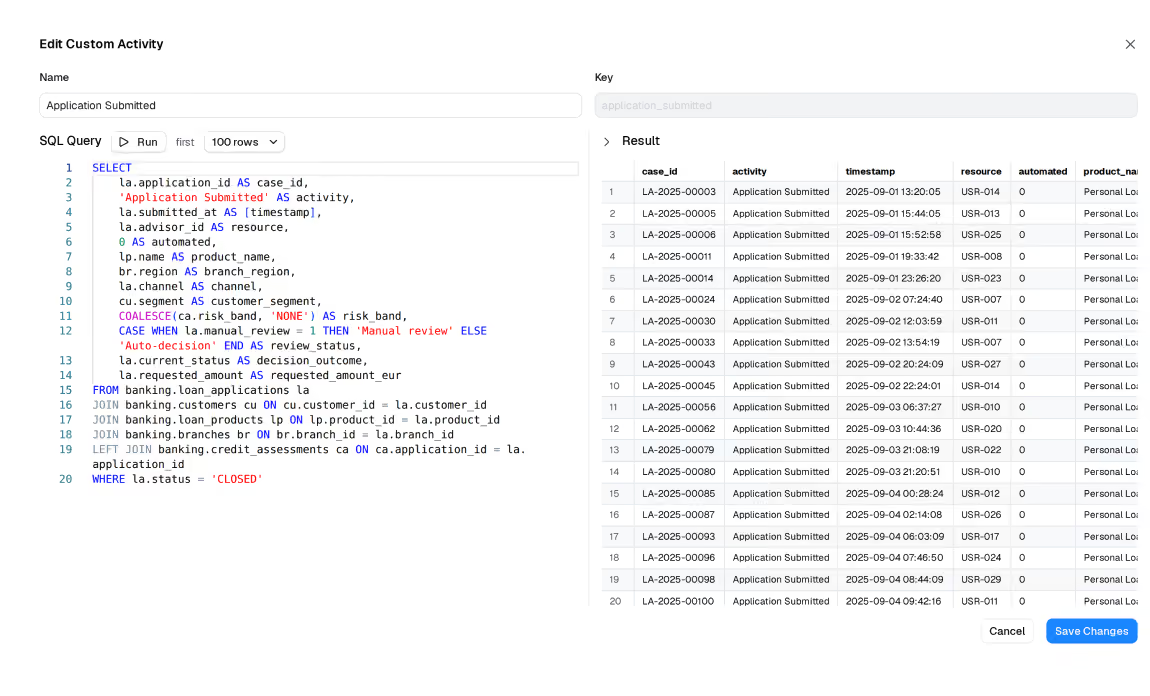
Rien n'est verrouillé :Activez ou désactivez des activités, modifiez le code SQL associé, ajoutez vos propres activités et étapes de préparation, et adaptez tout à votre système grâce aux paramètres. Si votre processus ne figure pas dans le catalogue, créez-le de toutes pièces.
Écrit une fois, exécuté partout :Un modèle est écrit une seule fois et fonctionne sur toutes les bases de données prises en charge, car l'outil traduit le SQL dans le dialecte de chaque système.
Catalogue de modèles du Data Preparation Tool avec des processus prêts à l'emploi pour SAP Purchase-to-Pay et Dynamics 365
Journal d'événements enrichi issu du Data Preparation Tool, avec cas, activité et horodatage ainsi que durée de traitement, variante et coûts
Ce que vous obtenez

Un journal d'événements prêt à l'analyse

Un journal d'événements classique comporte trois colonnes : cas, activité, horodatage. C'est là que le nôtre commence.
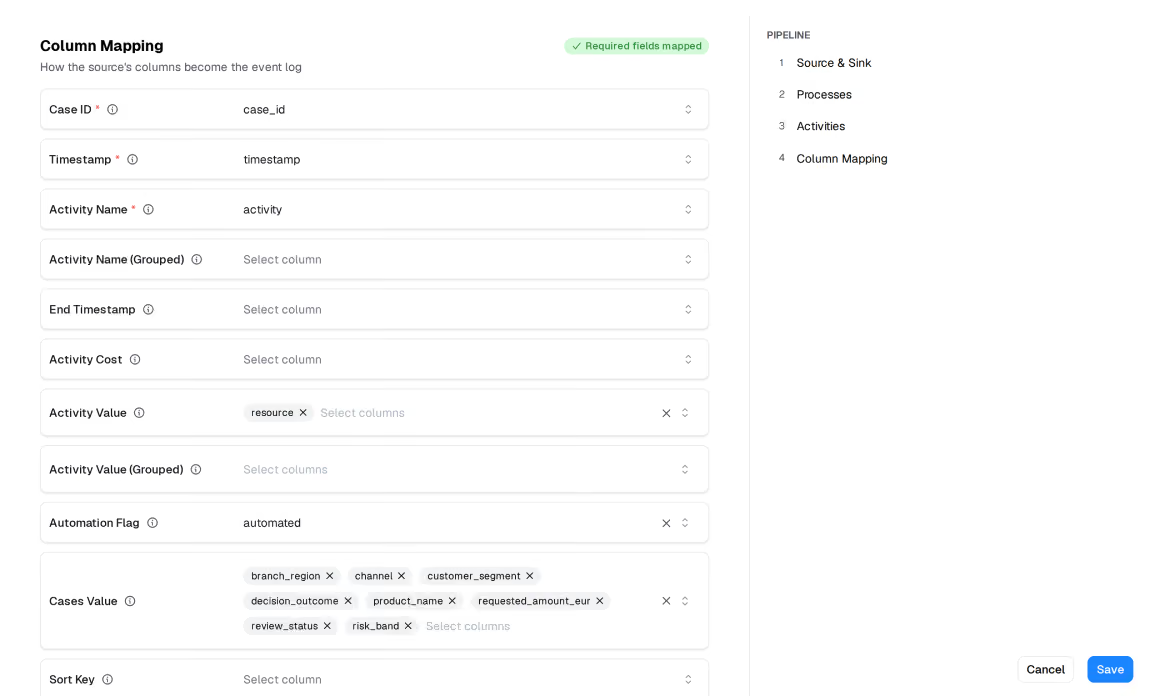
Enrichi, pas brut :Chaque cas est accompagné de son temps de traitement, de sa variante, de ses boucles, de son coût et de son taux d'automatisation. Chaque étape indique sa durée, son temps d'attente et son indicateur de retravail. Les attributs du cas, tels que le fournisseur, l'usine ou les conditions de paiement, sont inclus et les filtres de variantes sont calculés à l'avance.
Deux niveaux de zoom, deux langues :Passez de la vue détaillée (« Enregistrer la réception de marchandises ») à la vue de gestion (« Réception de marchandises et factures »).
Une structure pour chaque processus :Qu'il s'agisse de Purchase-to-Pay, d'Order-to-Cash ou de votre propre processus, depuis SAP, Dynamics ou toute autre base de données : les tables de sortie conservent toujours la même structure. Les rapports et tableaux de bord fonctionnent pour l'ensemble de vos processus sans nécessiter de retouches par projet.
Assurance qualité automatisée

Rien d'inachevé n'atteint jamais vos rapports

Les données erronées ne se signalent pas, elles faussent simplement votre tableau de bord. L'outil de préparation de données agit comme un gardien en amont de votre analyse.
Complet ou rien du tout :Un nouveau journal d'événements n'est mis en ligne qu'une fois complet, en un seul clic. Votre analyse ne lit jamais un journal incomplet et une exécution échouée laisse la version précédente intacte. Les tables obsolètes sont supprimées automatiquement.
Robuste par conception :Si une activité échoue, vous recevez un avertissement tout en conservant le reste des données, au lieu de perdre l'intégralité de l'exécution.
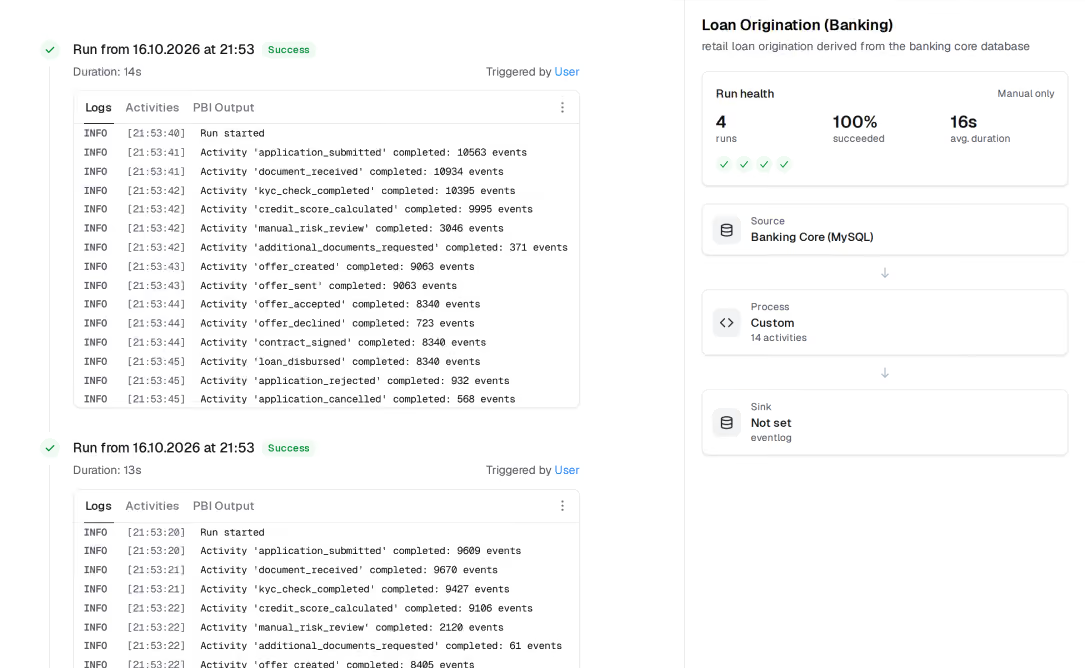
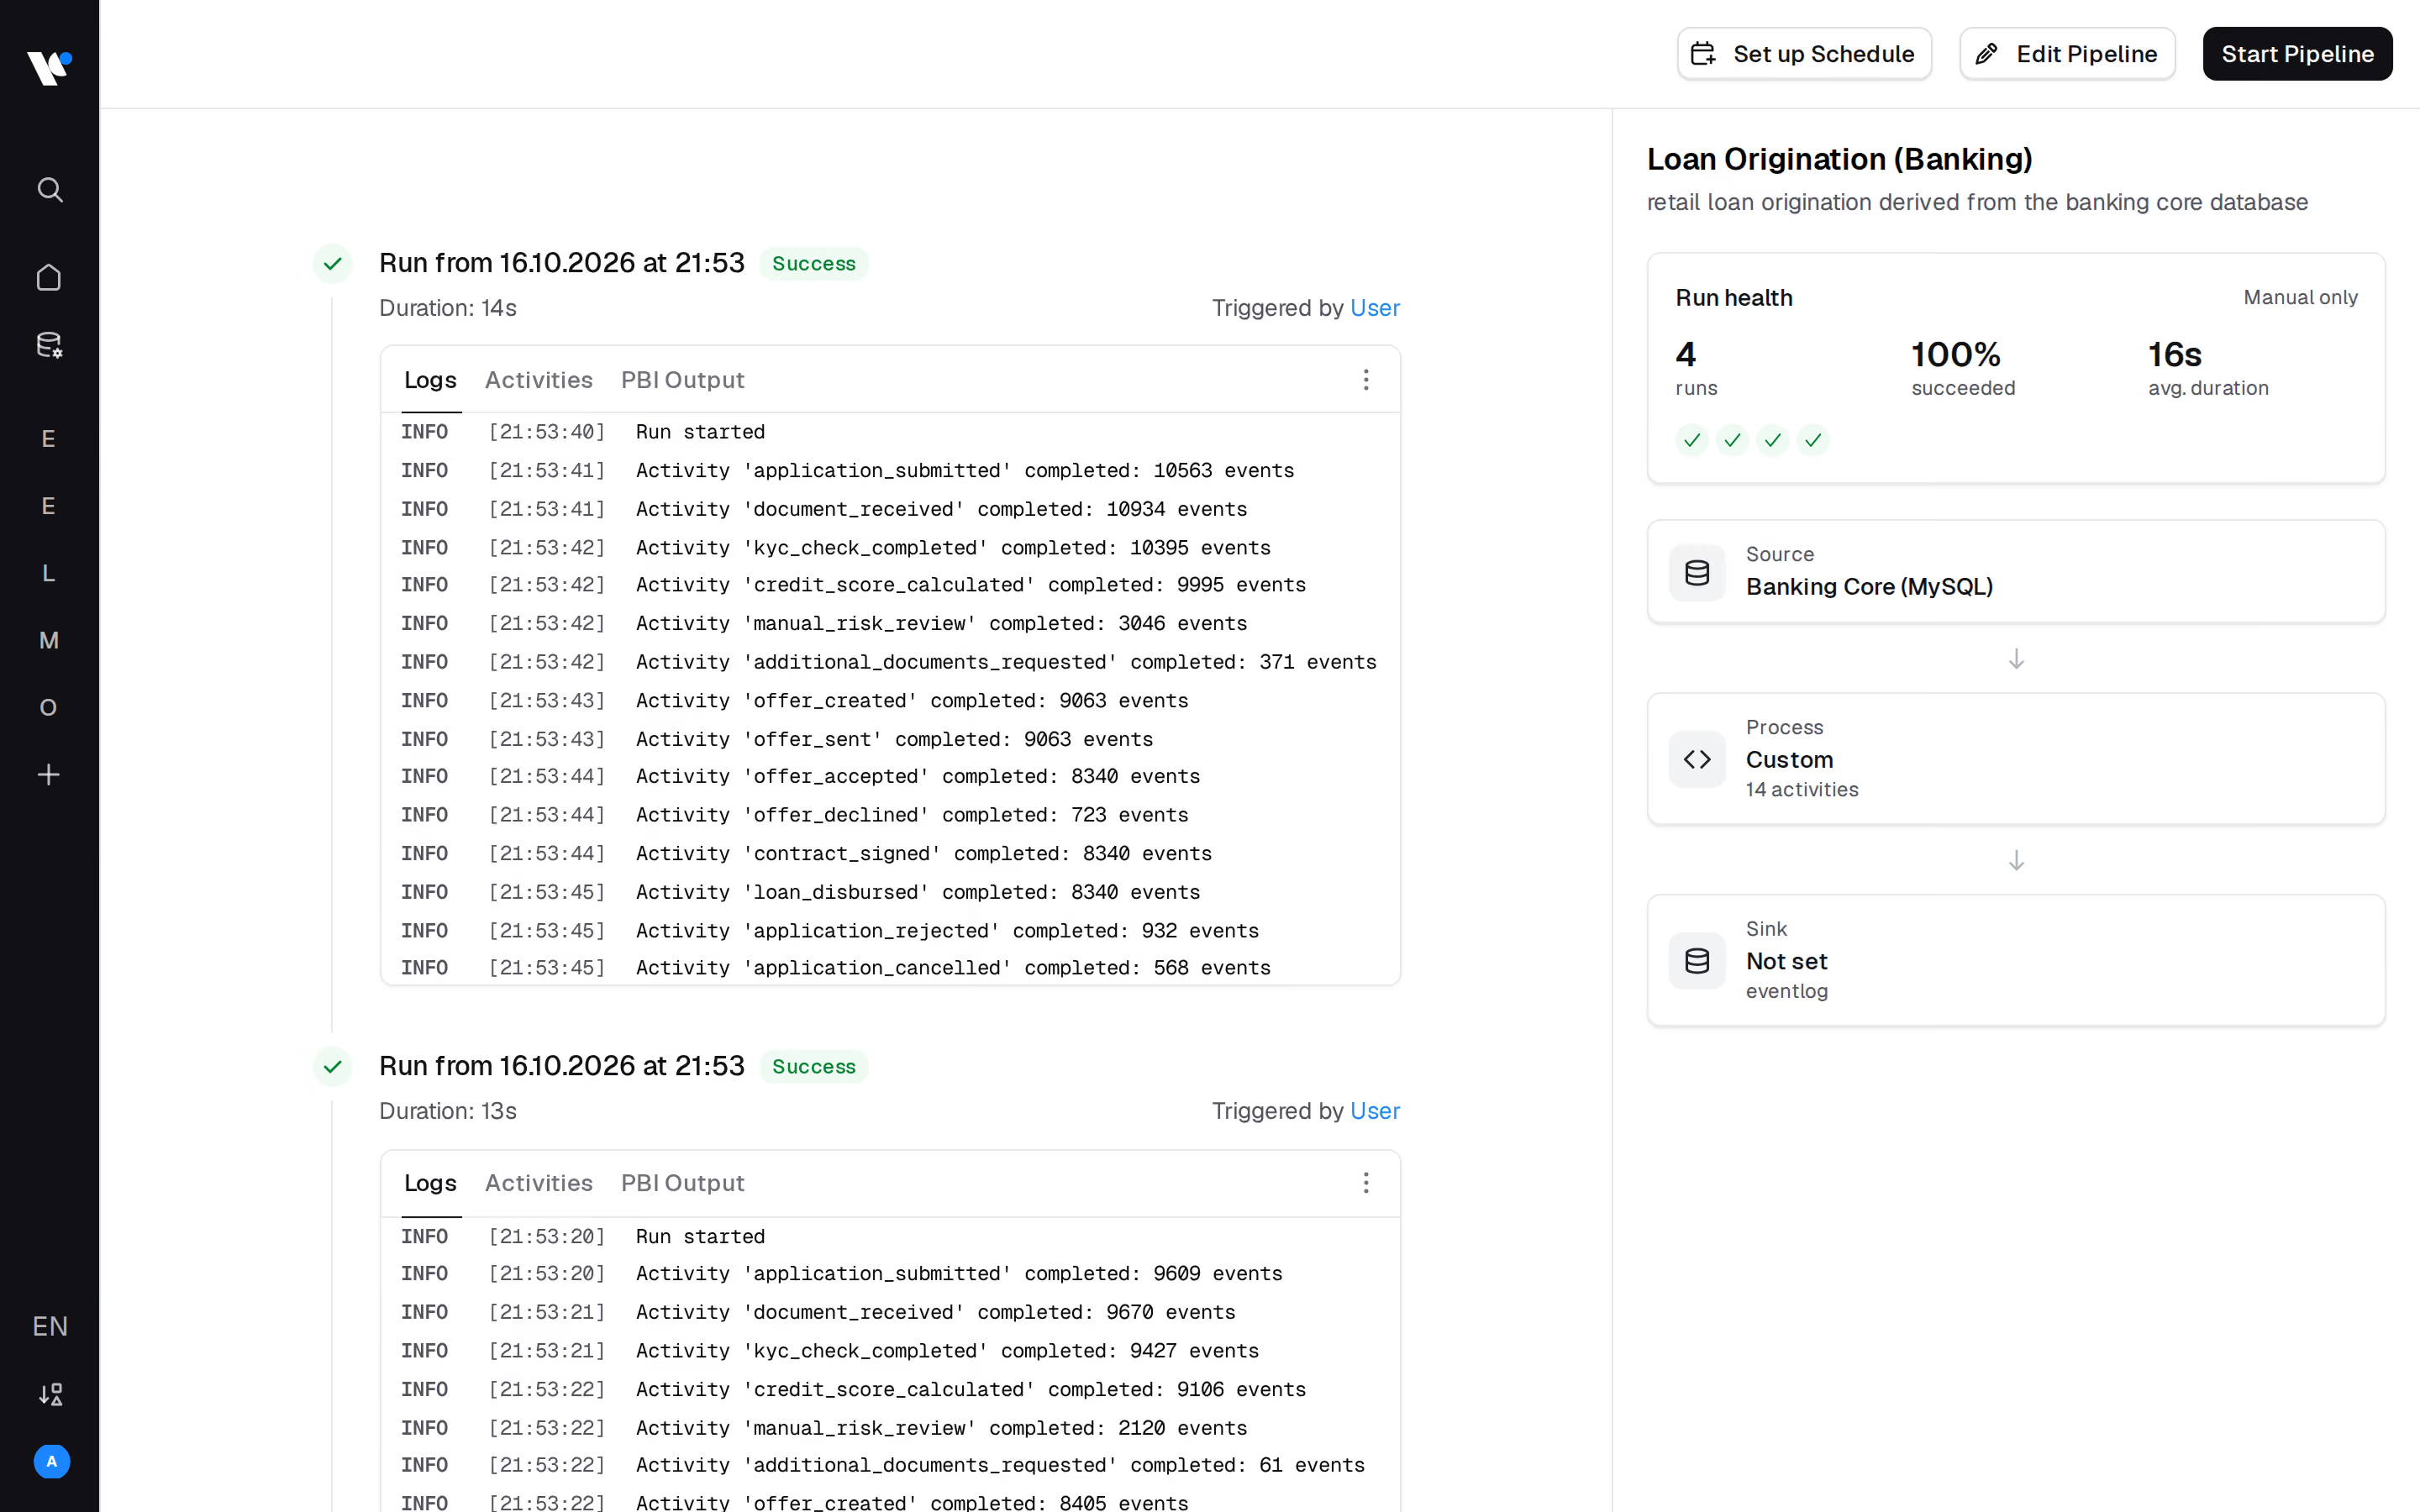
Chaque exécution est traçable :Historique complet des exécutions et journaux, avec le nombre d'événements et les durées par activité, pour que vous puissiez voir ce qu'une exécution a produit et ce qui a changé depuis la précédente.
Contrôle qualité dans le Data Preparation Tool validant un journal d'événements avant sa mise en service
Historique des exécutions dans le Data Preparation Tool avec le nombre d'événements et la durée par activité
Intégré à chaque exécution

Chaque journal d'événements est accompagné d'une première analyse

Pendant que l'outil prépare vos données, il détecte déjà les cas qui se comportent différemment. Il les signale et identifie les facteurs qu'ils ont en commun.
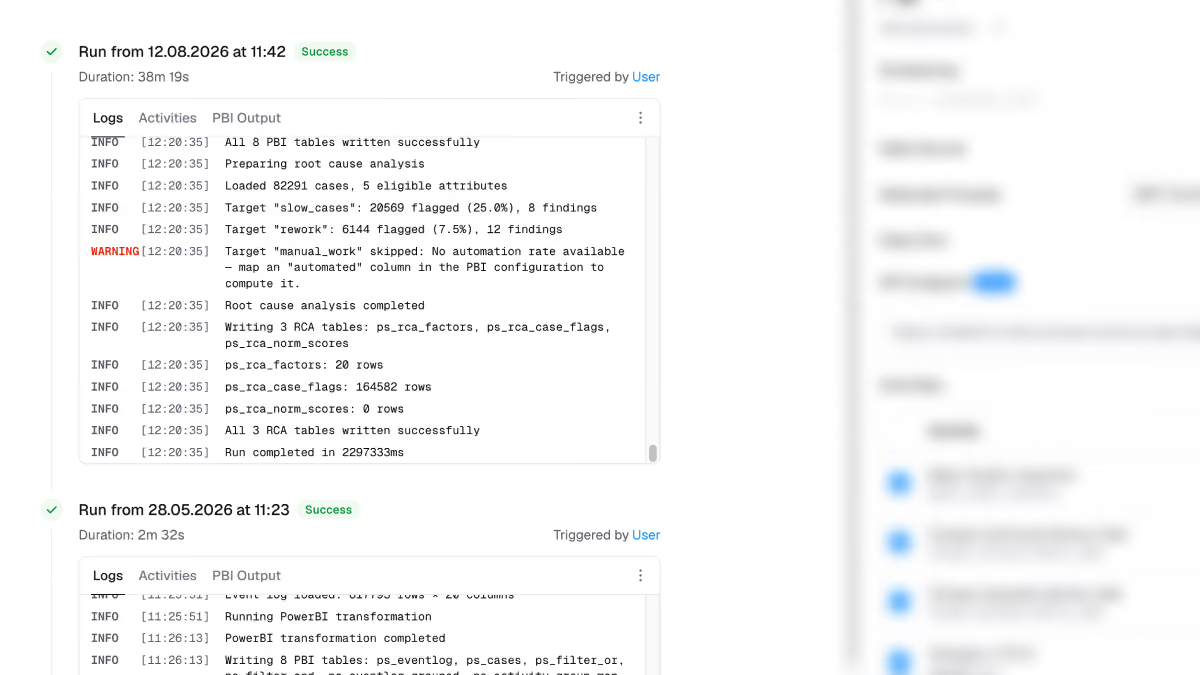
Cas problématiques, signalés automatiquement :Cas lents dépassant votre objectif ou appartenant au quartile le plus lent, cas contenant des boucles de retravail, cas à faible taux d'automatisation et violations des normes de processus selon cinq types de règles, avec une norme par défaut incluse pour le cycle SAP Purchase-to-Pay.
Facteurs d'influence, pas de suppositions :L'outil analyse chaque attribut de cas et classe les éléments saillants parmi les cas problématiques, en tenant compte de l'ampleur de l'effet, du nombre de cas et de la signification statistique. Par exemple : les cas impliquant un fournisseur spécifique manquent leur objectif de débit 3,2 fois plus souvent que les autres.
Vers quoi cela mène :Les résultats apparaissent à côté de vos tables Power BI et dans Process.Science Intelligence. Vous pouvez alors les suivre dans le graphe de processus, comparer les populations et conserver les informations pertinentes étayées par des preuves.
Et ensuite ?

Décrivez votre processus et laissez l'outil le trouver

Nous appliquons l'expertise en reconnaissance de formes de notre IoT Miner à la préparation de données. Décrivez en une phrase le sujet de vos données, par exemple « approvisionnement, de la demande d'achat au paiement de la facture », et l'outil vous proposera des processus candidats basés sur les activités réelles issues de vos propres tables.
Vérifié par vos données, sans devinettes :Chaque activité proposée est vérifiée par rapport à la réalité du terrain. Les tables et les colonnes existent-elles, y a-t-il suffisamment de lignes correspondantes, les horodatages semblent-ils réels, l'activité partage-t-elle des identifiants de cas avec le reste du processus ?
Il ne pose de questions qu'en cas de doute :Chaque activité comporte un score de confiance basé sur plusieurs signaux, et vous affinez le résultat lors d'une conversation avant de le transformer en pipeline exécutable.
Il apprend de vos experts :Ce que votre équipe confirme est mémorisé, afin que la découverte suivante sur le même système parte d'une meilleure base.
Découverte automatique de processus dans le Data Preparation Tool, proposant des activités issues de vos propres tables de base de données
Connexions

Lisez depuis vos systèmes,
réécrivez là où vous travaillez

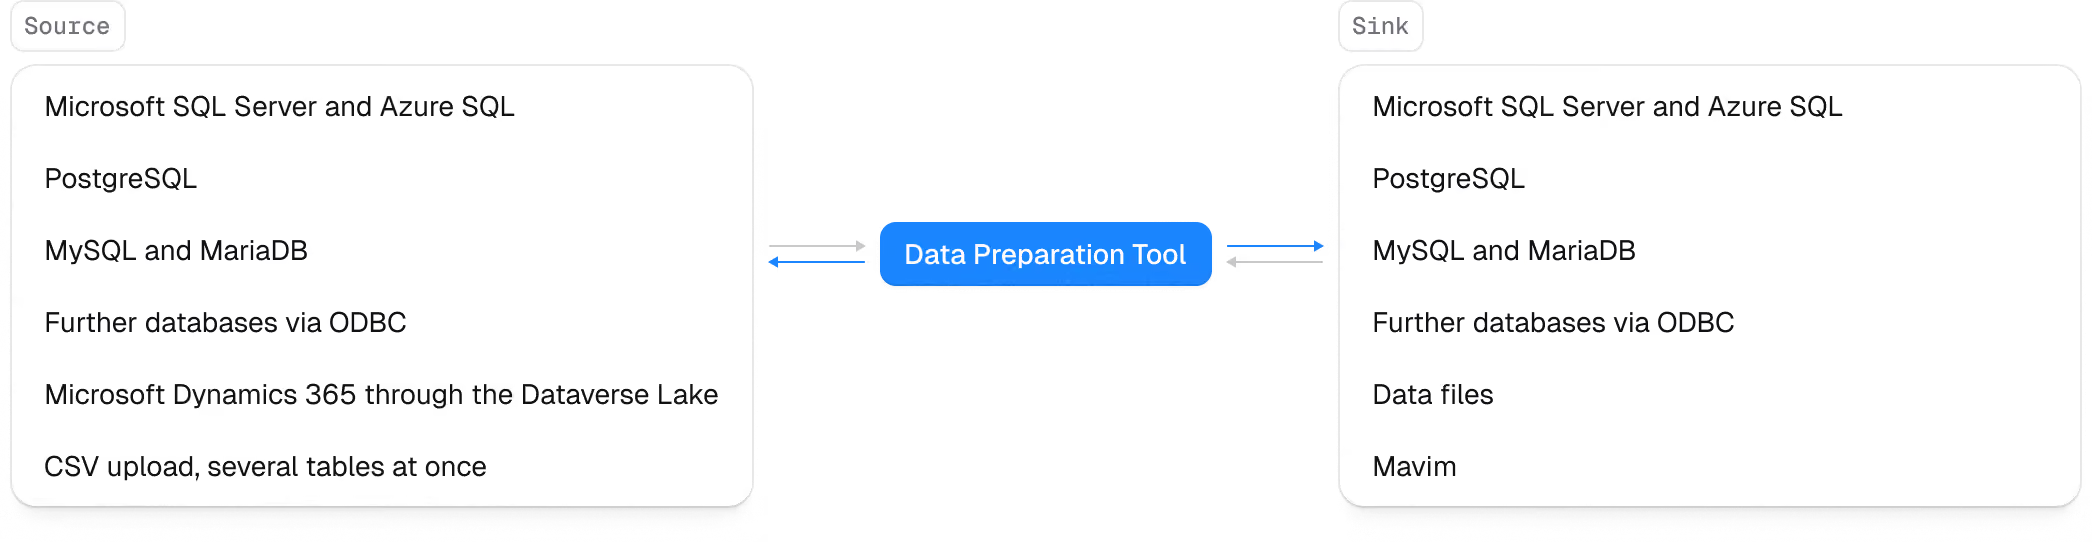
Une source est l'endroit où l'outil lit les données, une destination est l'endroit où il les écrit. Chaque connexion à une base de données fonctionne dans les deux sens.
Schéma des connexions du Data Preparation Tool vers les systèmes sources et cibles : bases de données, Dynamics 365, Power BI et Process.Science Intelligence
Il vous manque quelque chose ?
La configuration idéale

Conçu pour votrePower BIetIntelligence

L'outil de préparation des données est le moteur de votre process mining. Les journaux d'événements qu'il génère alimentent directement le système que vous utilisez, sans étape de modélisation intermédiaire.

Intégration Power BI

Les tables de sortie présentent la structure attendue par nos modèles de rapports Power BI. Votre journal d'événements est intégré directement dans votre propre modèle, aux côtés de vos dimensions existantes, et les tableaux de bord fonctionnent sans retouche projet par projet.
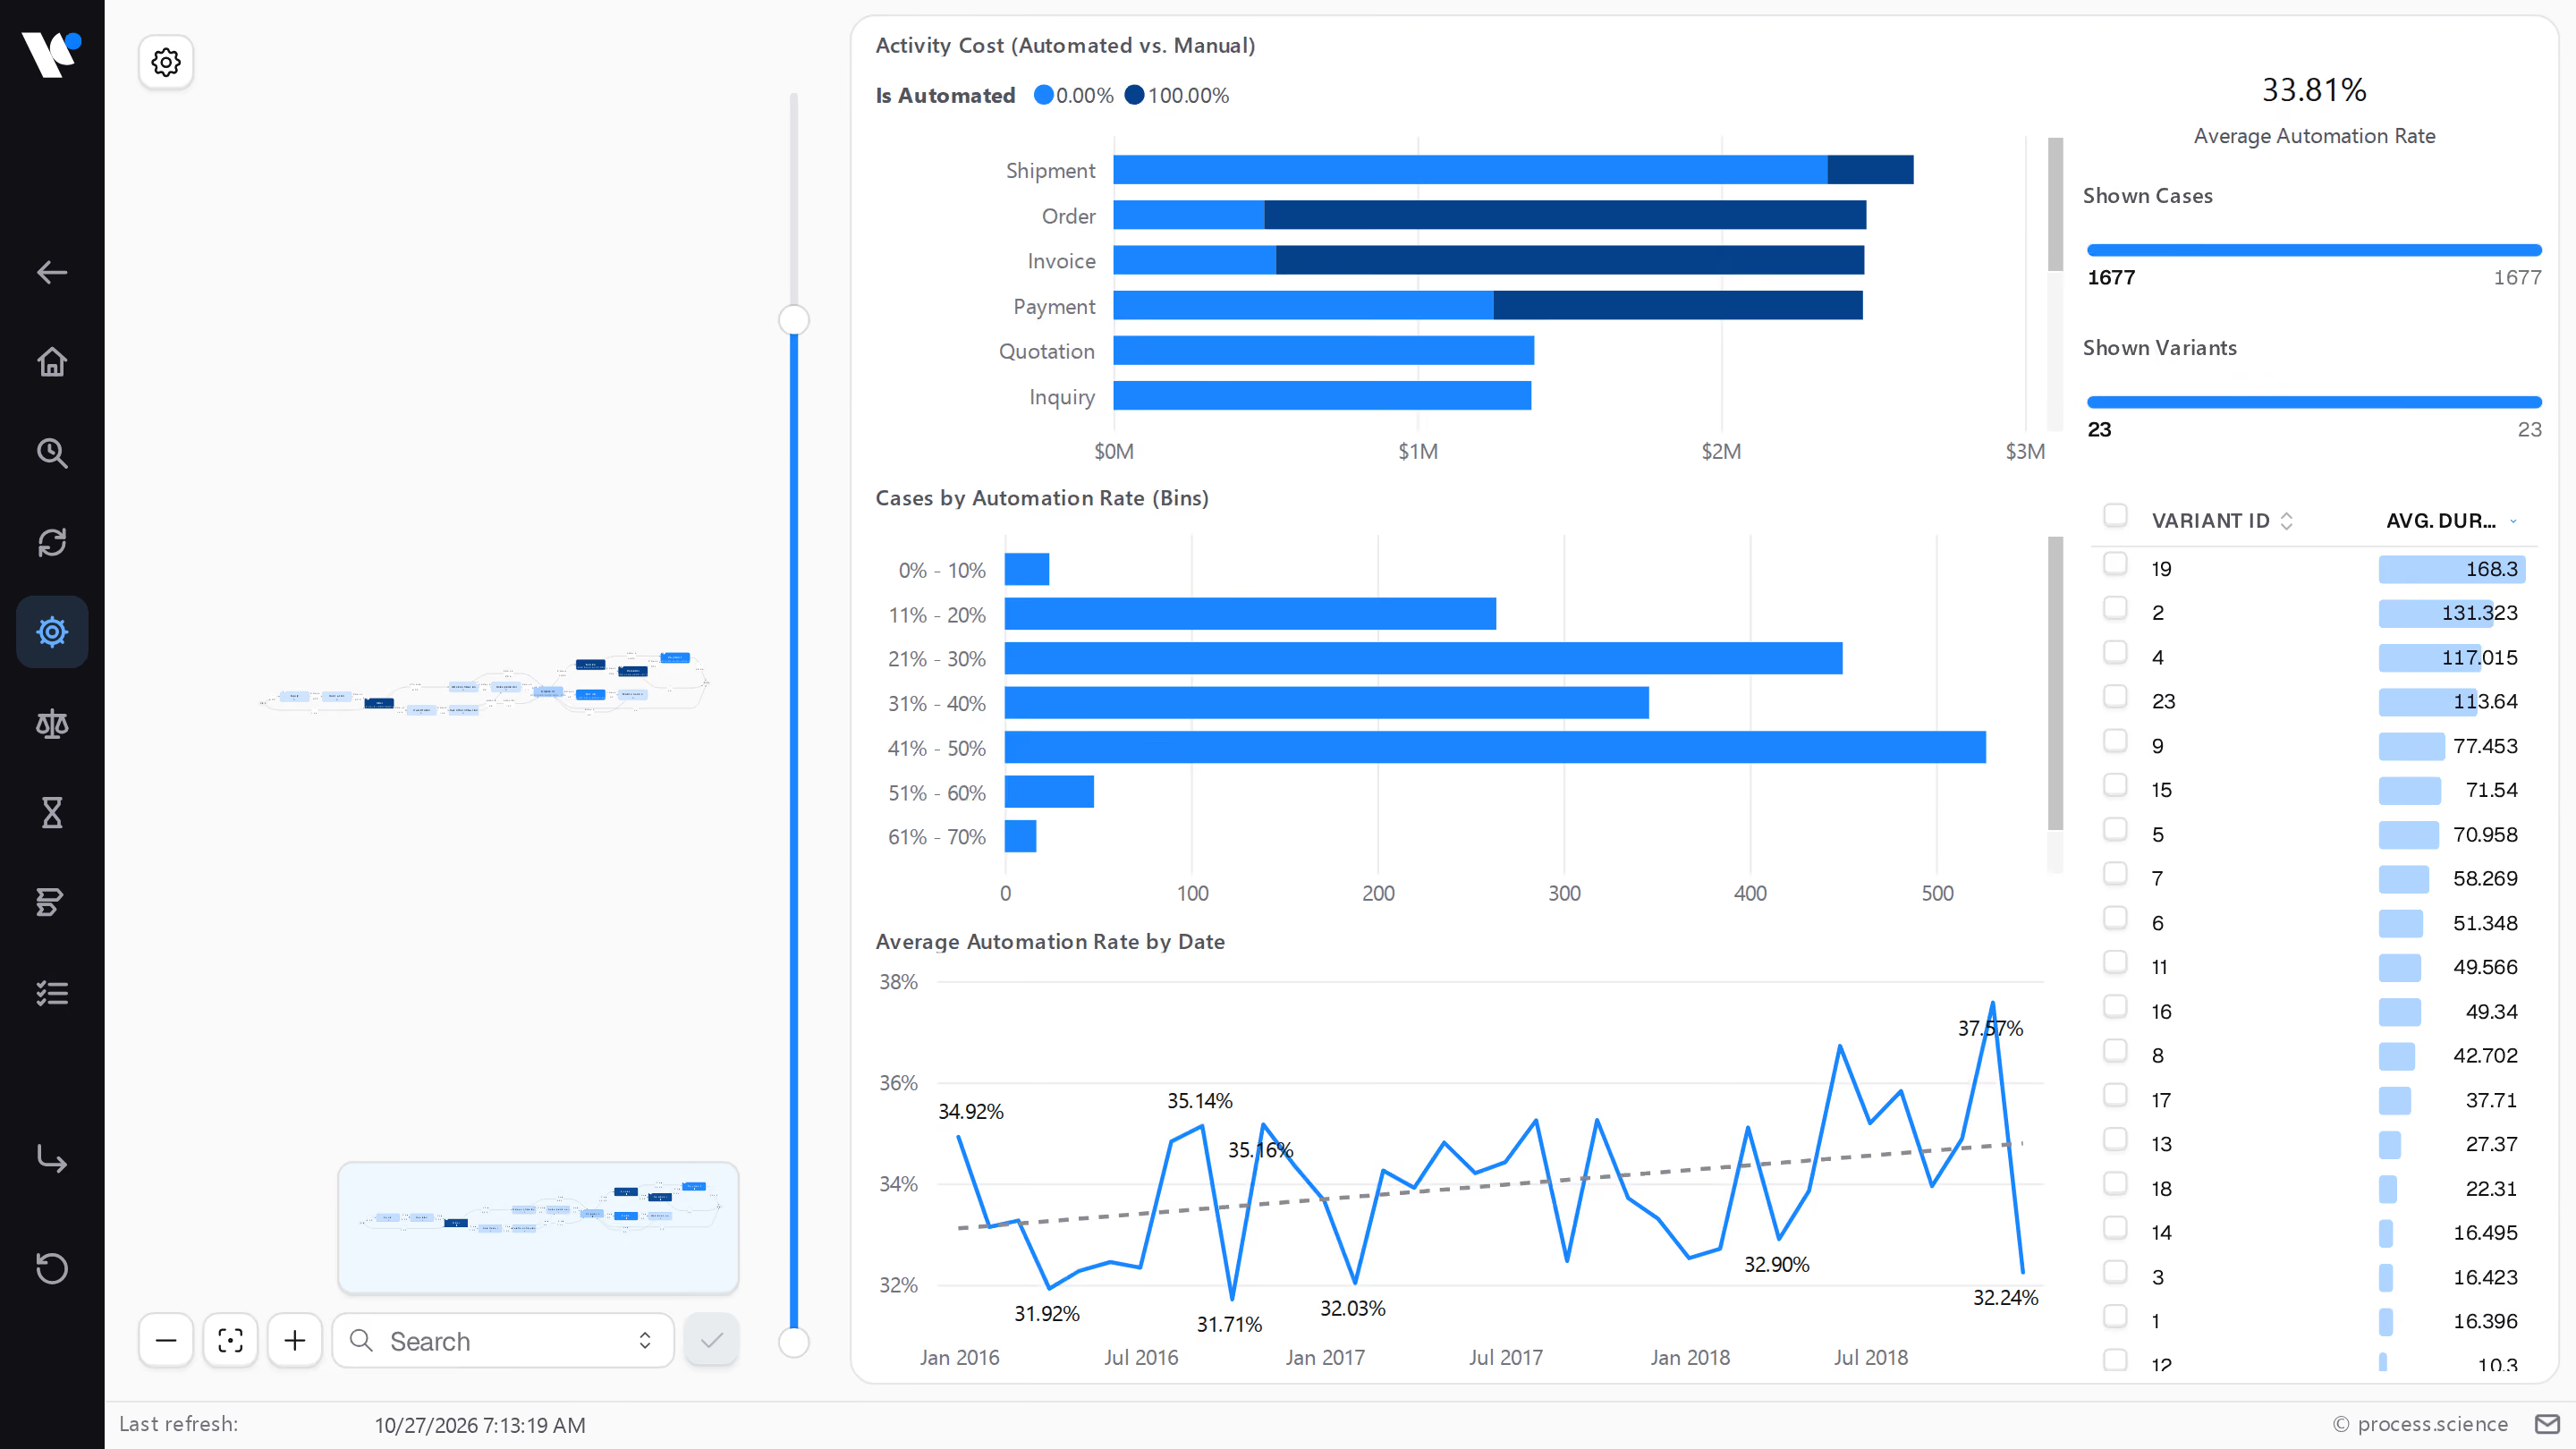
Automation rates by activity and over time in Process.Science

Process.Science Intelligence

Une exécution terminée devient le jeu de données sur lequel travaillent vos projets Intelligence, et l'analyse se rafraîchit automatiquement. À partir de là, vous disposez de la configuration, de l'analyse, des insights, du chat et des alertes.
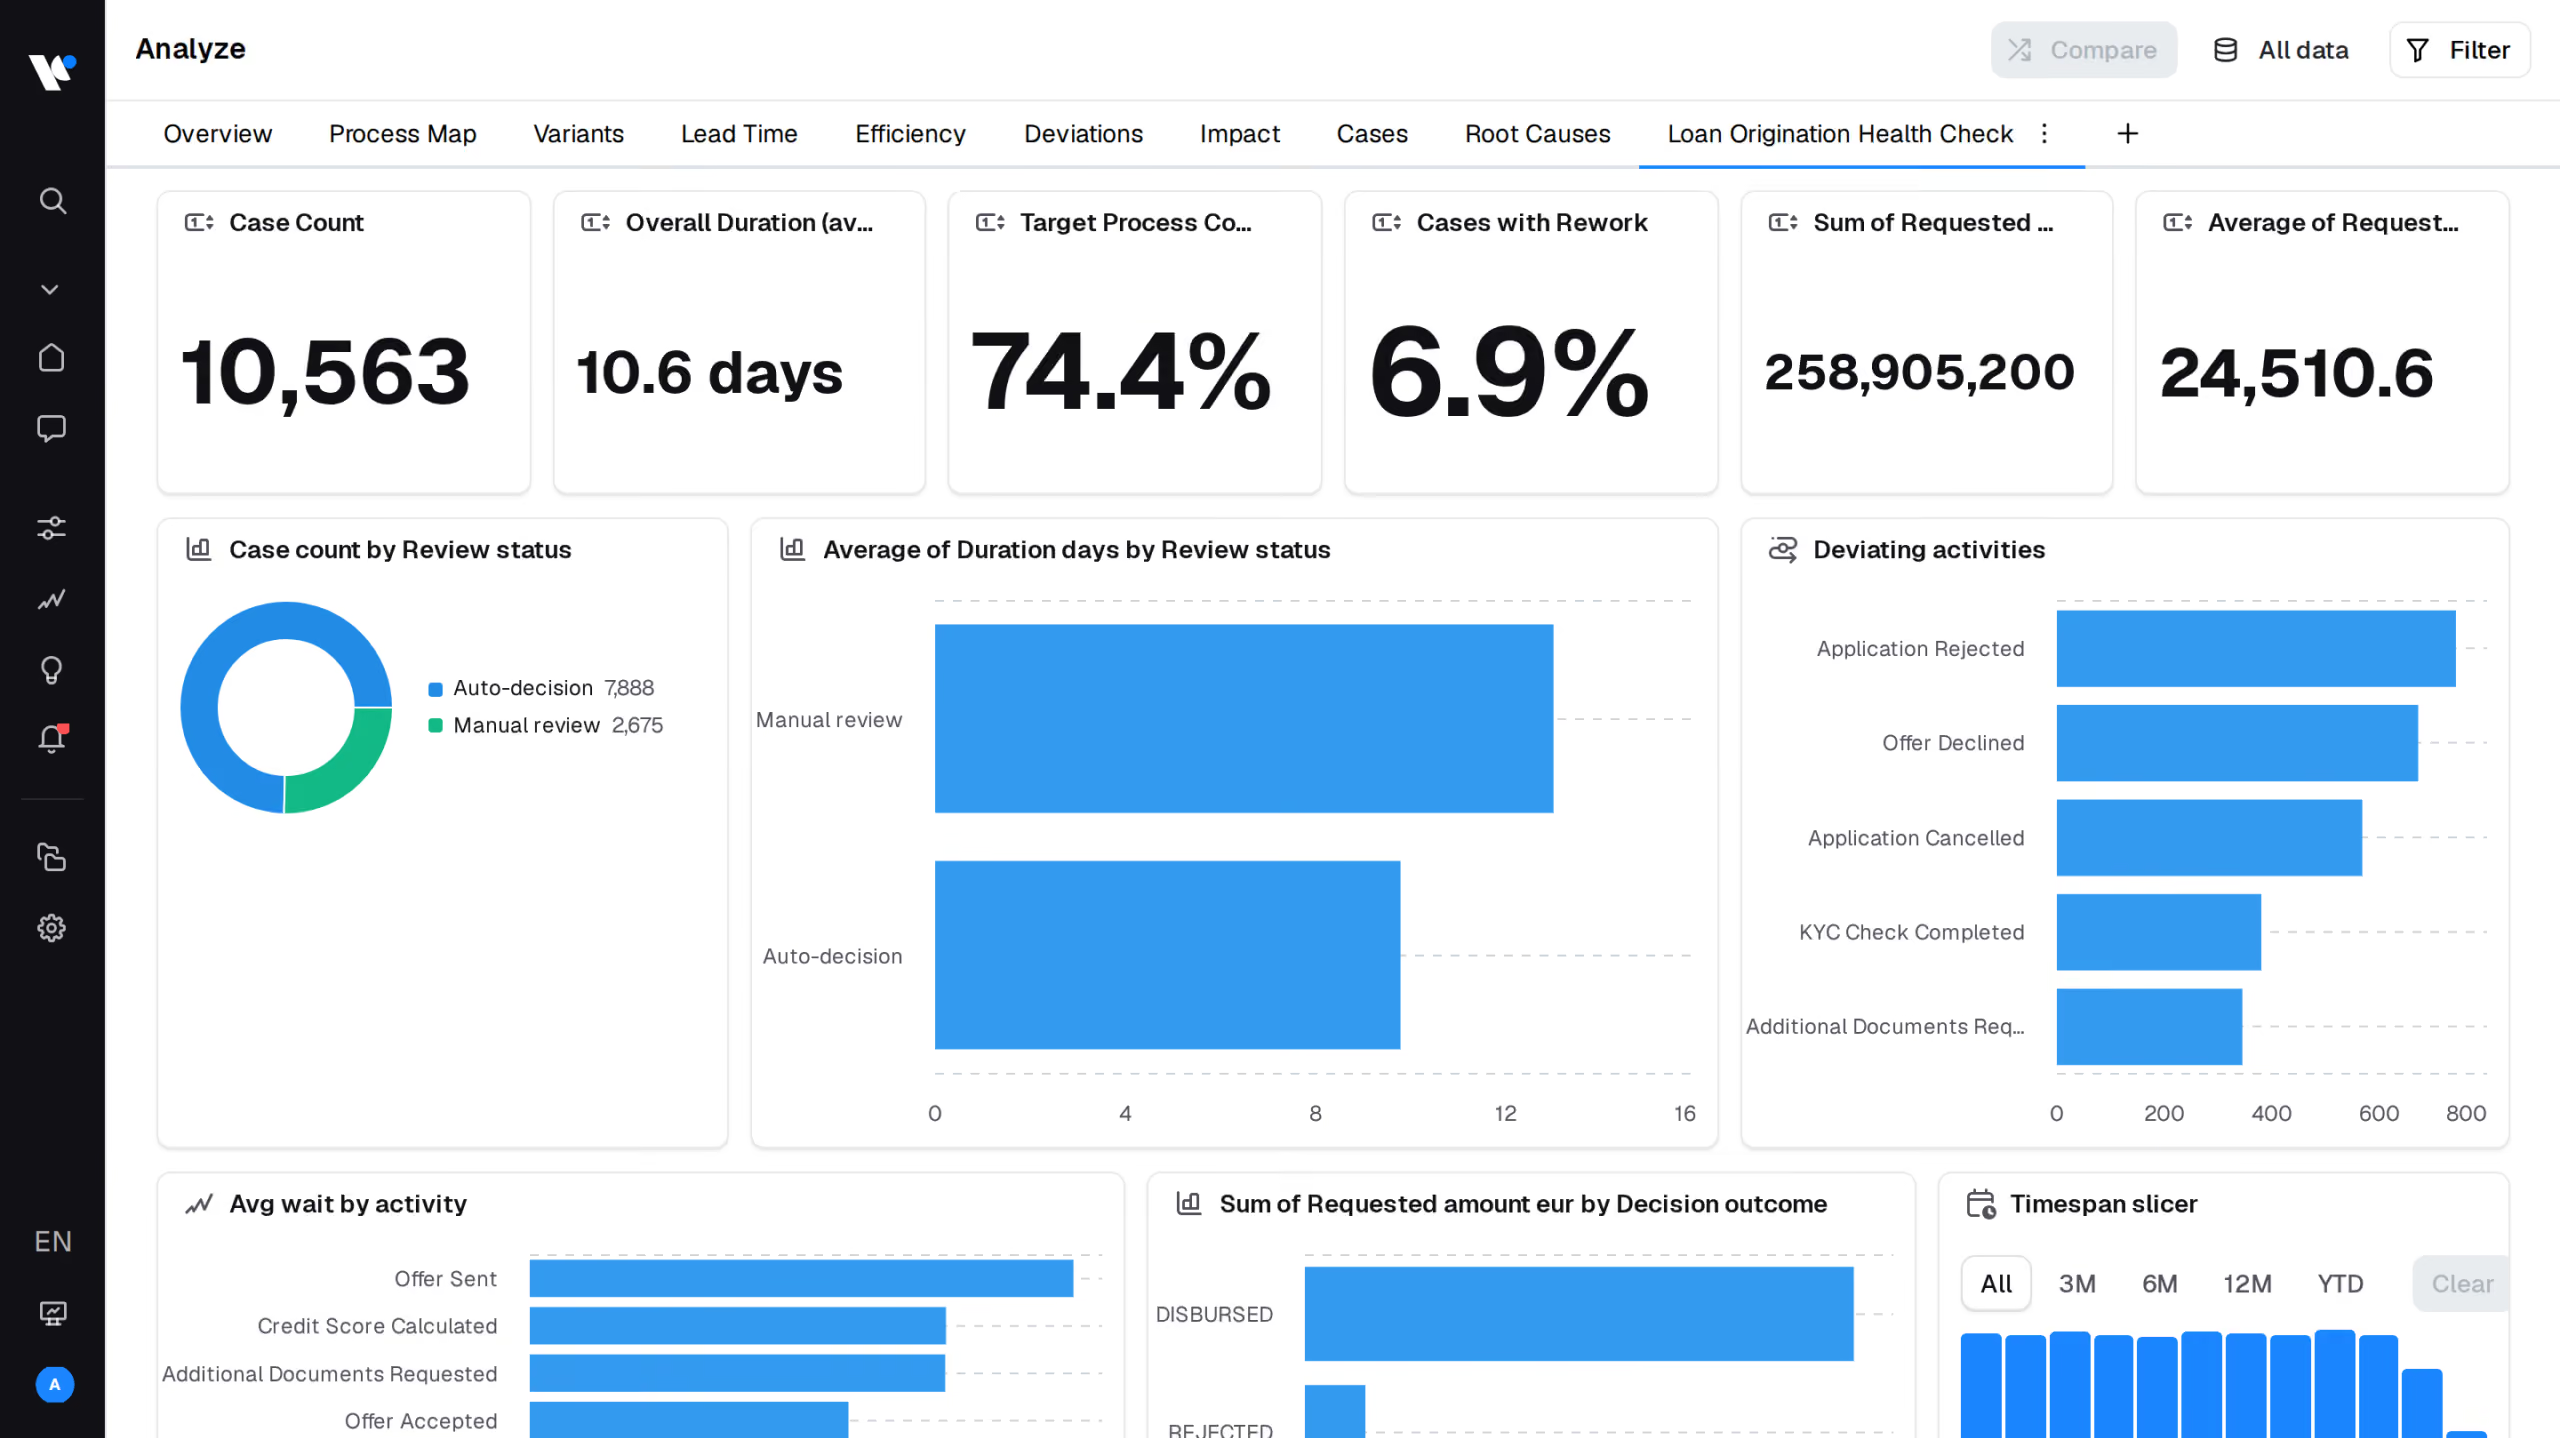
Interface de Process.Science Intelligence avec configuration, analyse, enseignements, chat et notifications
Démarrer

Visualisez votre propre journal d'événements, pas une démo

Connectez un système, choisissez un processus et voyez le résultat. Nous le faisons ensemble sur vos données, afin que le résultat soit votre processus réel et non un jeu de données fictif.
S'exécute sur vos propres systèmes et bases de données
Modèles prêts à l'emploi pour vos processus clés
Aucun ETL écrit à la main requis
En envoyant cette demande, vous acceptez la politique de confidentialité de Process.Science Politique de confidentialitéde Process.Science
Merci ! Votre soumission a bien été reçue !
Vous recevrez un e-mail contenant un lien de confirmation.
Oups ! Une erreur est survenue lors de l'envoi du formulaire.
Vous avez d'autres questions ?

FAQ :Technologie et architecture

Les réponses aux questions prioritaires des administrateurs IT et des ingénieurs de données
Quels systèmes sources sont pris en charge ?

Microsoft SQL Server et Azure SQL, PostgreSQL, MySQL et MariaDB sont pris en charge directement, ainsi que d'autres bases de données via ODBC, Microsoft Dynamics 365 via l'exportation Dataverse Lake, et le téléchargement de fichiers CSV pour plusieurs tables simultanément. SAP est lu via sa base de données, ce qui permet aux modèles SAP de fonctionner indépendamment de votre version SAP. Les résultats peuvent être réinjectés dans l'une de ces bases de données, fournis sous forme de fichiers de données ou envoyés vers Mavim.

La préparation des données doit-elle obligatoirement s'effectuer dans le cloud ?

Non. L'outil lit et écrit directement dans vos propres bases de données, de sorte que vos données restent dans votre environnement habituel. Les mots de passe et jetons d'accès sont stockés de manière chiffrée, l'accès est organisé par espace de travail et les exécutions s'adaptent automatiquement à la charge de travail lorsque les volumes augmentent.

L'outil remplace-t-il Power Query ?

Il ne s'agit pas d'un outil ETL généraliste, et il n'a pas vocation à l'être. Power Query et les outils similaires déplacent et remodèlent les données sans comprendre la notion de processus. L'outil de préparation des données est conçu pour une seule mission : transformer des tables opérationnelles en un journal d'événements, avec des activités, des cas, des variantes et des données de référence déjà en place. Vous pouvez continuer à utiliser Power Query pour tout le reste.

Combien de temps faut-il pour obtenir le premier journal d'événements ?

Une fois la connexion établie et le modèle choisi, la première exécution ne prend que quelques minutes au lieu de plusieurs semaines, car le travail de mappage est déjà effectué. Ce qui prend du temps, c'est de définir les activités qui composent votre processus ; il s'agit là d'une discussion interne avec vos équipes, et non d'une tâche d'ingénierie de données.

Que se passe-t-il lorsque notre système source change ?

Un modèle est un ensemble d'étapes SQL que vous pouvez lire et modifier. Si un champ est déplacé ou une table renommée, il vous suffit d'ajuster l'étape concernée au lieu de reconstruire tout le pipeline. Chaque exécution est consignée avec le nombre d'événements et la durée par activité ; ainsi, toute modification à la source se reflète immédiatement dans les chiffres.

Pouvons-nous créer un processus qui ne figure pas dans le catalogue ?

Oui. Vous pouvez partir d'un modèle et y ajouter vos propres activités et étapes de préparation, ou créer un processus personnalisé de toutes pièces. Dans les deux cas, le résultat conserve la même structure que n'importe quel autre journal d'événements, garantissant ainsi le bon fonctionnement de vos rapports.