Salta la parte più difficiledel Process Mining

Il Data Preparation Tool di Process.Science trasforma i dati grezzi provenienti da SAP, Microsoft Dynamics 365 e dai tuoi database in log di eventi pronti per l'analisi. Nessun progetto di data engineering, nessuna procedura ETL scritta a mano. Scegli un processo predefinito, connetti il tuo sistema e ogni esecuzione programmata fornirà un log di eventi completo a Power BI o a Process.Science Intelligence.

Tutto ciò che precede l'analisi,già risolto

Facile da configurare, flessibile con i tuoi sistemi e rigoroso sulla qualità dei log degli eventi, perché tutto ciò che analizzerai in seguito si basa su di essi.
Pagina di panoramica di una pipeline Purchase-to-Pay nel Data Preparation Tool, con lo storico delle esecuzioni e le attività
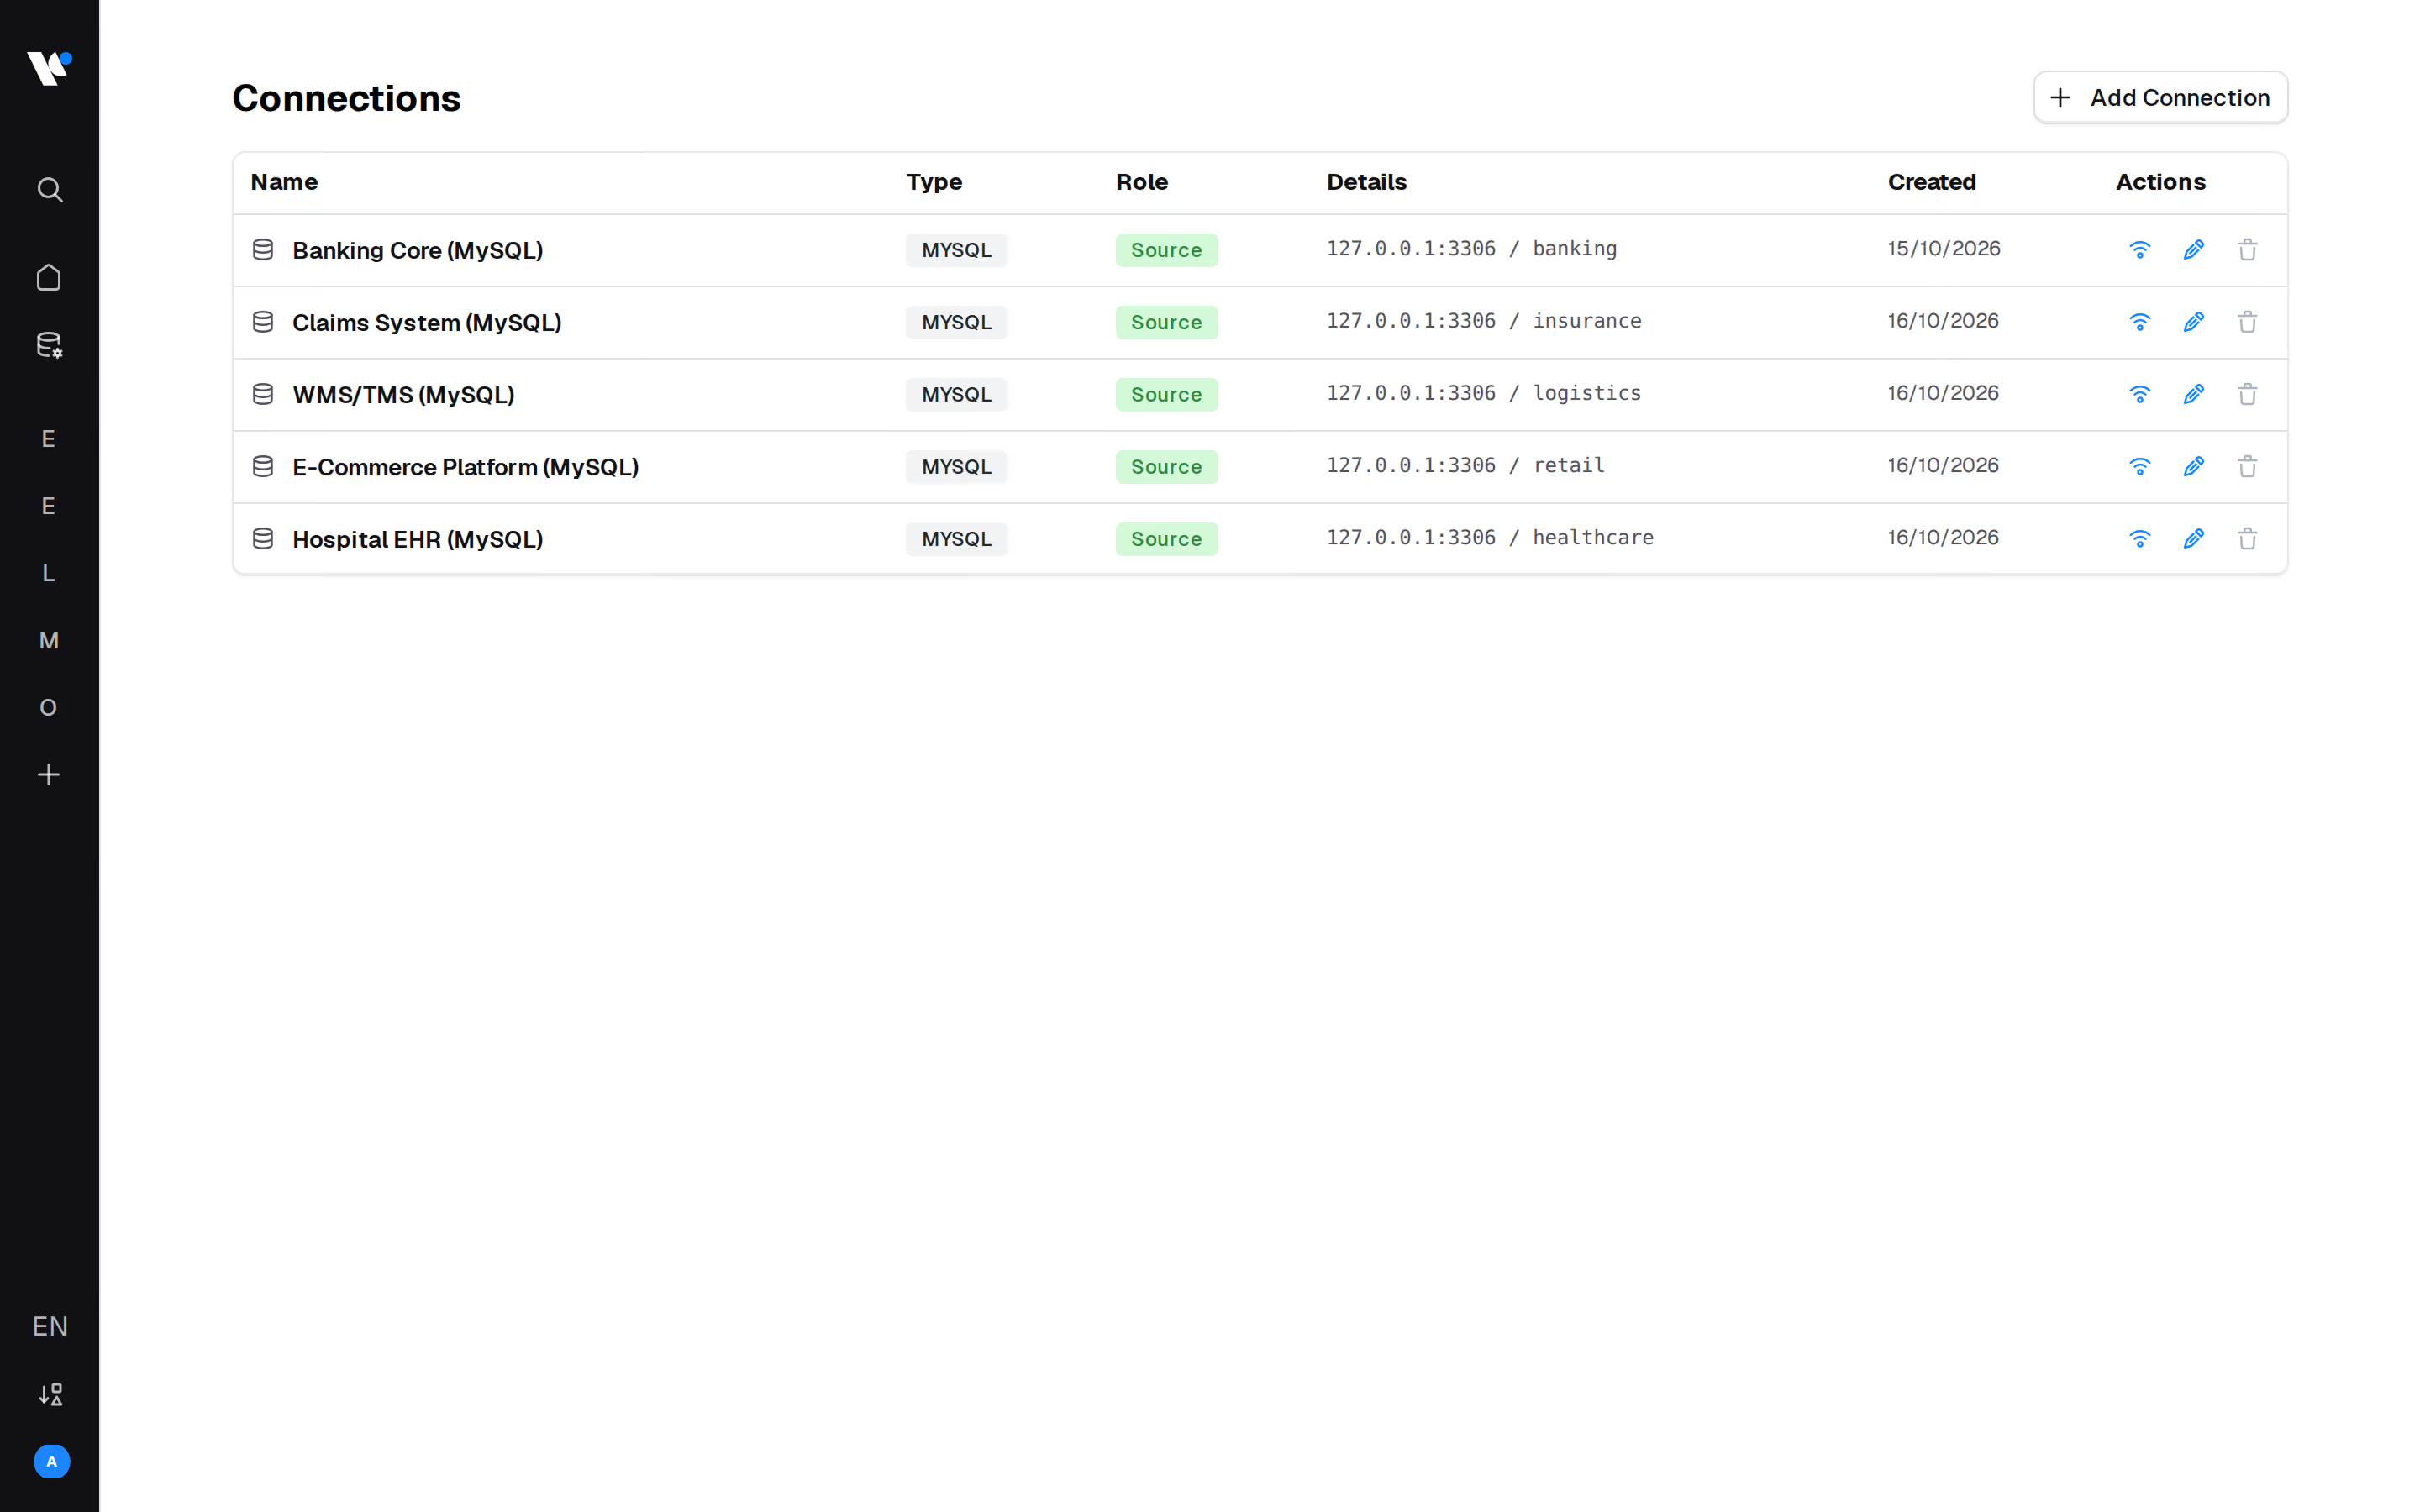
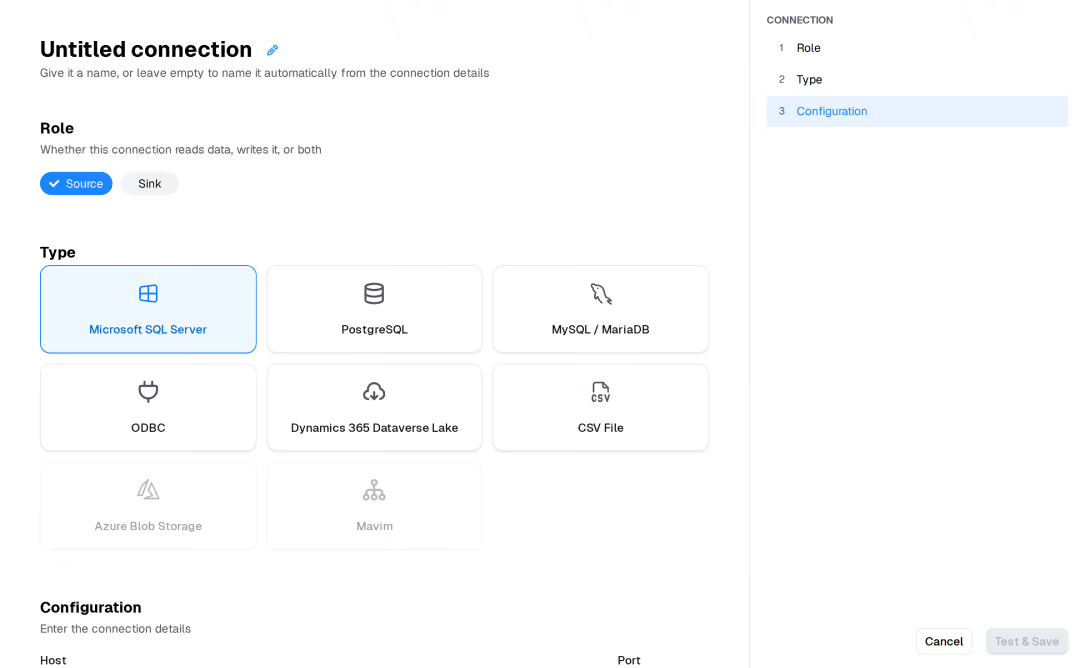
Panoramica delle connessioni configurate verso i sistemi di origine e di destinazione nel Data Preparation Tool
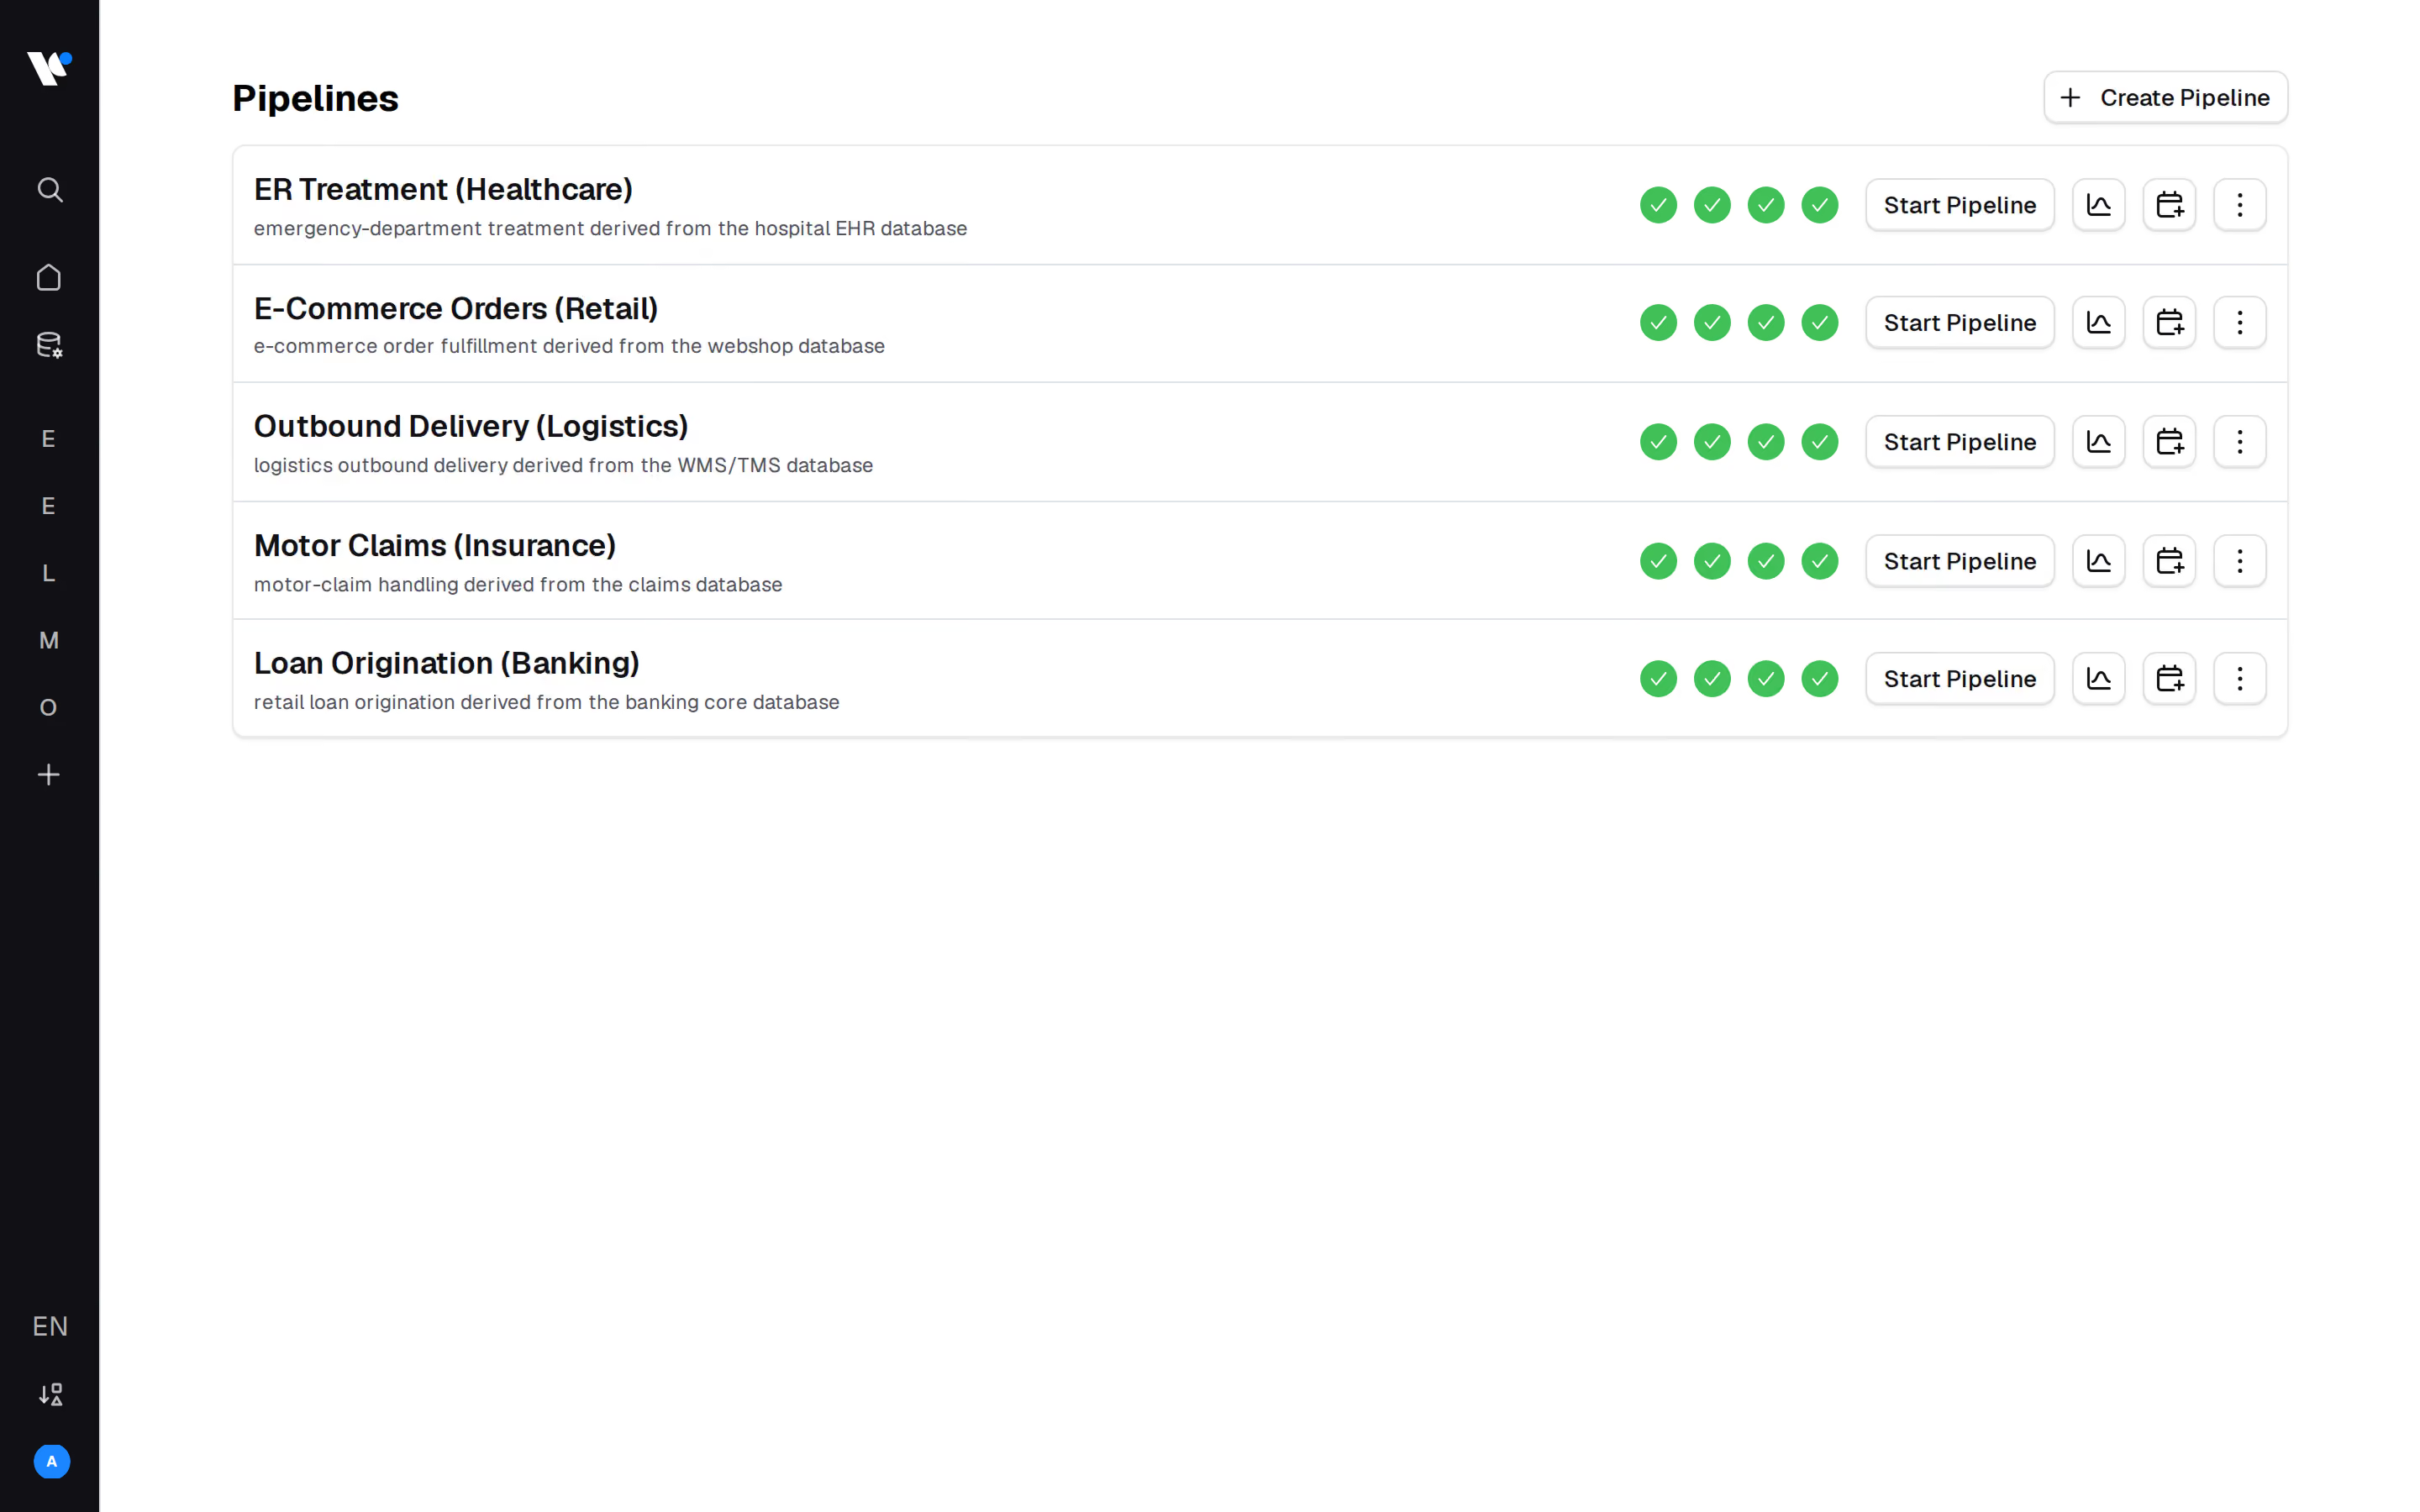
Panoramica delle pipeline configurate nel Data Preparation Tool
Maschera di creazione di una nuova pipeline nel Data Preparation Tool, con selezione di processi predefiniti
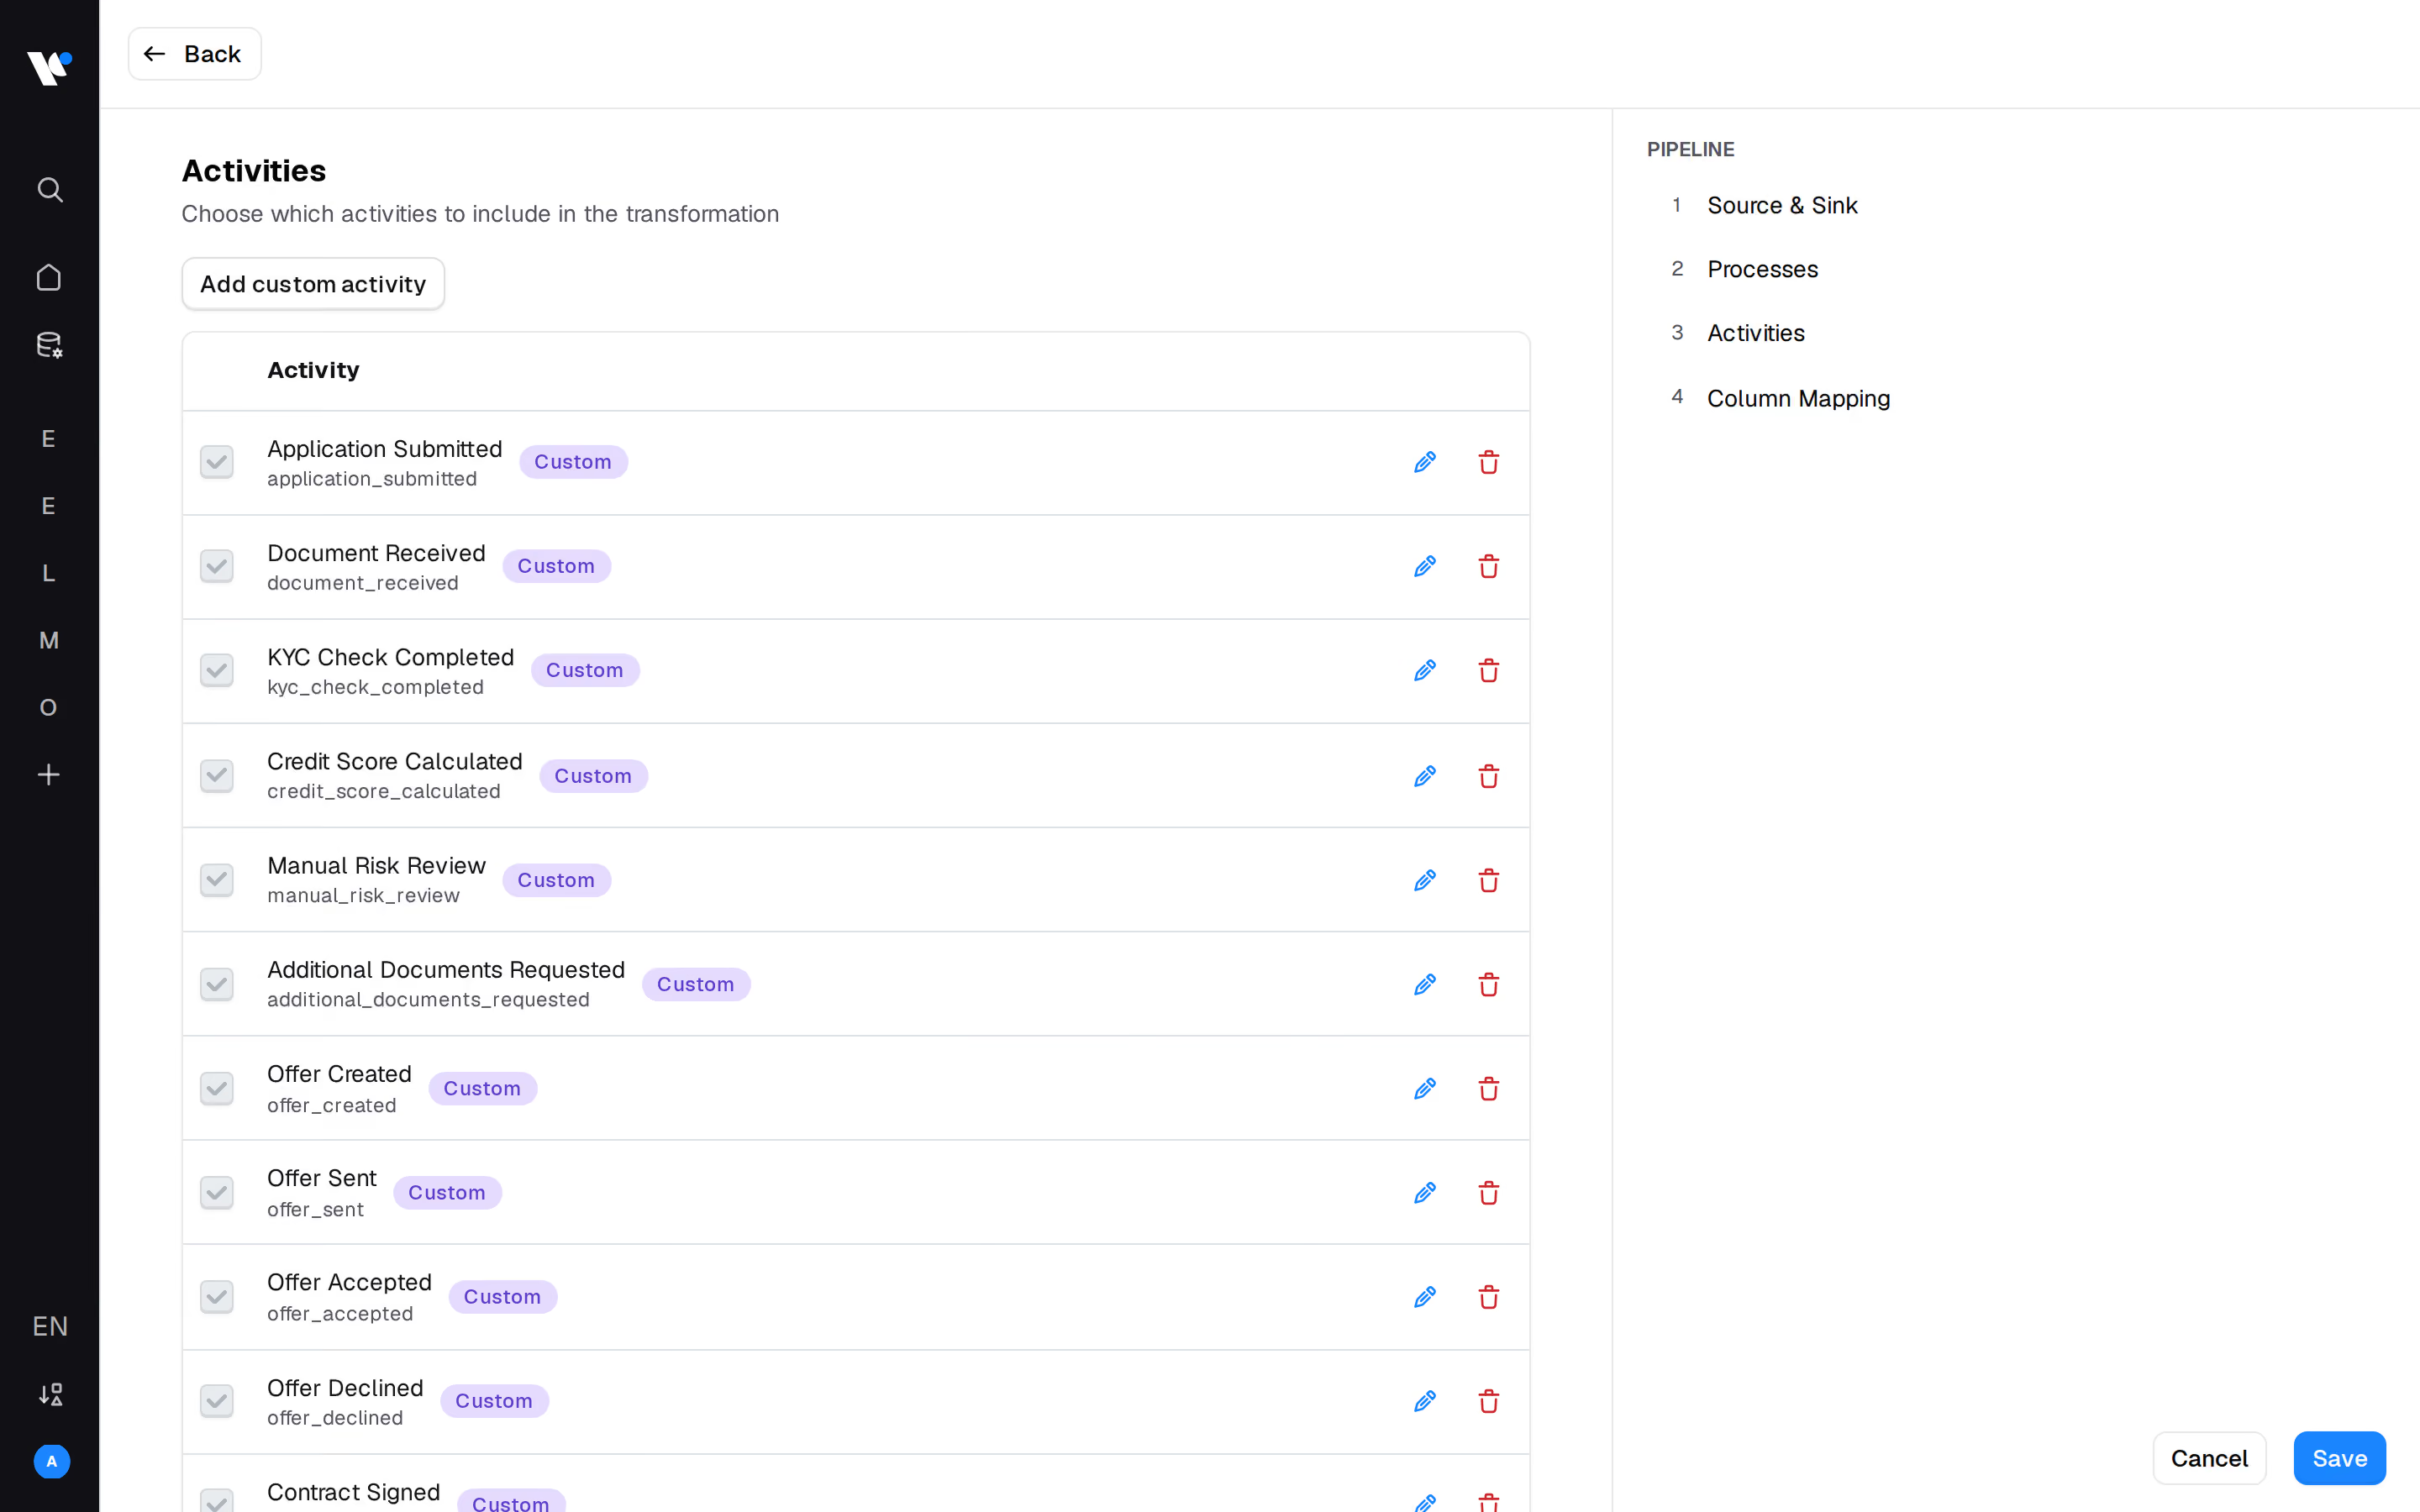
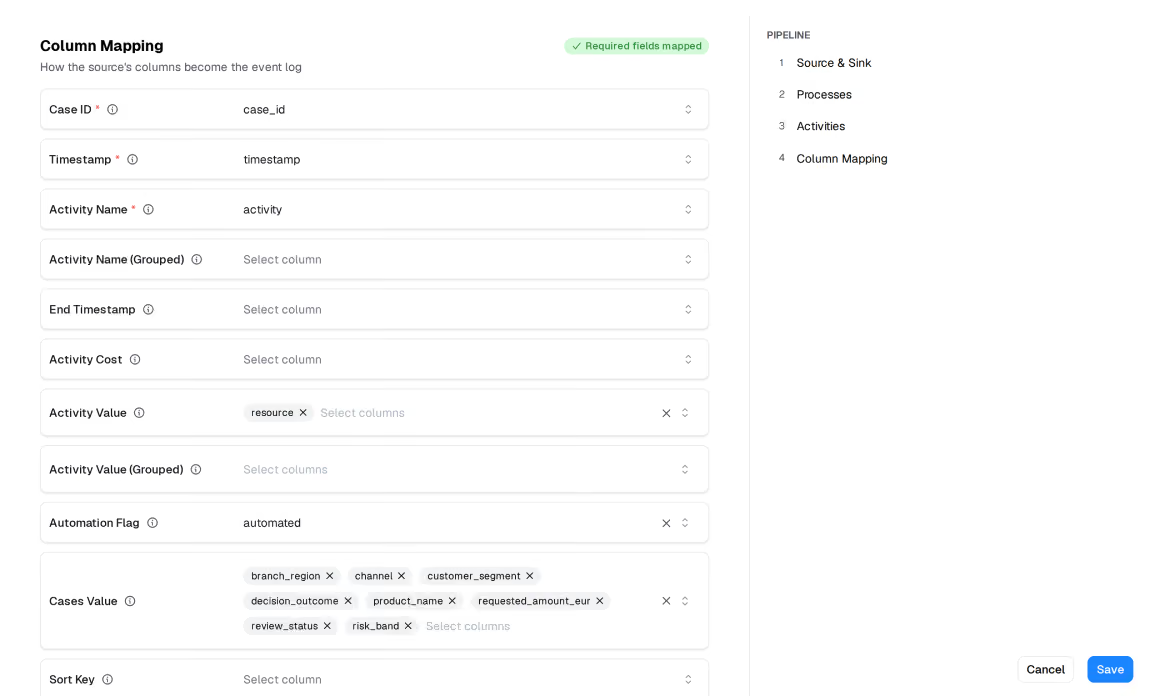
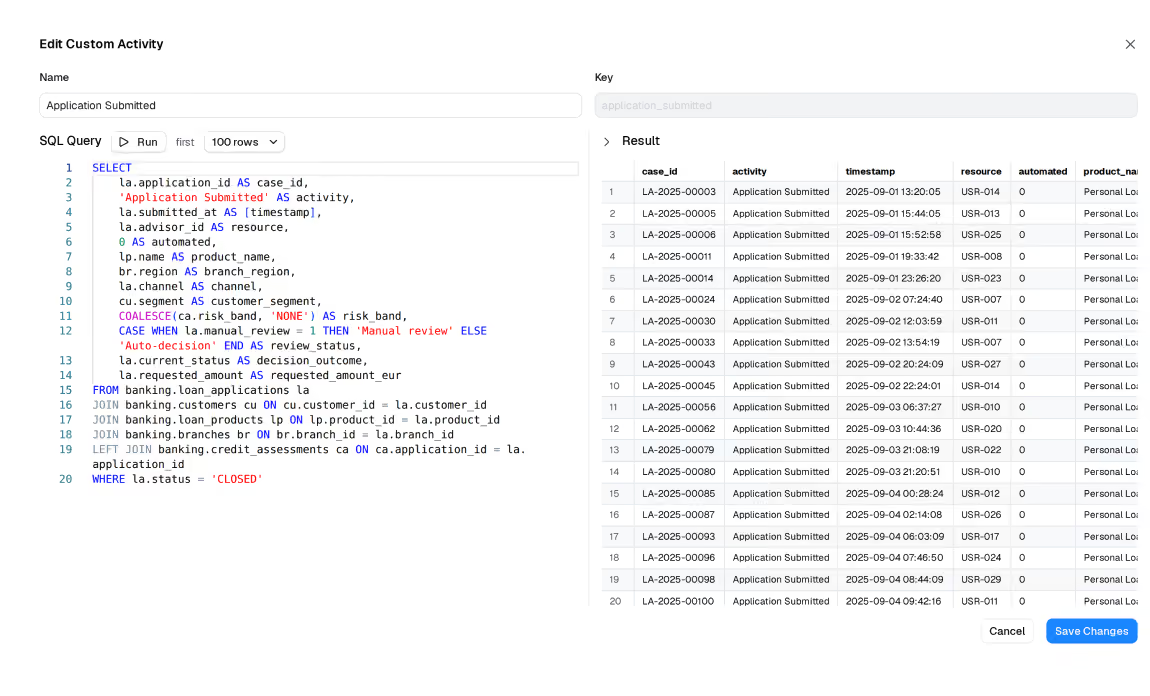
User interface displaying a list of custom activities to include in a transformation, with checkboxes marked for each: Application Submitted, Document Received, KYC Check Completed, Credit Score Calculated, Manual Risk Review, Additional Documents Requested, Offer Created, Offer Sent, Offer Accepted, Offer Declined, and Contract Signed. Each activity has an edit and delete icon. On the right, a pipeline navigation with steps: Source & Sink, Processes, Activities, and Column Mapping. Buttons for Back, Cancel, and Save are visible.

Il problema 80/20, al contrario

Nella maggior parte dei progetti di process mining, la maggior parte dello sforzo è dedicata alla ricerca e alla preparazione dei dati. I modelli e l'arricchimento automatico spostano questo lavoro all'inizio del progetto, dove viene eseguito una volta sola.

Il labirinto dei sistemi, già mappato

I sistemi ERP, CRM e ITSM contengono decine di migliaia di tabelle. Abbiamo decodificato quelle rilevanti per i processi da cui la maggior parte delle aziende inizia, così nessuno deve perdere tempo a cercare quale campo contenga il timestamp.

Più di semplice caso, attività, timestamp

Un semplice event log non basta. Ogni esecuzione arriva arricchita con dati anagrafici, durate, varianti, costi e indicatori di automazione, così l'analisi può iniziare subito, senza dover passare per la modellazione.
La formula di Process.Science

Meno data engineering,più analisi dei processi

Scripting SQL manuale

Funzionano finché il sistema sorgente non cambia. Difficili da documentare, difficili da trasferire e un aggiornamento dello schema può compromettere l'intera logica.

Suite ETL pesanti

Creati per il data warehousing, non per il process mining. Trasferiscono i dati in modo affidabile, ma non sanno cosa sia un'attività, un caso o una variante.

Strumento di preparazione dati di Process.Science

Progettato per un unico scopo: trasformare i dati operativi in log di eventi. Conosce i processi, li arricchisce con i dati anagrafici e fornisce la stessa struttura di output per ogni processo e ogni sistema sorgente.
Pronto per l'analisi? Scegli il sistema di destinazione:

Tre passaggi dai dati grezzia un registro eventi completato

Connetti il tuo sistema, scegli il processo e pianificalo. Da quel momento, ogni esecuzione fornirà lo stesso registro eventi completo.

01. Connetti

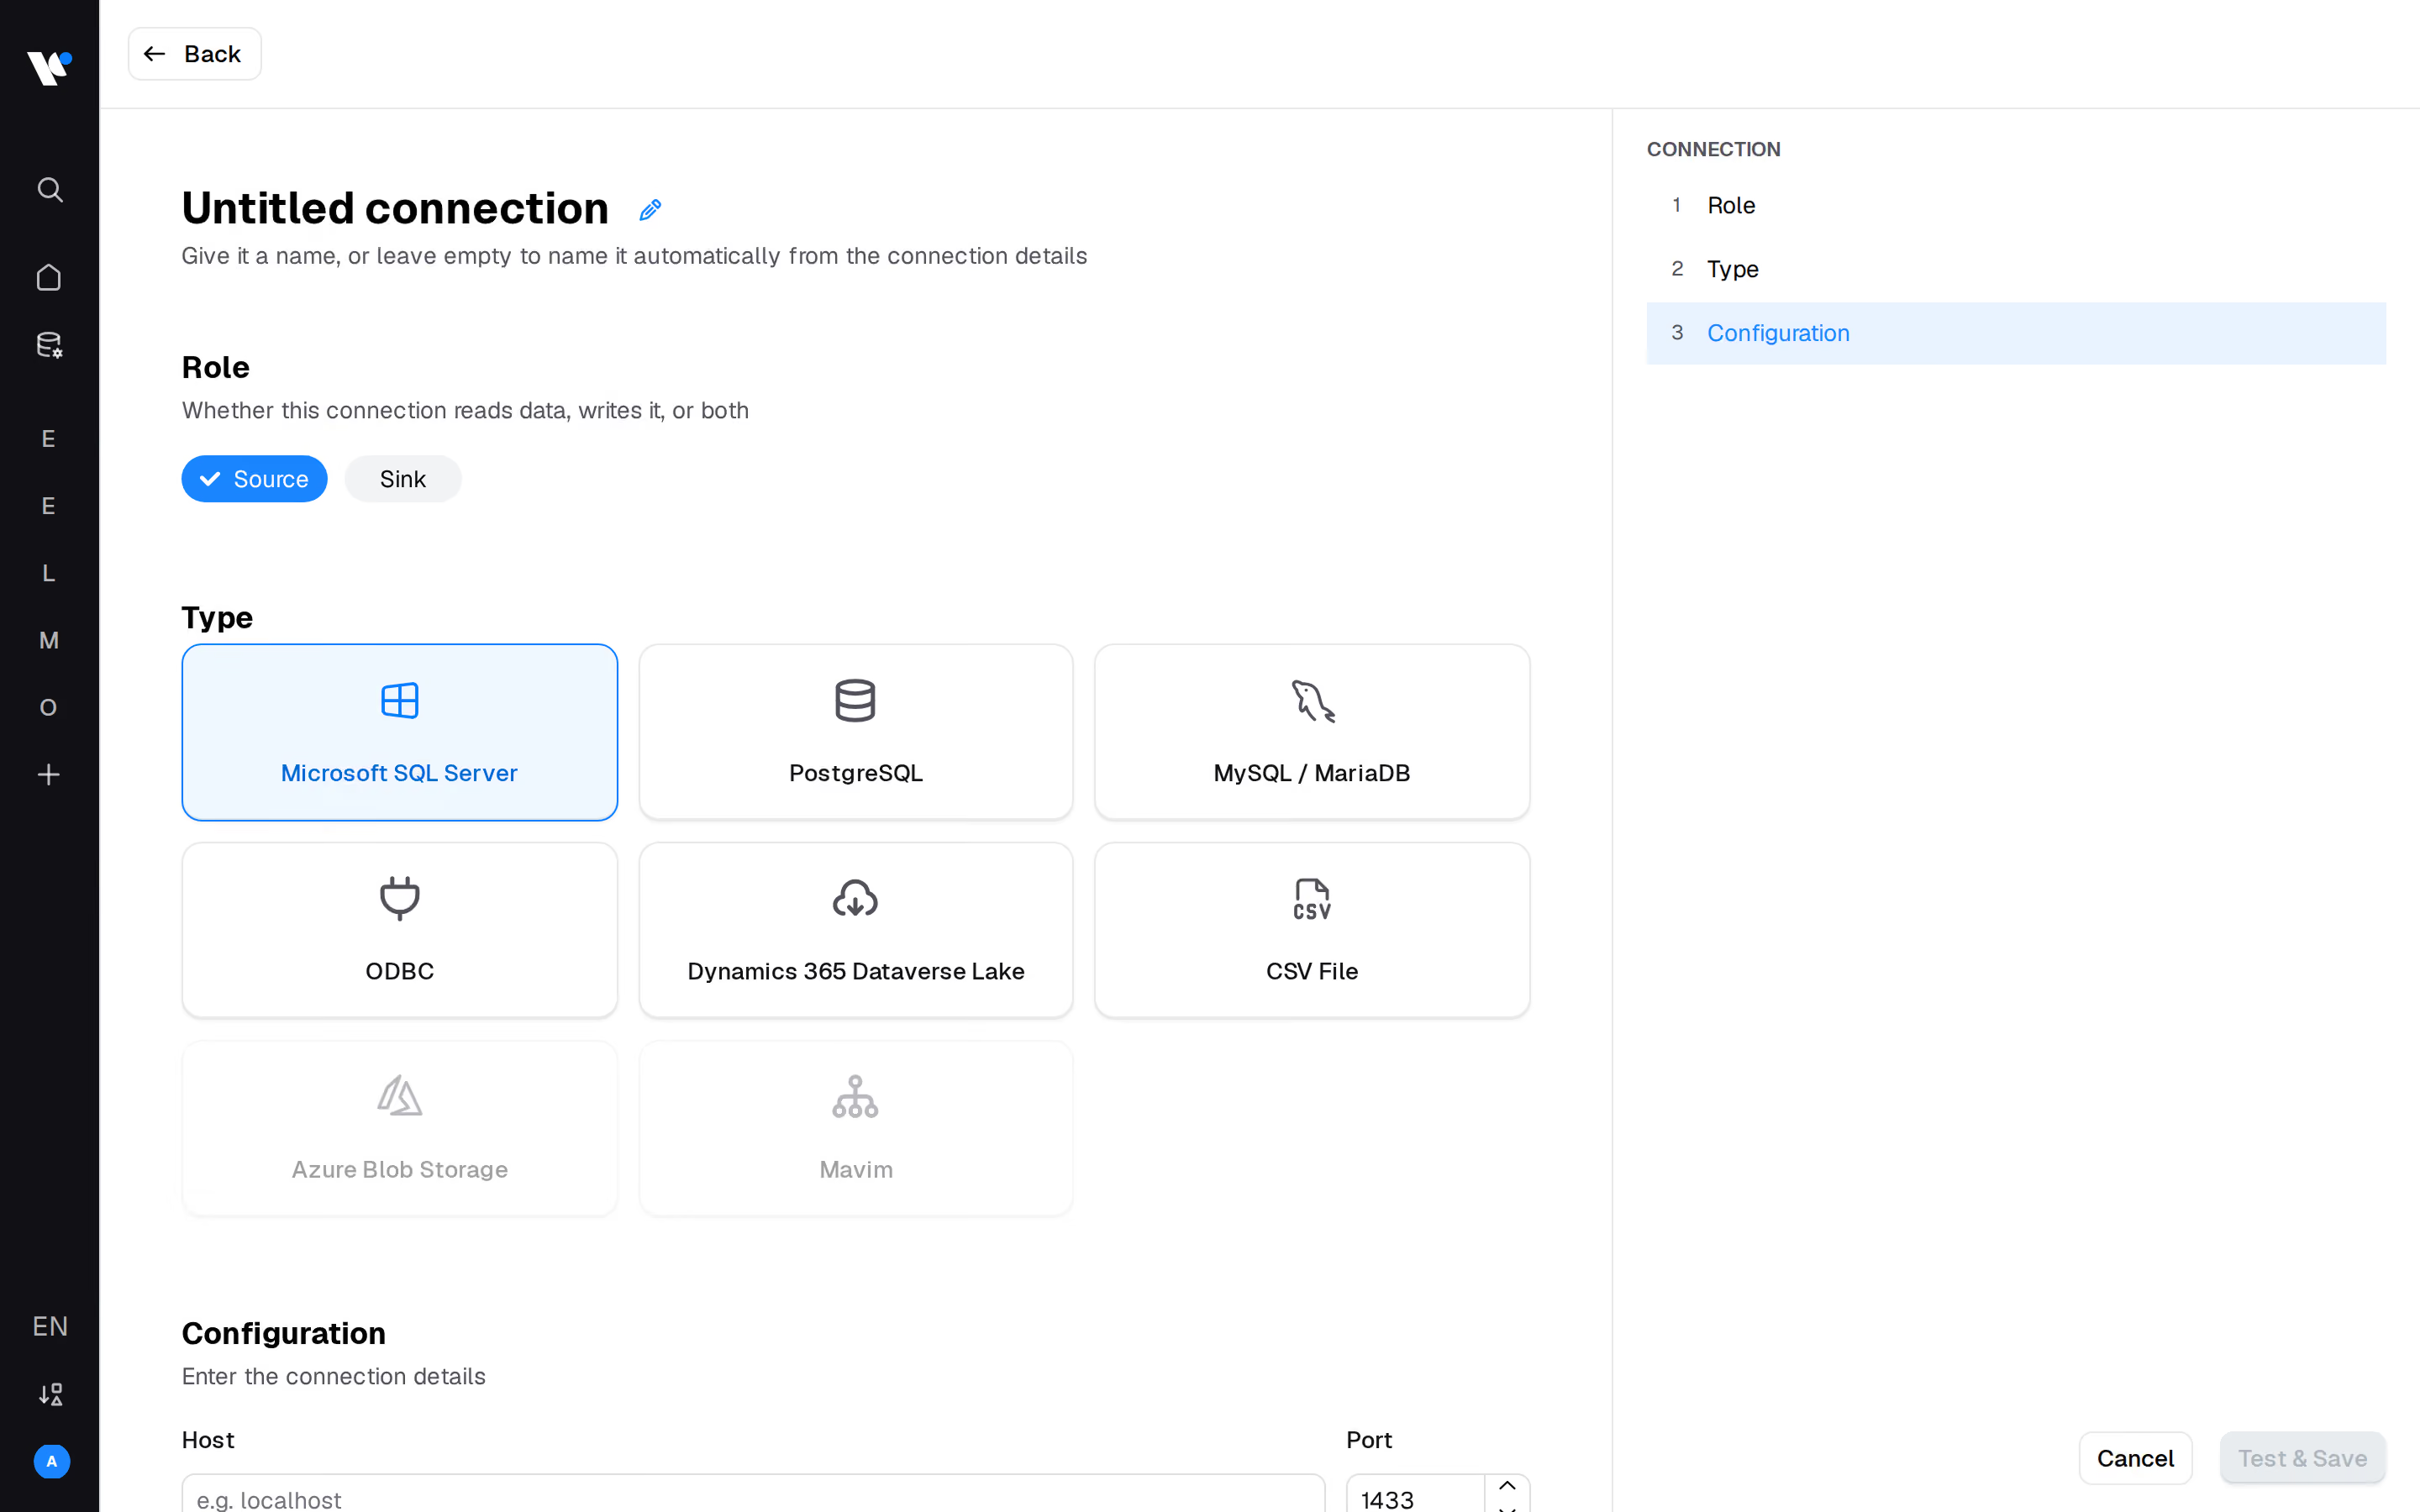
Scegli il tuo sistema: Microsoft SQL Server o Azure SQL, PostgreSQL, MySQL o MariaDB, Microsoft Dynamics 365 o un semplice caricamento CSV. Inserisci i dettagli della connessione, verifica e salva, quindi scegli la destinazione dei risultati.

02. Scegli il tuo processo

Parti da un modello pronto all'uso, come SAP Purchase-to-Pay, e seleziona le attività che ti interessano. I modelli sanno già quali colonne contengono il caso, l'attività e il tempo.

03. Eseguila o pianificala

Avvia la pipeline una volta, oppure pianificala su base oraria, giornaliera, settimanale, mensile o tramite la tua espressione cron. Puoi anche attivare un'esecuzione dai tuoi strumenti tramite API.
Configurazione immediata

Modelli collaudati, aperti fino all'ultima riga di SQL

Non partire da zero. Abbiamo decodificato le strutture delle tabelle dei sistemi più utilizzati dalle aziende e ogni modello rimane a tua completa disposizione per essere modificato.
Pronto per i tuoi processi principali:SAP P2P, dalla richiesta d'acquisto alla liquidazione della fattura. SAP O2C, dal preventivo alla fatturazione e al pagamento. Microsoft Dynamics 365 P2P e O2C. Per SAP P2P è disponibile anche una variante incentrata sugli oggetti, che copre richieste, ordini, entrate merci e fatture e le loro relazioni reciproche.
Nessun blocco:Attiva o disattiva le attività, modifica l'SQL sottostante, aggiungi le tue attività e i passaggi di preparazione e adatta tutto al tuo sistema tramite parametri. Se il tuo processo non è nel catalogo, crealo da zero.
Scritto una volta, eseguito ovunque:Un modello viene scritto una volta e funziona su ogni database supportato, poiché lo strumento traduce l'SQL nel dialetto di ciascun sistema.
Catalogo di modelli del Data Preparation Tool con processi pronti all'uso per SAP Purchase-to-Pay e Dynamics 365
Registro eventi arricchito dal Data Preparation Tool, con caso, attività e marca temporale oltre a tempo di attraversamento, variante e costi
Cosa ottieni

Un registro eventi pronto per l'analisi

Un tipico registro eventi ha tre colonne: caso, attività, timestamp. È da qui che parte il nostro.
Arricchito, non essenziale:Ogni caso include tempo di attraversamento, variante, cicli, costi e tasso di automazione. Ogni passaggio riporta durata, tempo di attesa e flag di rilavorazione. Gli attributi del caso, come fornitore, stabilimento o termini di pagamento, sono integrati e i filtri delle varianti vengono calcolati in anticipo.
Due livelli di zoom, due linguaggi:Passa dalla vista dettagliata ("Registrazione entrata merci") alla vista gestionale ("Ricevimento merci e fatture").
Una struttura per ogni processo:Purchase-to-Pay, Order-to-Cash o un processo personalizzato, da SAP, Dynamics o qualsiasi database: le tabelle di output hanno sempre lo stesso layout. Report e dashboard funzionano su tutti senza necessità di rielaborazioni per ogni progetto.
Garanzia di qualità automatizzata

Nulla di incompleto raggiungerà mai i tuoi report

I dati sporchi non si annunciano, distorcono semplicemente la dashboard. Il Data Preparation Tool è il guardiano davanti alla tua analisi.
Completo o niente:Un nuovo registro eventi viene attivato con un unico comando, solo una volta completato. La tua analisi non leggerà mai un registro scritto a metà e un'esecuzione fallita lascia intatta la versione precedente. Le tabelle obsolete vengono rimosse automaticamente.
Progettato per essere robusto:Se un'attività fallisce, ricevi un avviso ma ottieni comunque tutto il resto, invece di perdere l'intera esecuzione.
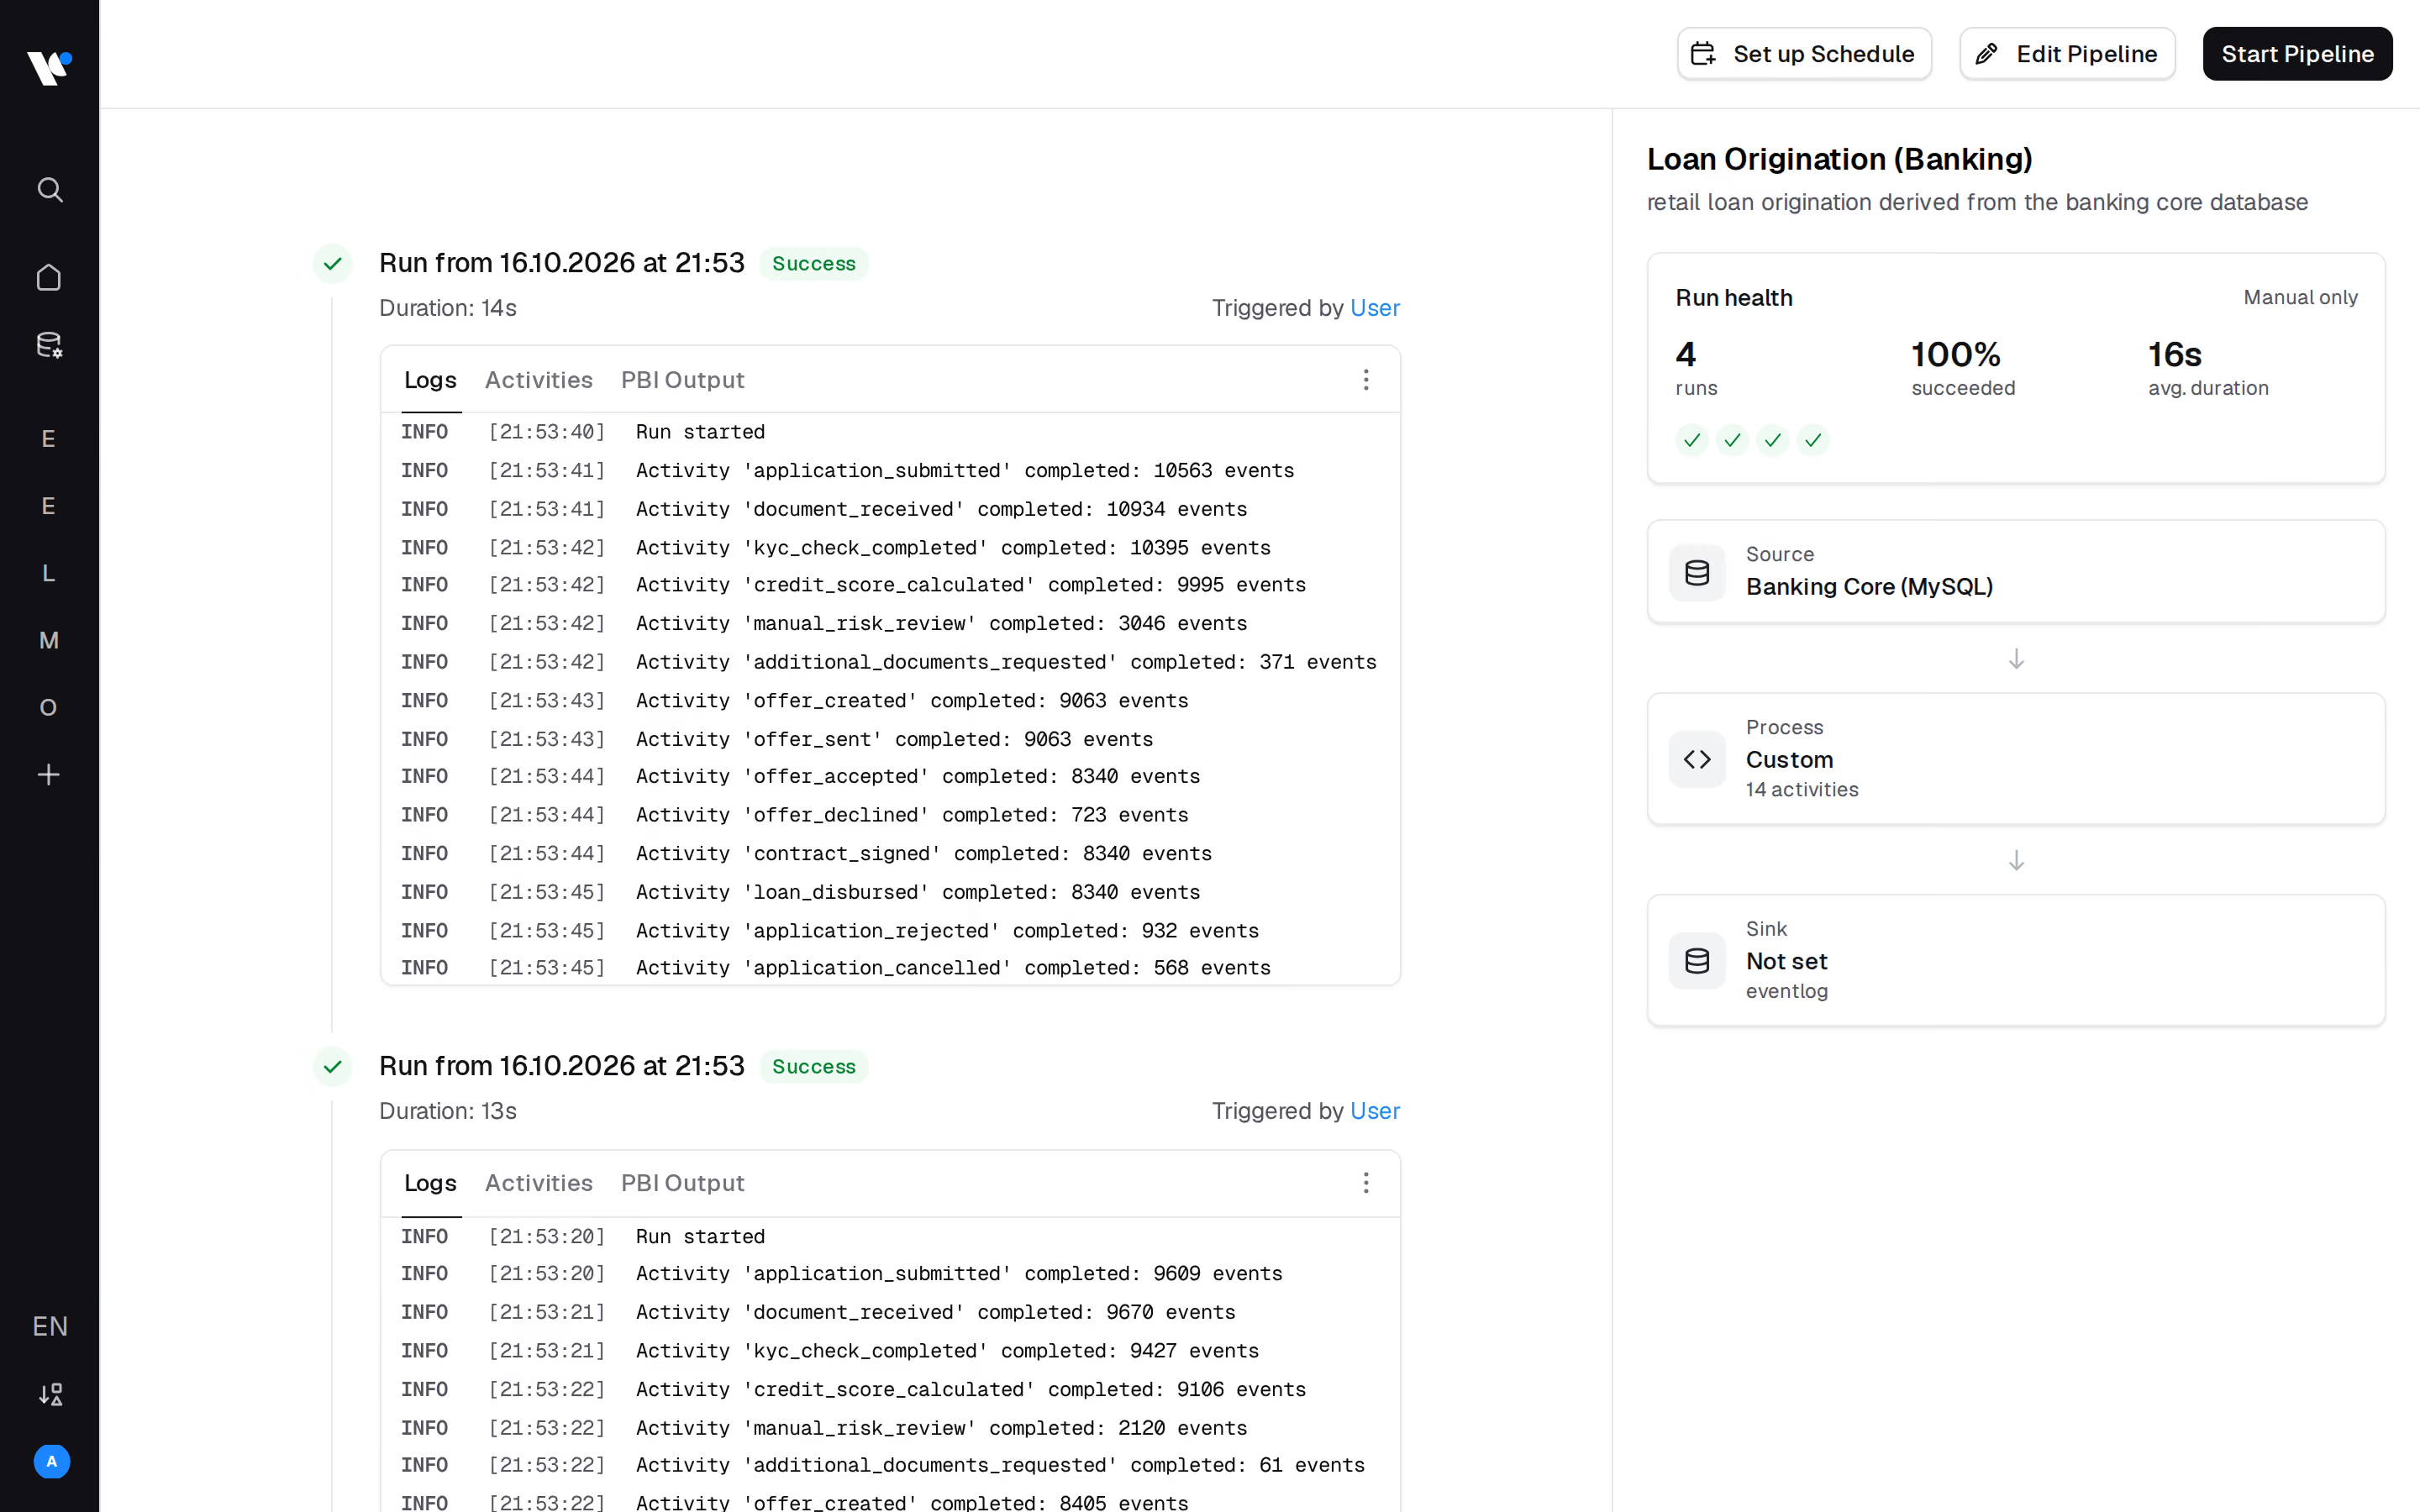
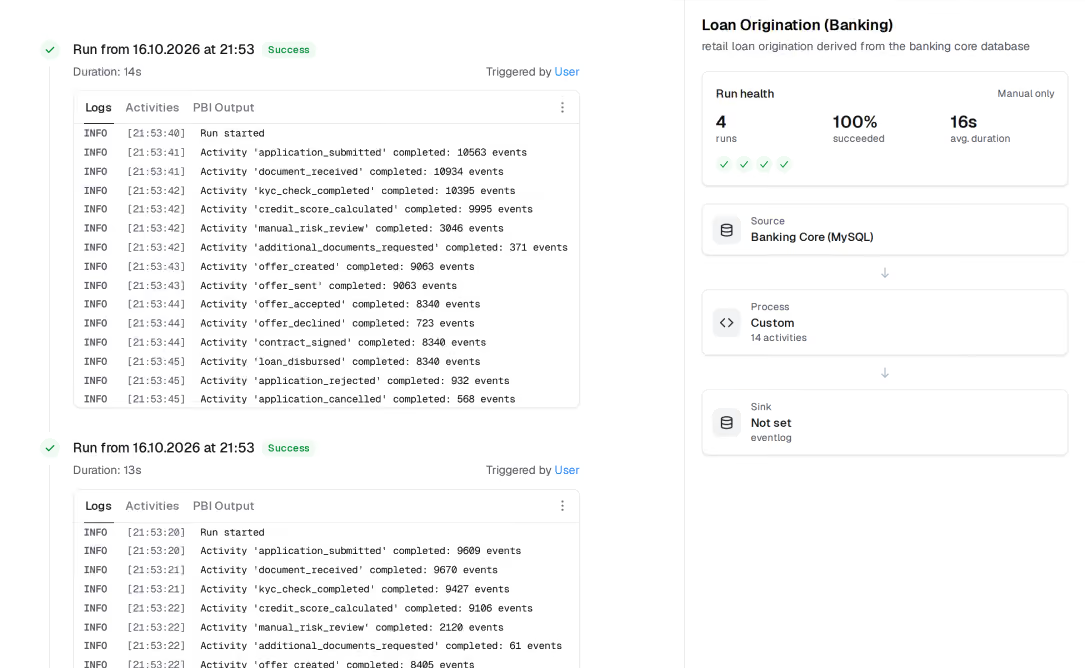
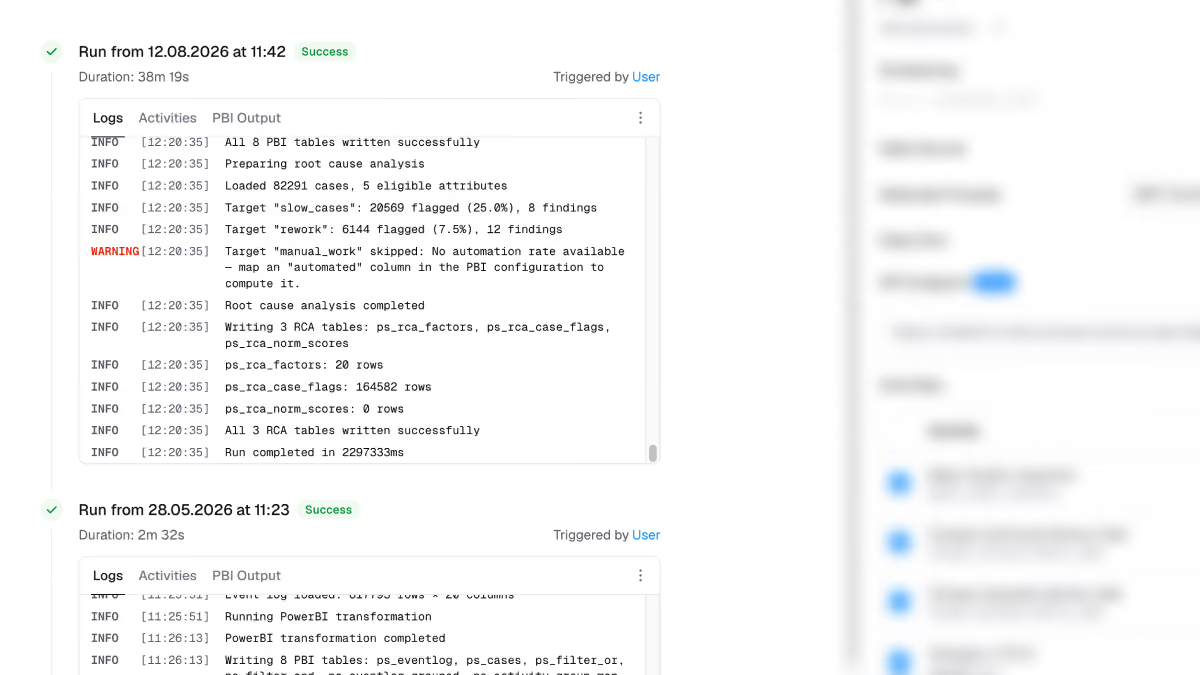
Ogni esecuzione è tracciabile:Cronologia completa delle esecuzioni e log, con conteggio degli eventi e durate per attività, così puoi vedere cosa ha prodotto un'esecuzione e cosa è cambiato dall'ultima volta.
Controllo qualità nel Data Preparation Tool che convalida un registro eventi prima della pubblicazione
Storico delle esecuzioni nel Data Preparation Tool con numero di eventi e durata per attività
Integrato in ogni esecuzione

Ogni registro eventi arriva con una prima analisi già pronta

Mentre lo strumento prepara i tuoi dati, identifica già quali casi si comportano in modo diverso. Li segnala e indica i fattori che hanno in comune.
Casi problematici, contrassegnati automaticamente:Casi lenti al di sopra del tuo obiettivo o nel quartile più lento, casi che contengono cicli di rilavorazione, casi con un basso tasso di automazione e violazioni delle norme di processo su cinque tipi di regole, con una norma predefinita inclusa per il ciclo SAP Purchase-to-Pay.
Fattori influenti, non congetture:Lo strumento scansiona ogni attributo del caso e classifica ciò che emerge tra i casi problematici, indicando l'entità dell'effetto, il numero di casi e la significatività statistica. Ad esempio: i casi con un determinato fornitore mancano l'obiettivo di throughput 3,2 volte più spesso rispetto agli altri.
Dove porta:I risultati vengono salvati accanto alle tue tabelle Power BI e in Process.Science Intelligence. Lì potrai seguirli attraverso il grafico di processo, confrontare le popolazioni e conservare ciò che si rivela un insight valido, completo di prove.
Cosa succede dopo

Descrivi il tuo processo e lascia che lo strumento lo trovi

Portiamo l'esperienza nel riconoscimento dei pattern del nostro IoT Miner nella preparazione dei dati. Descrivi in una frase di cosa trattano i tuoi dati, ad esempio "approvvigionamento, dalla richiesta d'acquisto al pagamento della fattura", e lo strumento proporrà dei candidati di processo basati sulle attività reali presenti nelle tue tabelle.
Verificato sui tuoi dati, non ipotizzato:Ogni attività proposta viene verificata rispetto ai dati reali. Le tabelle e le colonne esistono? Ci sono abbastanza righe corrispondenti? I timestamp sembrano corretti? L'attività condivide gli ID dei casi con il resto del processo?
Chiede solo quando non è sicuro:Ogni attività ha un punteggio di confidenza basato su diversi segnali; potrai perfezionare il risultato tramite una conversazione prima di trasformarlo in una pipeline eseguibile.
Impara dai tuoi esperti:Ciò che il tuo team conferma viene memorizzato, così la successiva analisi sullo stesso sistema partirà da una base migliore.
Individuazione automatica dei processi nel Data Preparation Tool, che propone attività a partire dalle proprie tabelle di database
Connessioni

Leggi dai tuoi sistemi,
scrivi dove lavori

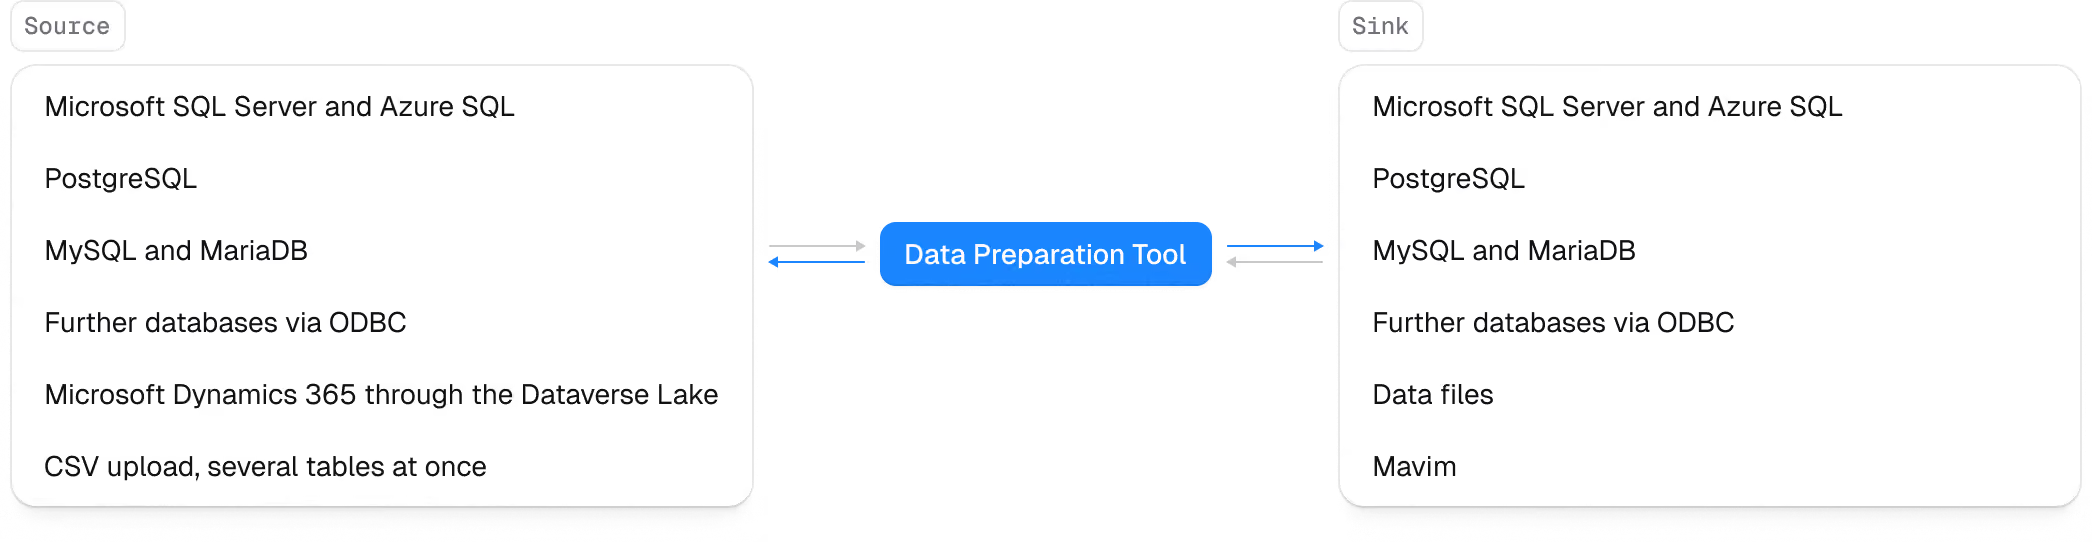
Una sorgente è il punto da cui lo strumento legge i dati, una destinazione è il punto in cui li scrive. Ogni connessione al database funziona in entrambe le direzioni.
Diagramma delle connessioni del Data Preparation Tool verso i sistemi di origine e di destinazione: database, Dynamics 365, Power BI e Process.Science Intelligence
Manca qualcosa?
La configurazione ideale

Progettato per il tuoPower BIeIntelligenza

Il Data Preparation Tool è il motore del tuo process mining. I log degli eventi che genera confluiscono direttamente nel sistema che utilizzi, senza passaggi di modellazione intermedi.

Integrazione Power BI

Le tabelle di output hanno il layout previsto dai nostri modelli di report Power BI. Il tuo registro eventi finisce nel tuo modello, accanto alle tue dimensioni esistenti, e le dashboard funzionano senza necessità di rielaborazioni per ogni progetto.
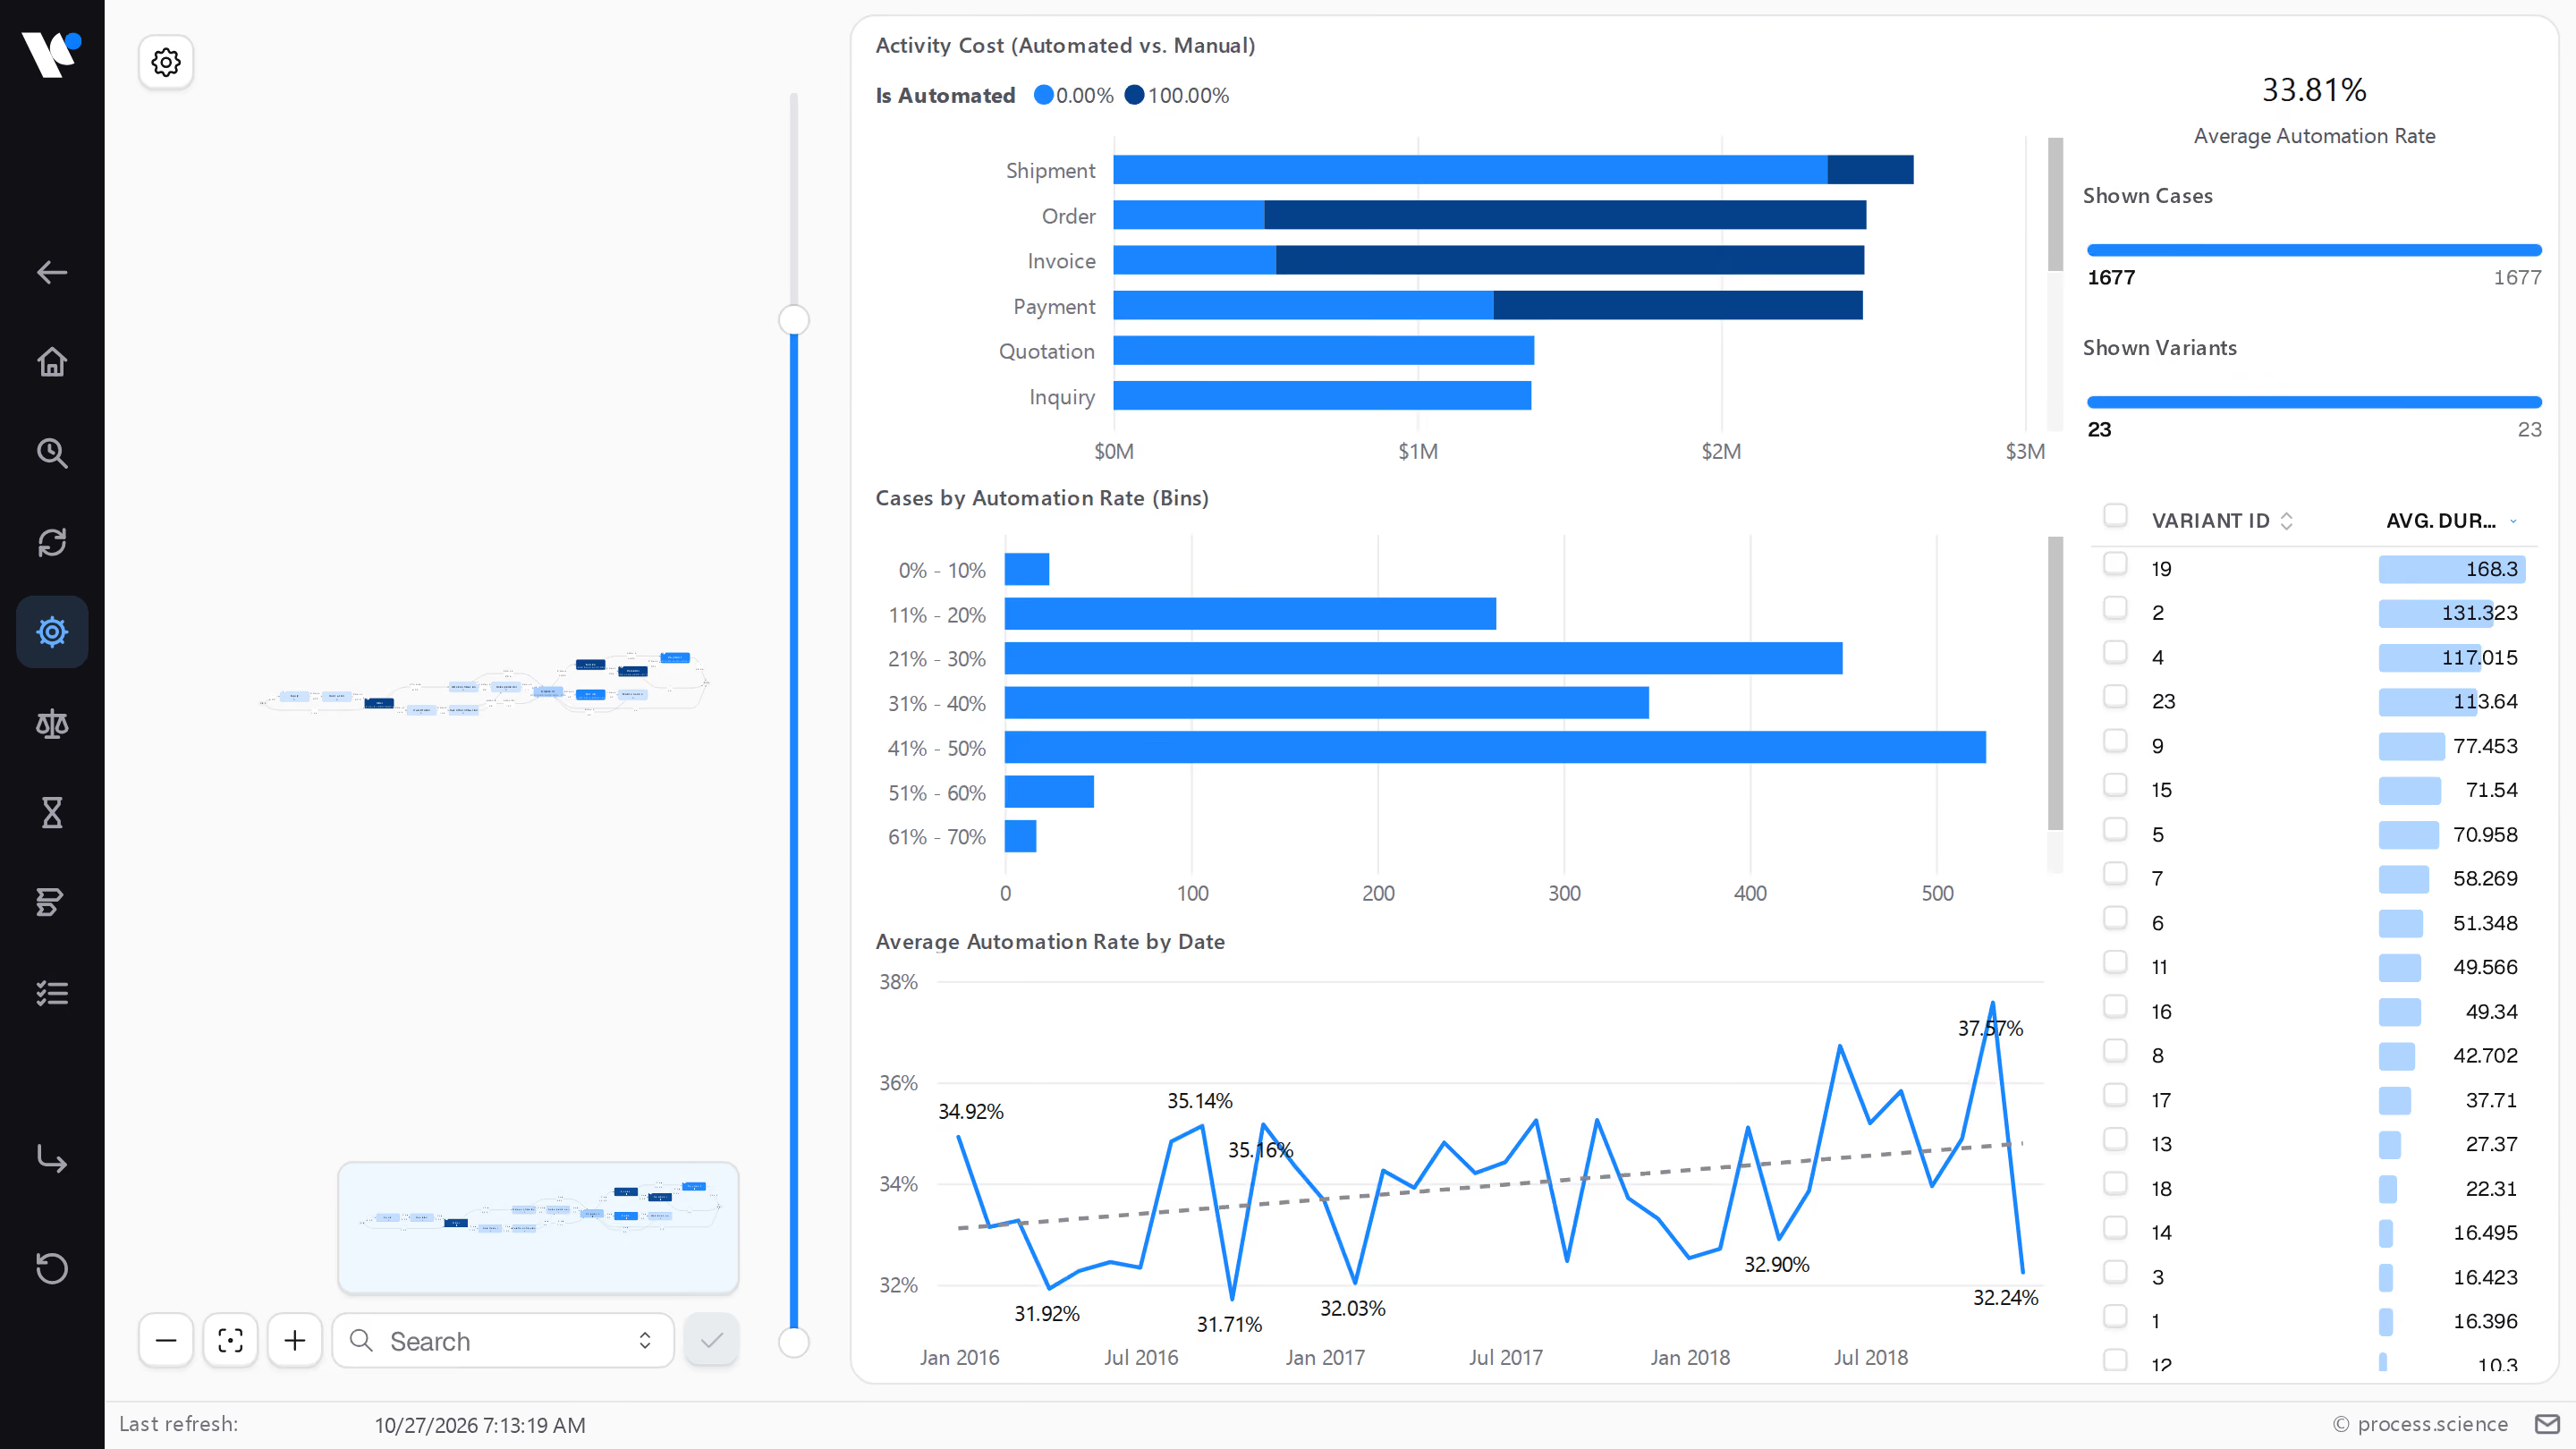
Automation rates by activity and over time in Process.Science

Process.Science Intelligence

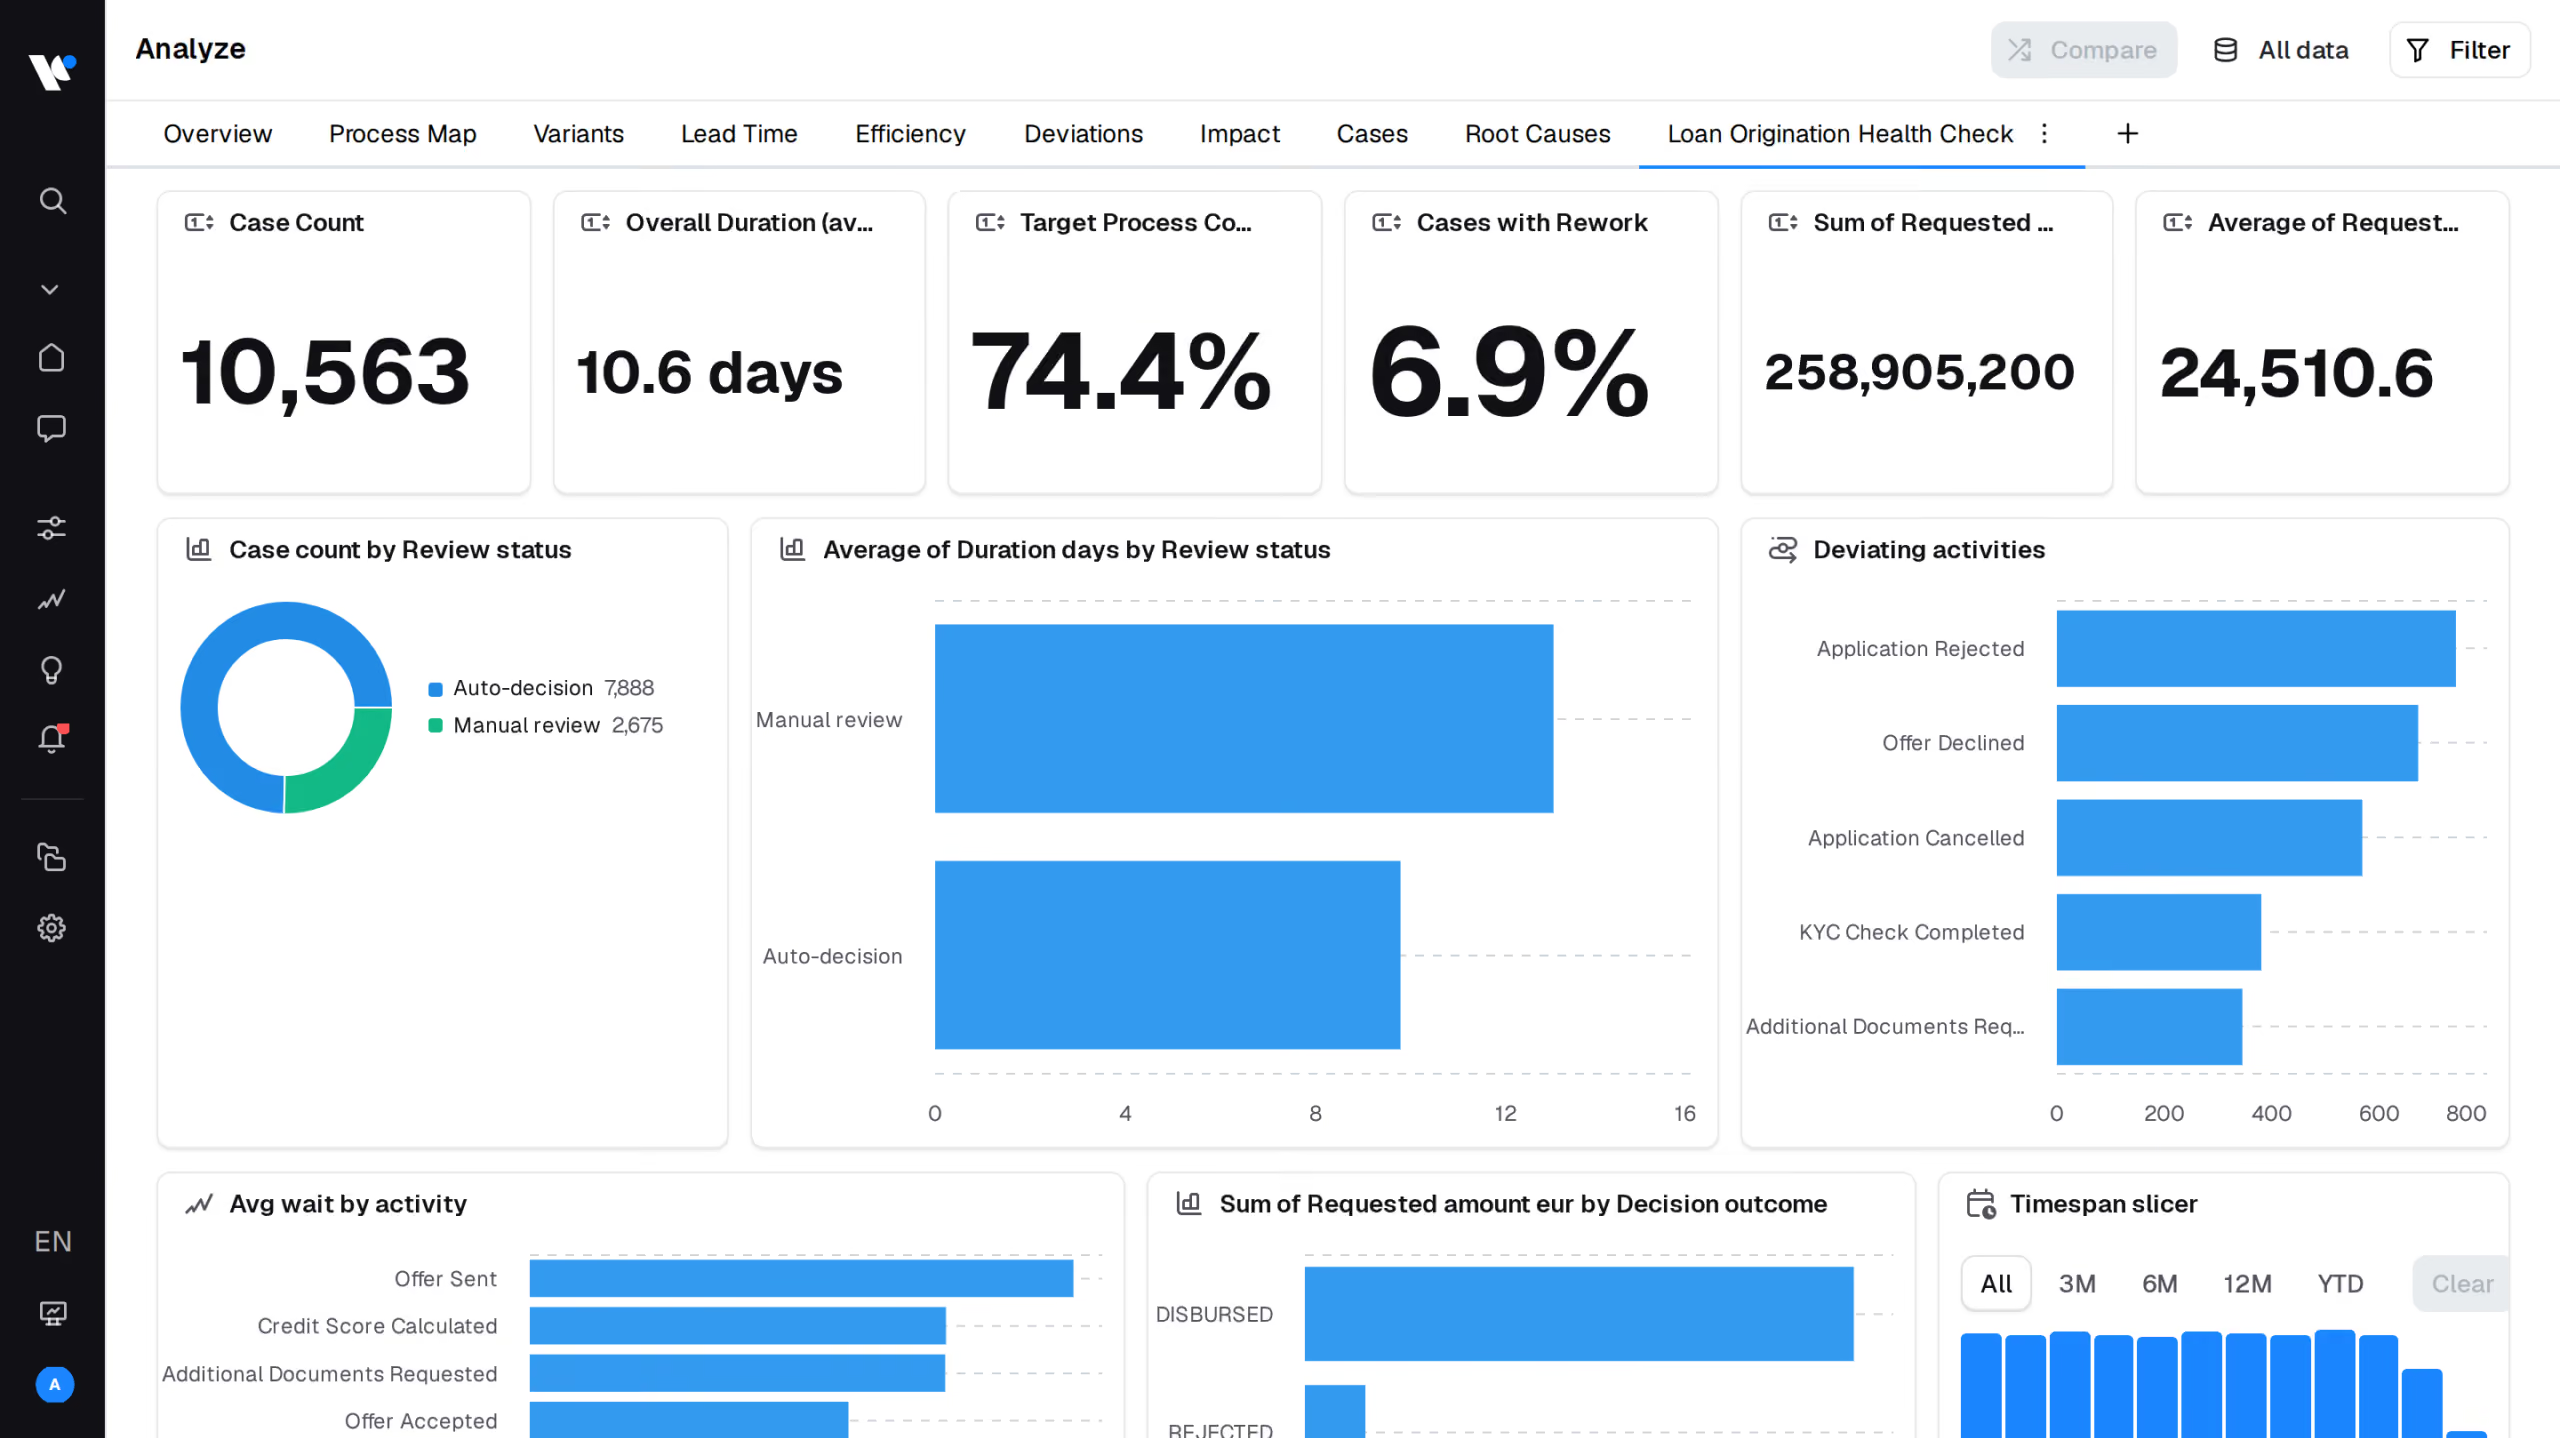
Un'esecuzione completata diventa il set di dati su cui lavorano i tuoi progetti di Intelligence, aggiornando automaticamente l'analisi. Da lì avrai a disposizione Setup, Analisi, Insight, Chat e Avvisi.
Interfaccia di Process.Science Intelligence con configurazione, analisi, approfondimenti, chat e notifiche
Inizia ora

Guarda il tuo registro eventi, non una demo

Connetti un sistema, scegli un processo e guarda cosa ne esce. Lo facciamo insieme sui tuoi dati, così il risultato è il tuo processo e non un set di dati campione.
Esegue sui tuoi sistemi e database
Modelli pronti all'uso per i tuoi processi principali
Nessun ETL scritto a mano richiesto
Inviando la richiesta, accetti la Informativa sulla privacy di Process.Science
Grazie! La tua richiesta è stata ricevuta!
Riceverai un' e-mail con un link di conferma.
Ops! Qualcosa è andato storto durante l'invio del modulo.
Altre domande?

FAQ:Tecnologia e architettura

Le risposte che gli amministratori IT e i data engineer cercano per prime
Quali sistemi sorgente sono supportati?

Microsoft SQL Server e Azure SQL, PostgreSQL, MySQL e MariaDB direttamente, altri database tramite ODBC, Microsoft Dynamics 365 attraverso l'esportazione Dataverse Lake e caricamento CSV per più tabelle contemporaneamente. SAP viene letto tramite il suo database, motivo per cui i modelli SAP funzionano indipendentemente dalla versione SAP in uso. I risultati possono essere riscritti in uno qualsiasi di questi database, forniti come file di dati o inviati a Mavim.

La preparazione dei dati deve avvenire necessariamente nel cloud?

No. Lo strumento legge e scrive direttamente sui tuoi database, quindi i dati rimangono nell'ambiente in cui operi. Password e token di accesso sono archiviati in modo crittografato, l'accesso è organizzato per area di lavoro e le esecuzioni si scalano su più worker quando i volumi aumentano.

Lo strumento sostituisce Power Query?

Non è uno strumento ETL generico e non cerca di esserlo. Power Query e strumenti simili spostano e rimodellano i dati senza sapere cosa sia un processo. Il Data Preparation Tool è costruito per un unico scopo: trasformare le tabelle operative in un registro eventi, con attività, casi, varianti e dati anagrafici già pronti. Puoi continuare a usare Power Query per tutto il resto.

Quanto tempo richiede il primo registro eventi?

Una volta stabilita la connessione e scelto il modello, la prima esecuzione richiede pochi minuti anziché settimane, perché il lavoro di mappatura è già stato fatto. Ciò che richiede tempo è concordare quali attività appartengono al tuo processo, e questa è una discussione da fare con il tuo team, non un compito di ingegneria dei dati.

Cosa succede quando il nostro sistema sorgente cambia?

Un modello è un insieme di passaggi SQL che puoi leggere e modificare. Se un campo viene spostato o una tabella viene rinominata, ti basta modificare quel passaggio invece di ricostruire l'intera pipeline. Ogni esecuzione viene registrata con conteggi di eventi e durate per attività, quindi una modifica alla fonte si riflette come una variazione nei numeri.

Possiamo creare un processo che non è presente nel catalogo?

Sì. Puoi partire da un modello e aggiungere le tue attività e i passaggi di preparazione, oppure creare un processo personalizzato da zero. In entrambi i casi, l'output ha la stessa struttura di qualsiasi altro registro eventi, così i tuoi report continueranno a funzionare.