Sáltate la parte más difícilde Process Mining

La herramienta de preparación de datos de Process.Science convierte los datos sin procesar de SAP, Microsoft Dynamics 365 y sus propias bases de datos en registros de eventos listos para el análisis. Sin proyectos de ingeniería de datos, sin ETL escrito a mano. Elija un proceso predefinido, conecte su sistema y cada ejecución programada entregará un registro de eventos completo a Power BI o a Process.Science Intelligence.

Todo lo previo al análisis,ya resuelto

Rápida de configurar, flexible con tus sistemas y rigurosa con la calidad de los registros de eventos, porque todo lo que analices después depende de ellos.
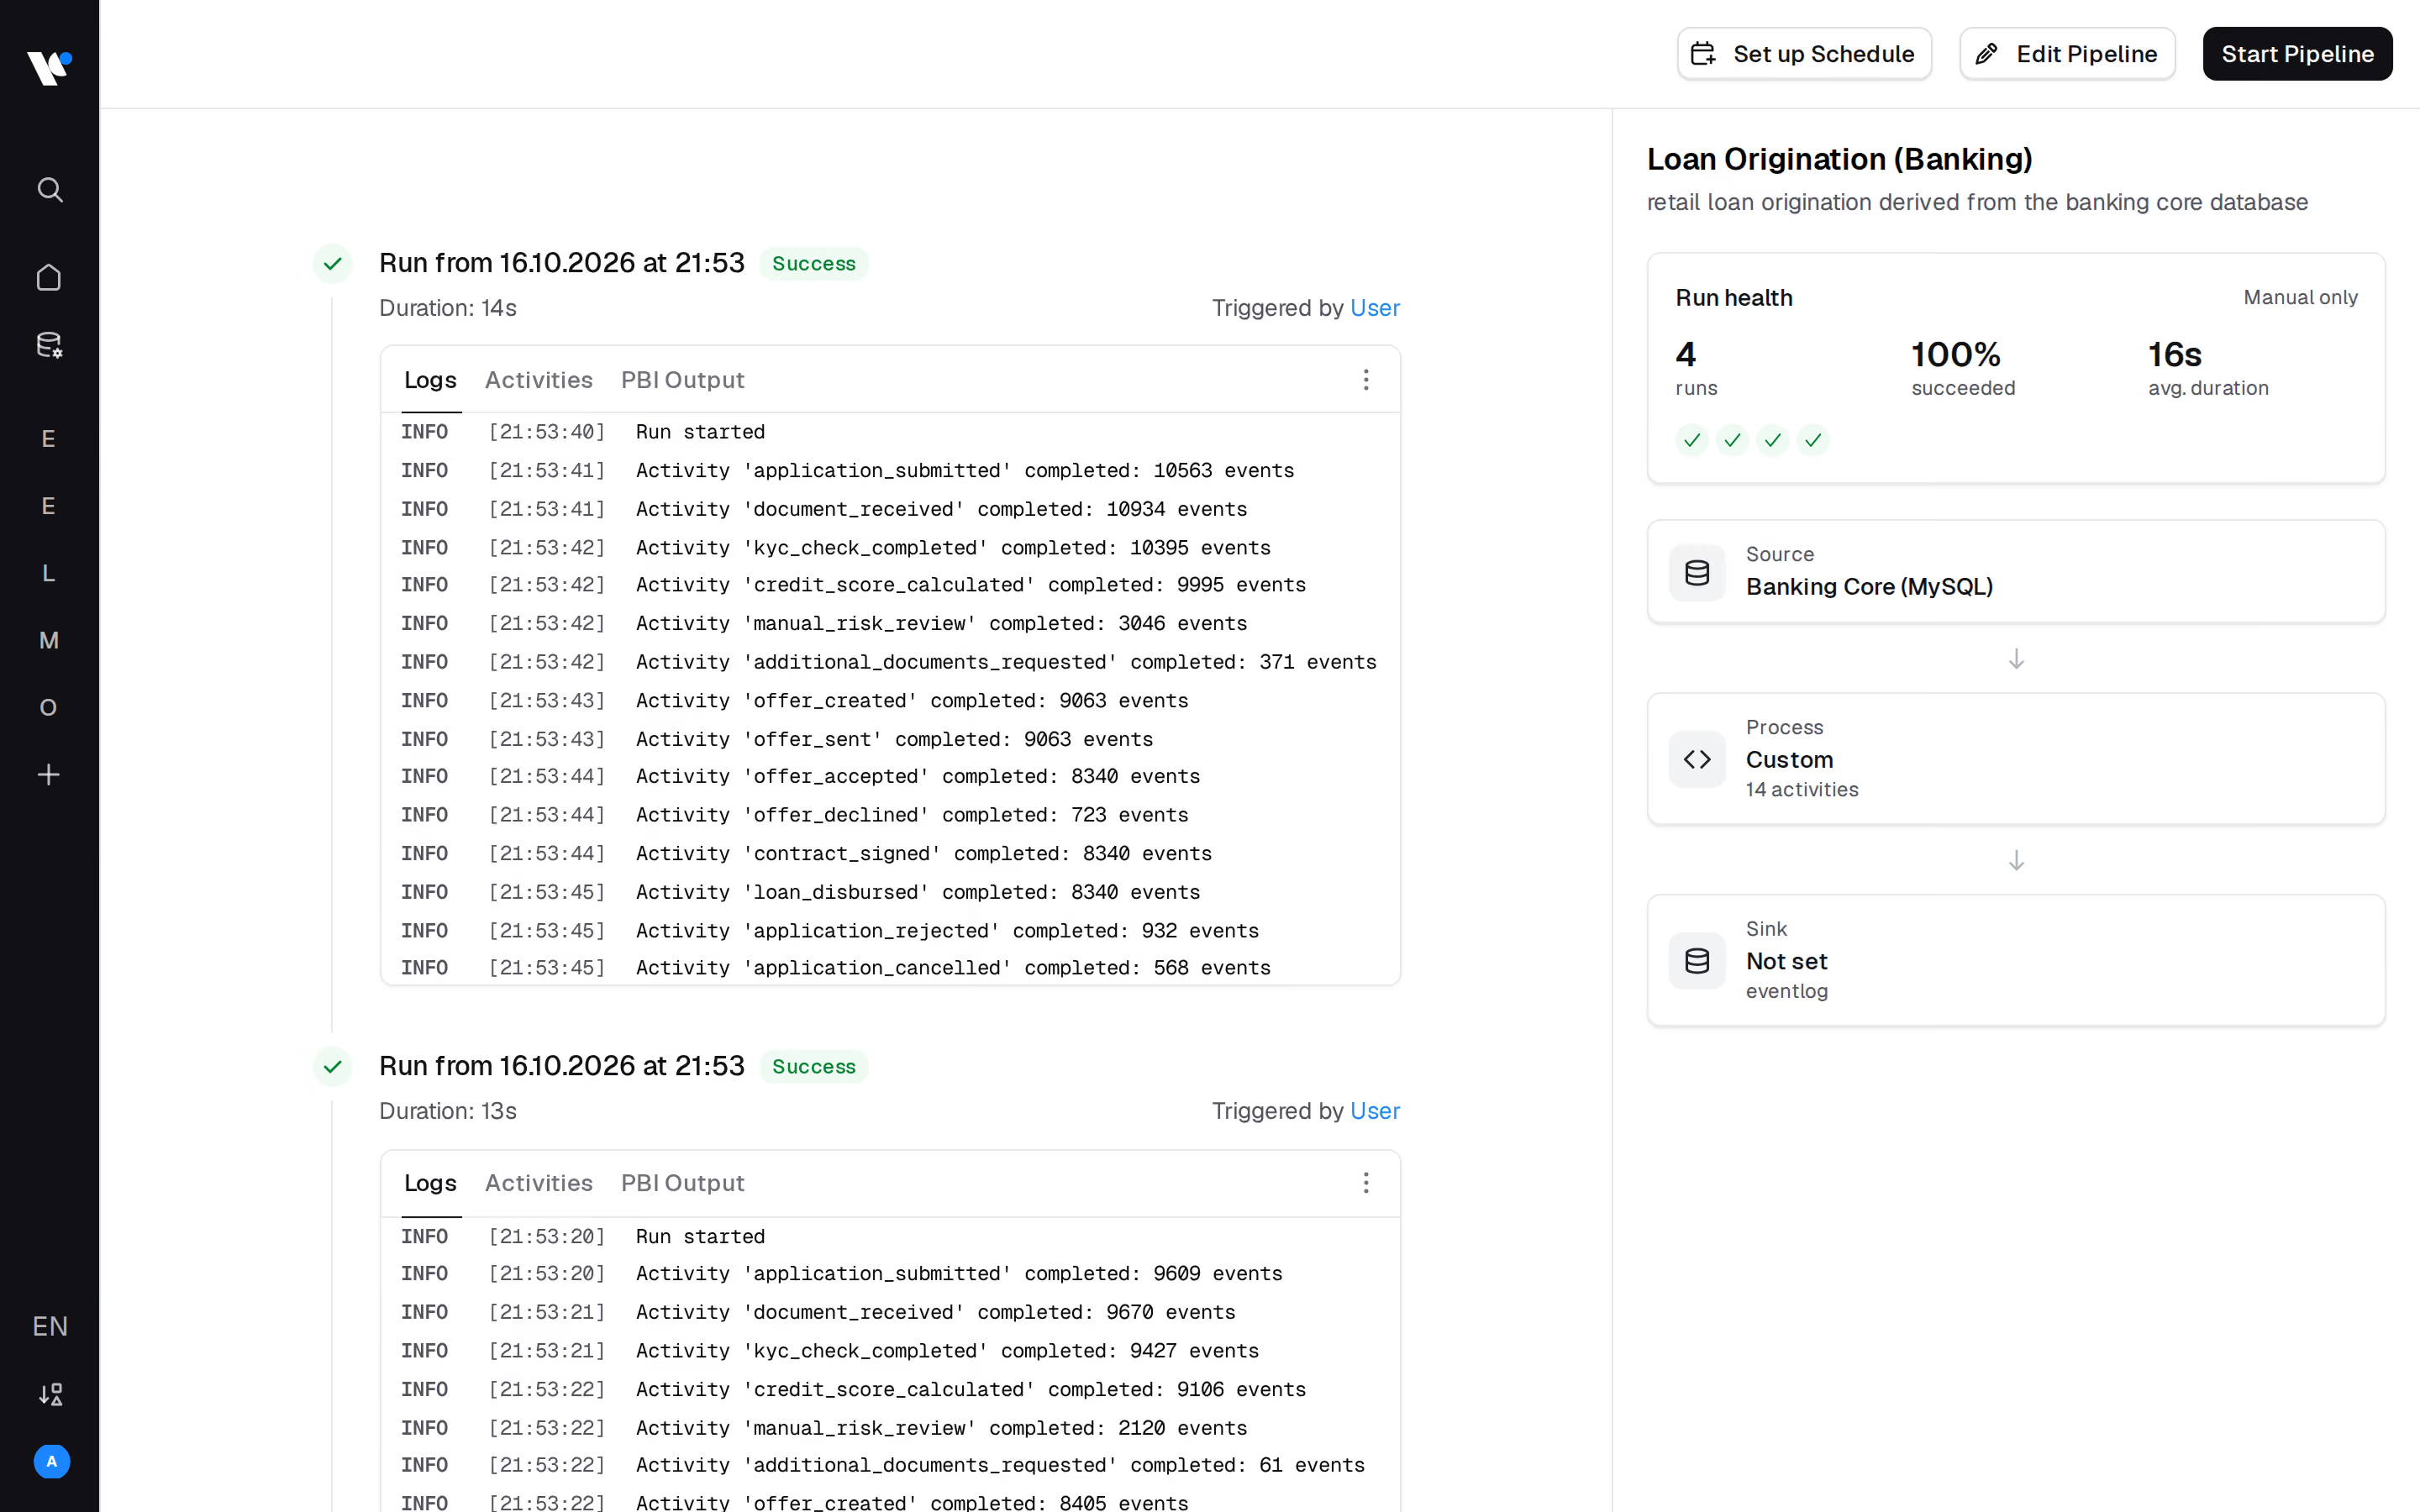
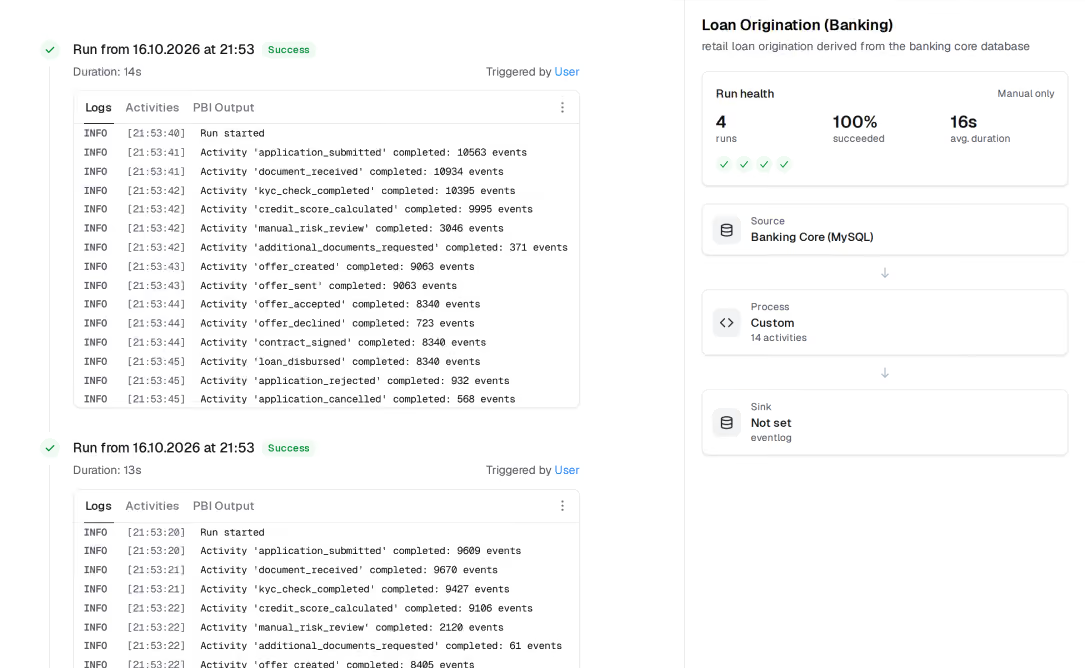
Página de resumen de un pipeline Purchase-to-Pay en el Data Preparation Tool, con el historial de ejecuciones y las actividades
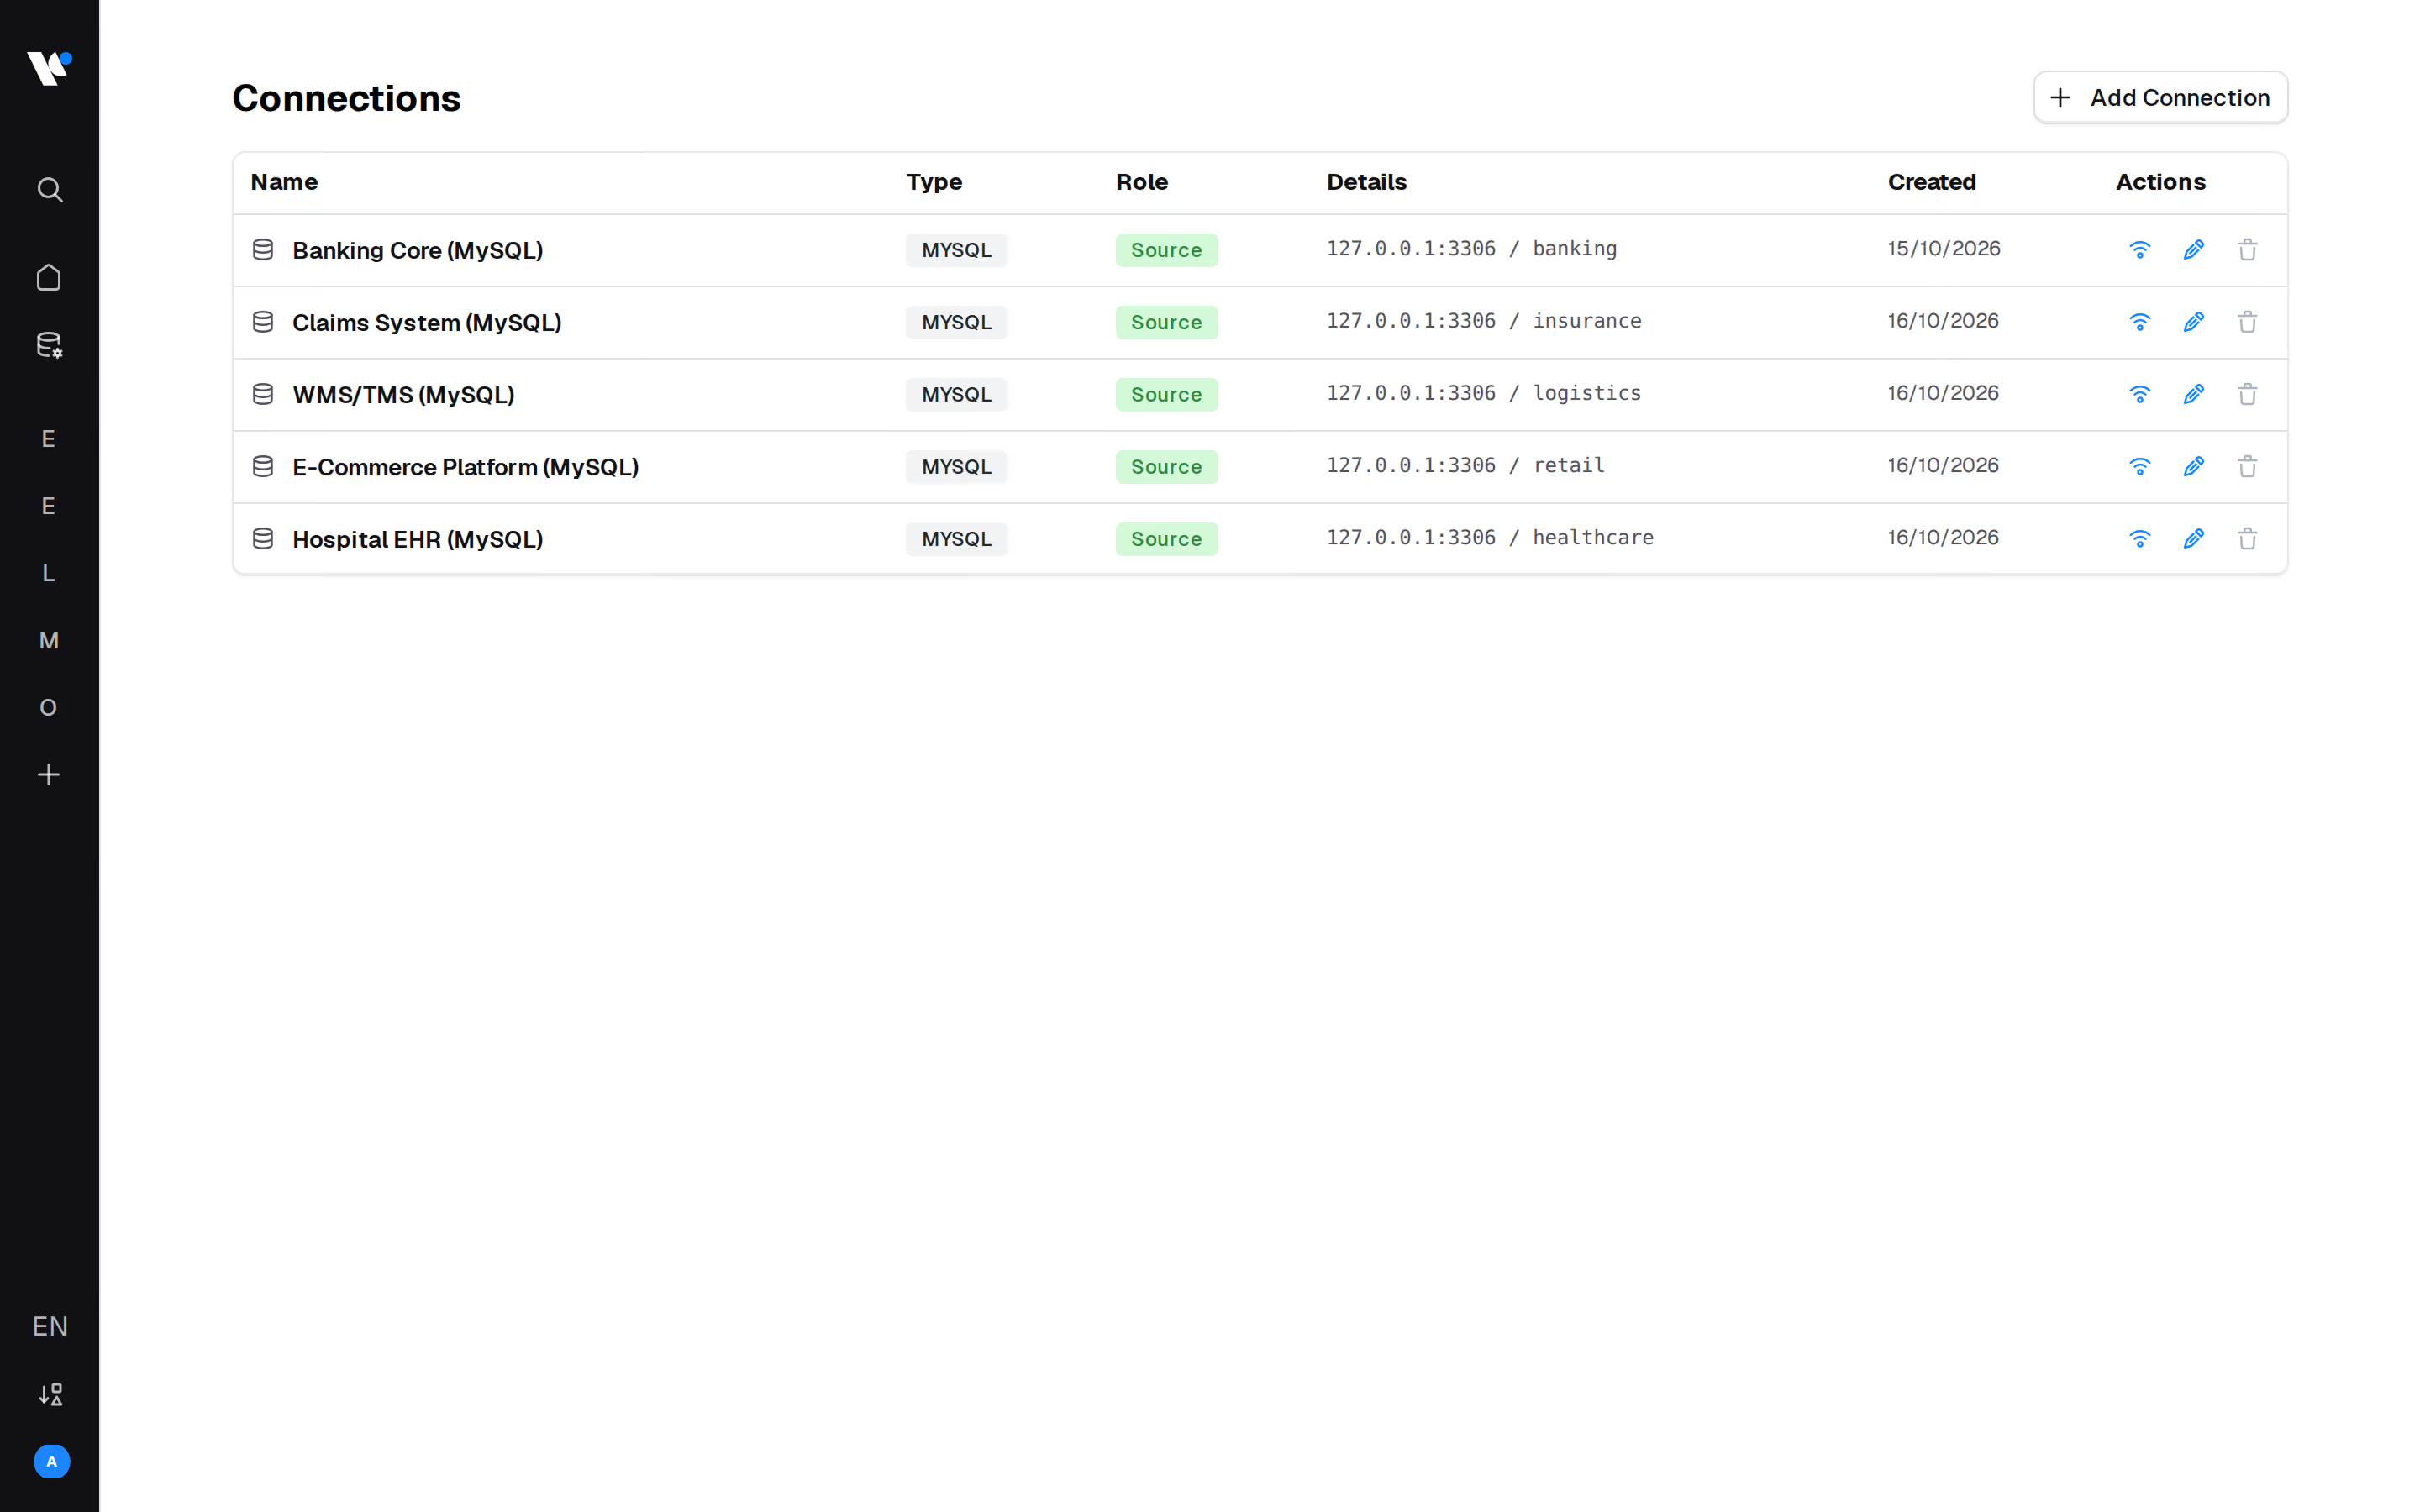
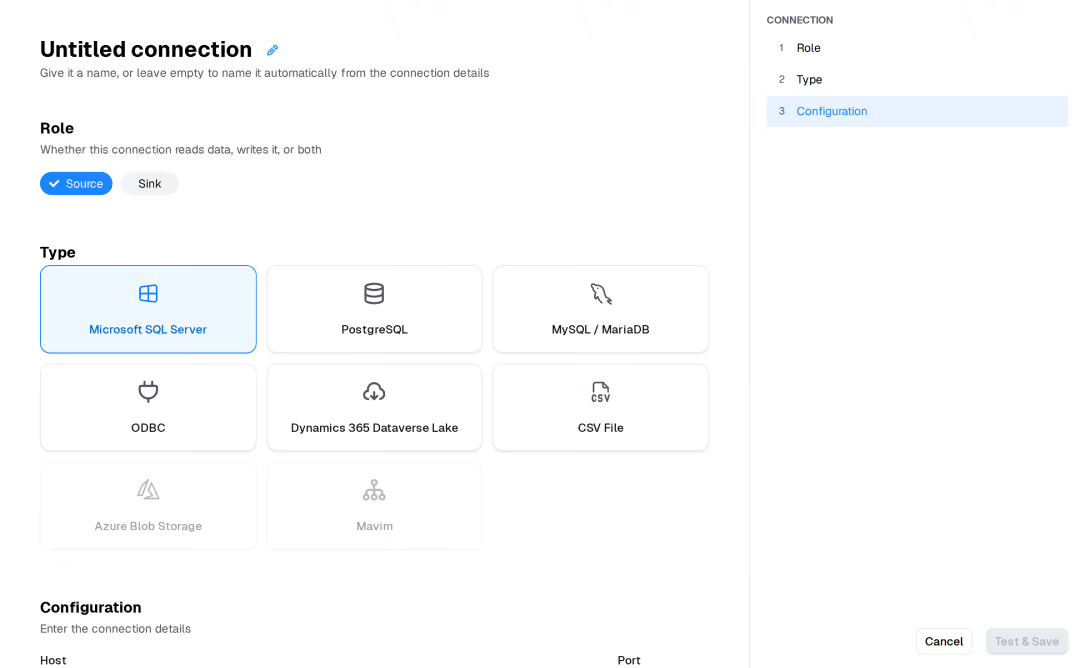
Vista general de las conexiones configuradas a los sistemas de origen y destino en el Data Preparation Tool
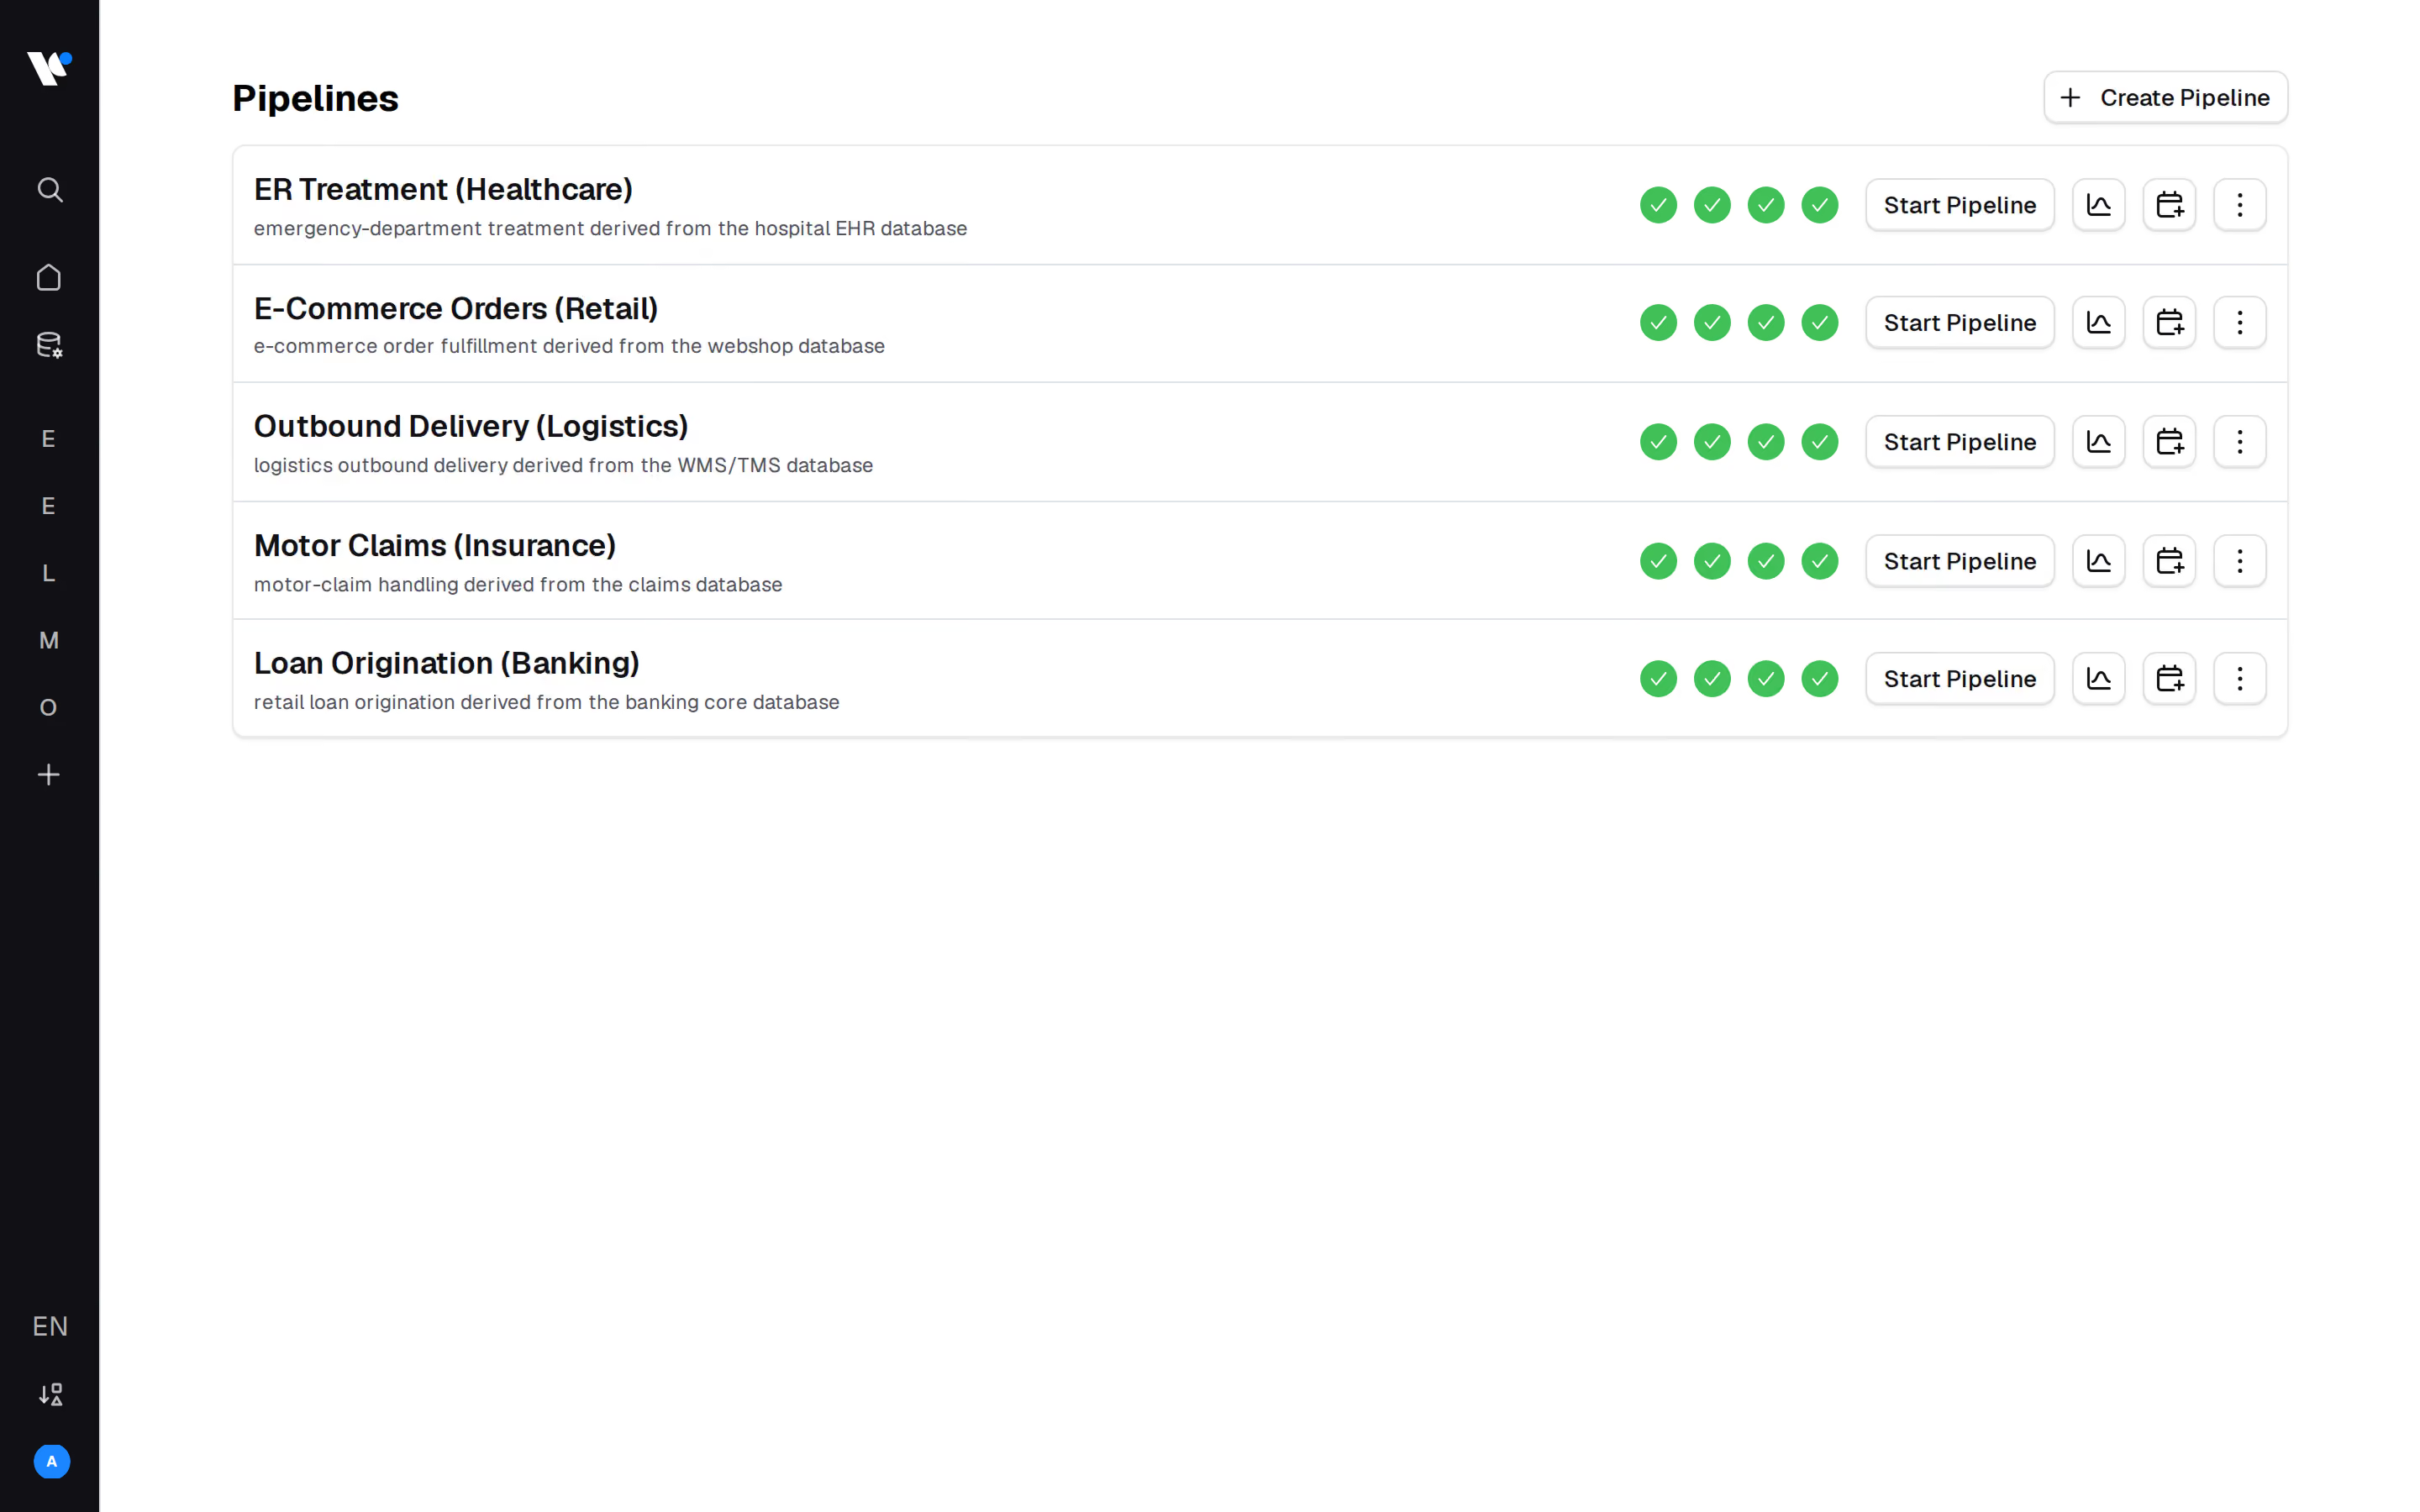
Vista general de los pipelines configurados en el Data Preparation Tool
Formulario de creación de un nuevo pipeline en el Data Preparation Tool, con selección de procesos predefinidos
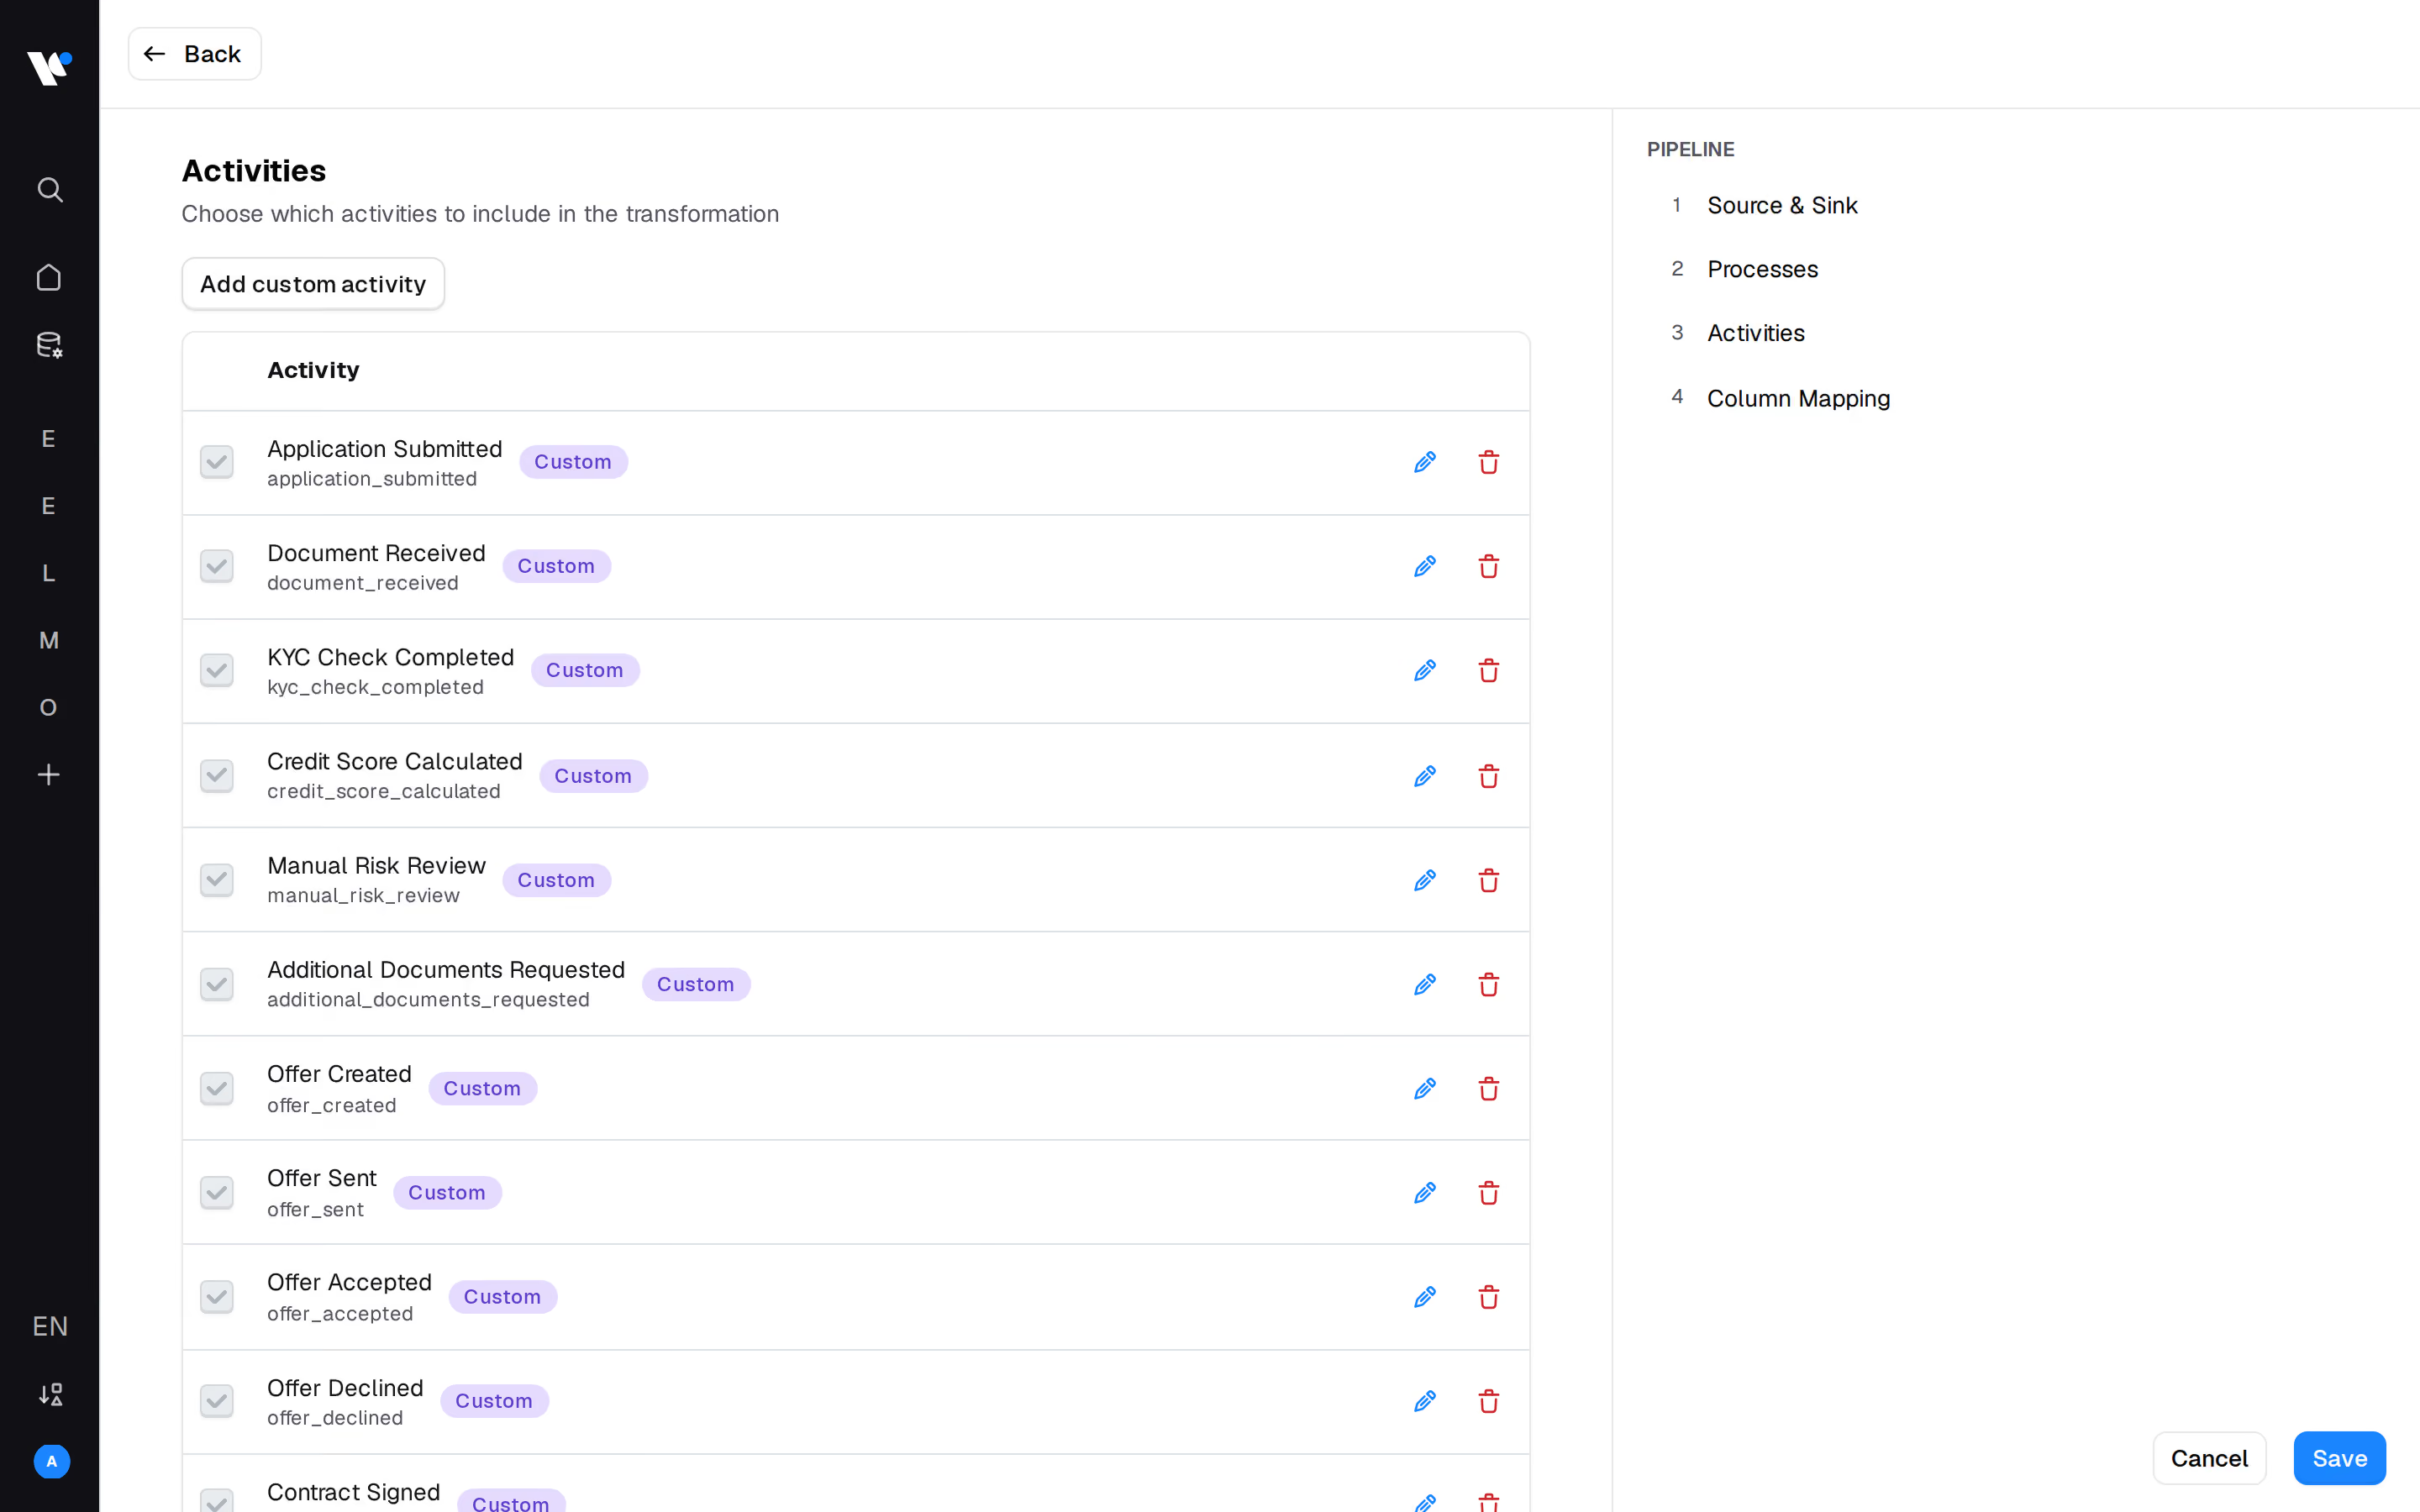
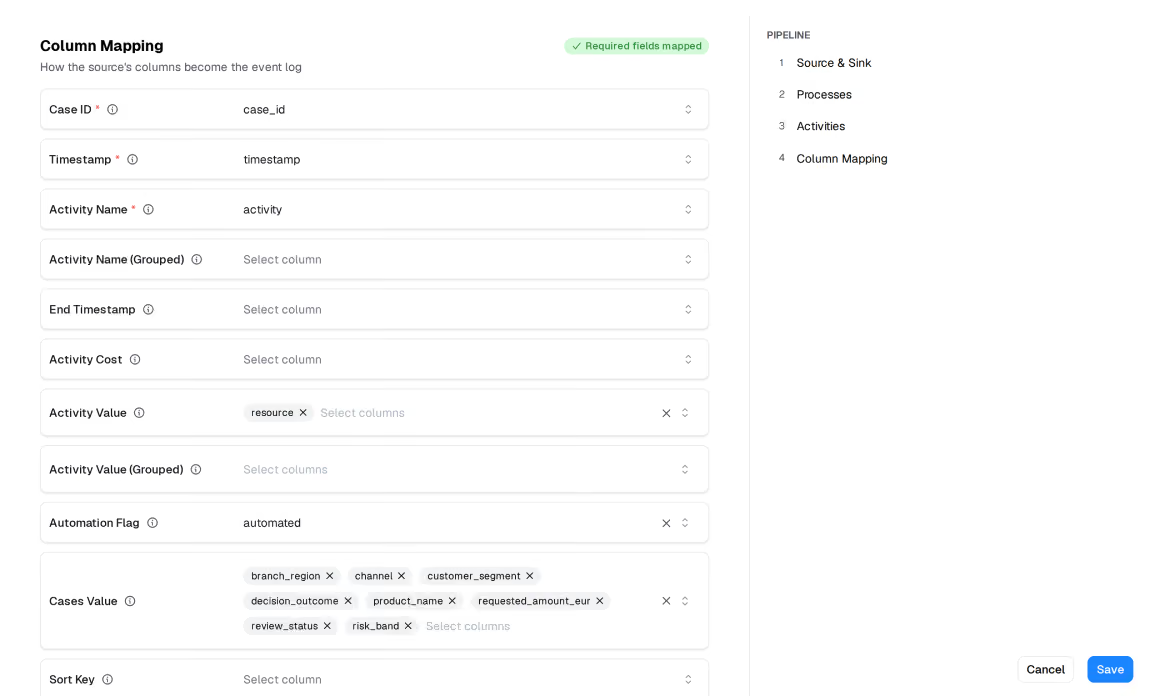
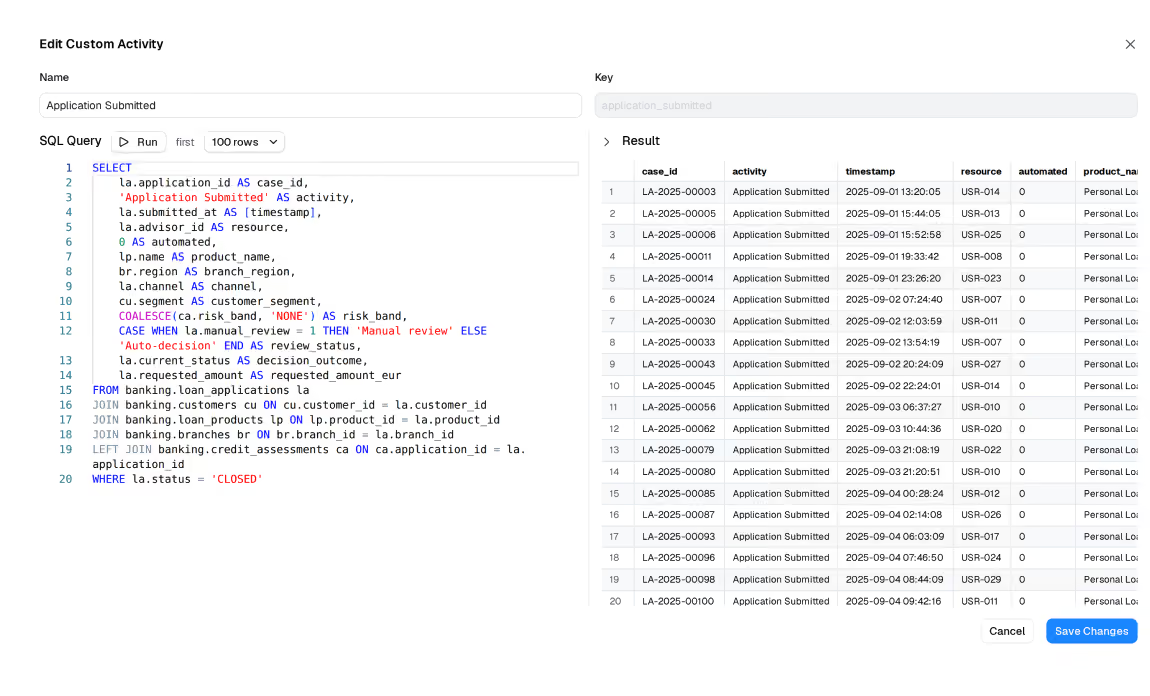
User interface displaying a list of custom activities to include in a transformation, with checkboxes marked for each: Application Submitted, Document Received, KYC Check Completed, Credit Score Calculated, Manual Risk Review, Additional Documents Requested, Offer Created, Offer Sent, Offer Accepted, Offer Declined, and Contract Signed. Each activity has an edit and delete icon. On the right, a pipeline navigation with steps: Source & Sink, Processes, Activities, and Column Mapping. Buttons for Back, Cancel, and Save are visible.

El problema del 80/20, invertido

En la mayoría de los proyectos de minería de procesos, la mayor parte del esfuerzo se dedica a buscar y preparar los datos. Las plantillas y el enriquecimiento automático trasladan ese trabajo al inicio del proyecto, donde se realiza una sola vez.

El laberinto de sistemas, ya mapeado

Los sistemas ERP, CRM e ITSM contienen decenas de miles de tablas. Hemos descodificado las relevantes para los procesos con los que la mayoría de las empresas comienzan, para que nadie tenga que averiguar qué campo contiene la marca de tiempo.

Más que solo casos, actividades y marcas de tiempo

Un registro de eventos básico no es suficiente. Cada ejecución llega enriquecida con datos maestros, duraciones, variantes, costes e indicadores de automatización, para que el análisis pueda comenzar en lugar del modelado.
La fórmula de Process.Science

Menos ingeniería de datos,más análisis de procesos

Scripts SQL manuales

Funciona hasta que el sistema de origen cambia. Es difícil de documentar, difícil de transferir y una actualización de esquema puede romper toda la lógica.

Suites ETL pesadas

Creados para el almacenamiento de datos, no para la minería de procesos. Mueven los datos de forma fiable, pero no saben qué es una actividad, un caso o una variante.

Herramienta de preparación de datos de Process.Science

Diseñado para una sola tarea: convertir datos operativos en registros de eventos. Conoce los procesos, los enriquece con datos maestros y ofrece la misma estructura de salida para cada proceso y cada sistema de origen.
¿Listo para el análisis? Elija el sistema de destino:

Tres pasos desde los datos sin procesarhasta un registro de eventos finalizado

Conecte su sistema, elija su proceso y prográmelo. A partir de ahí, cada ejecución entrega el mismo registro de eventos completo.

01. Conecte

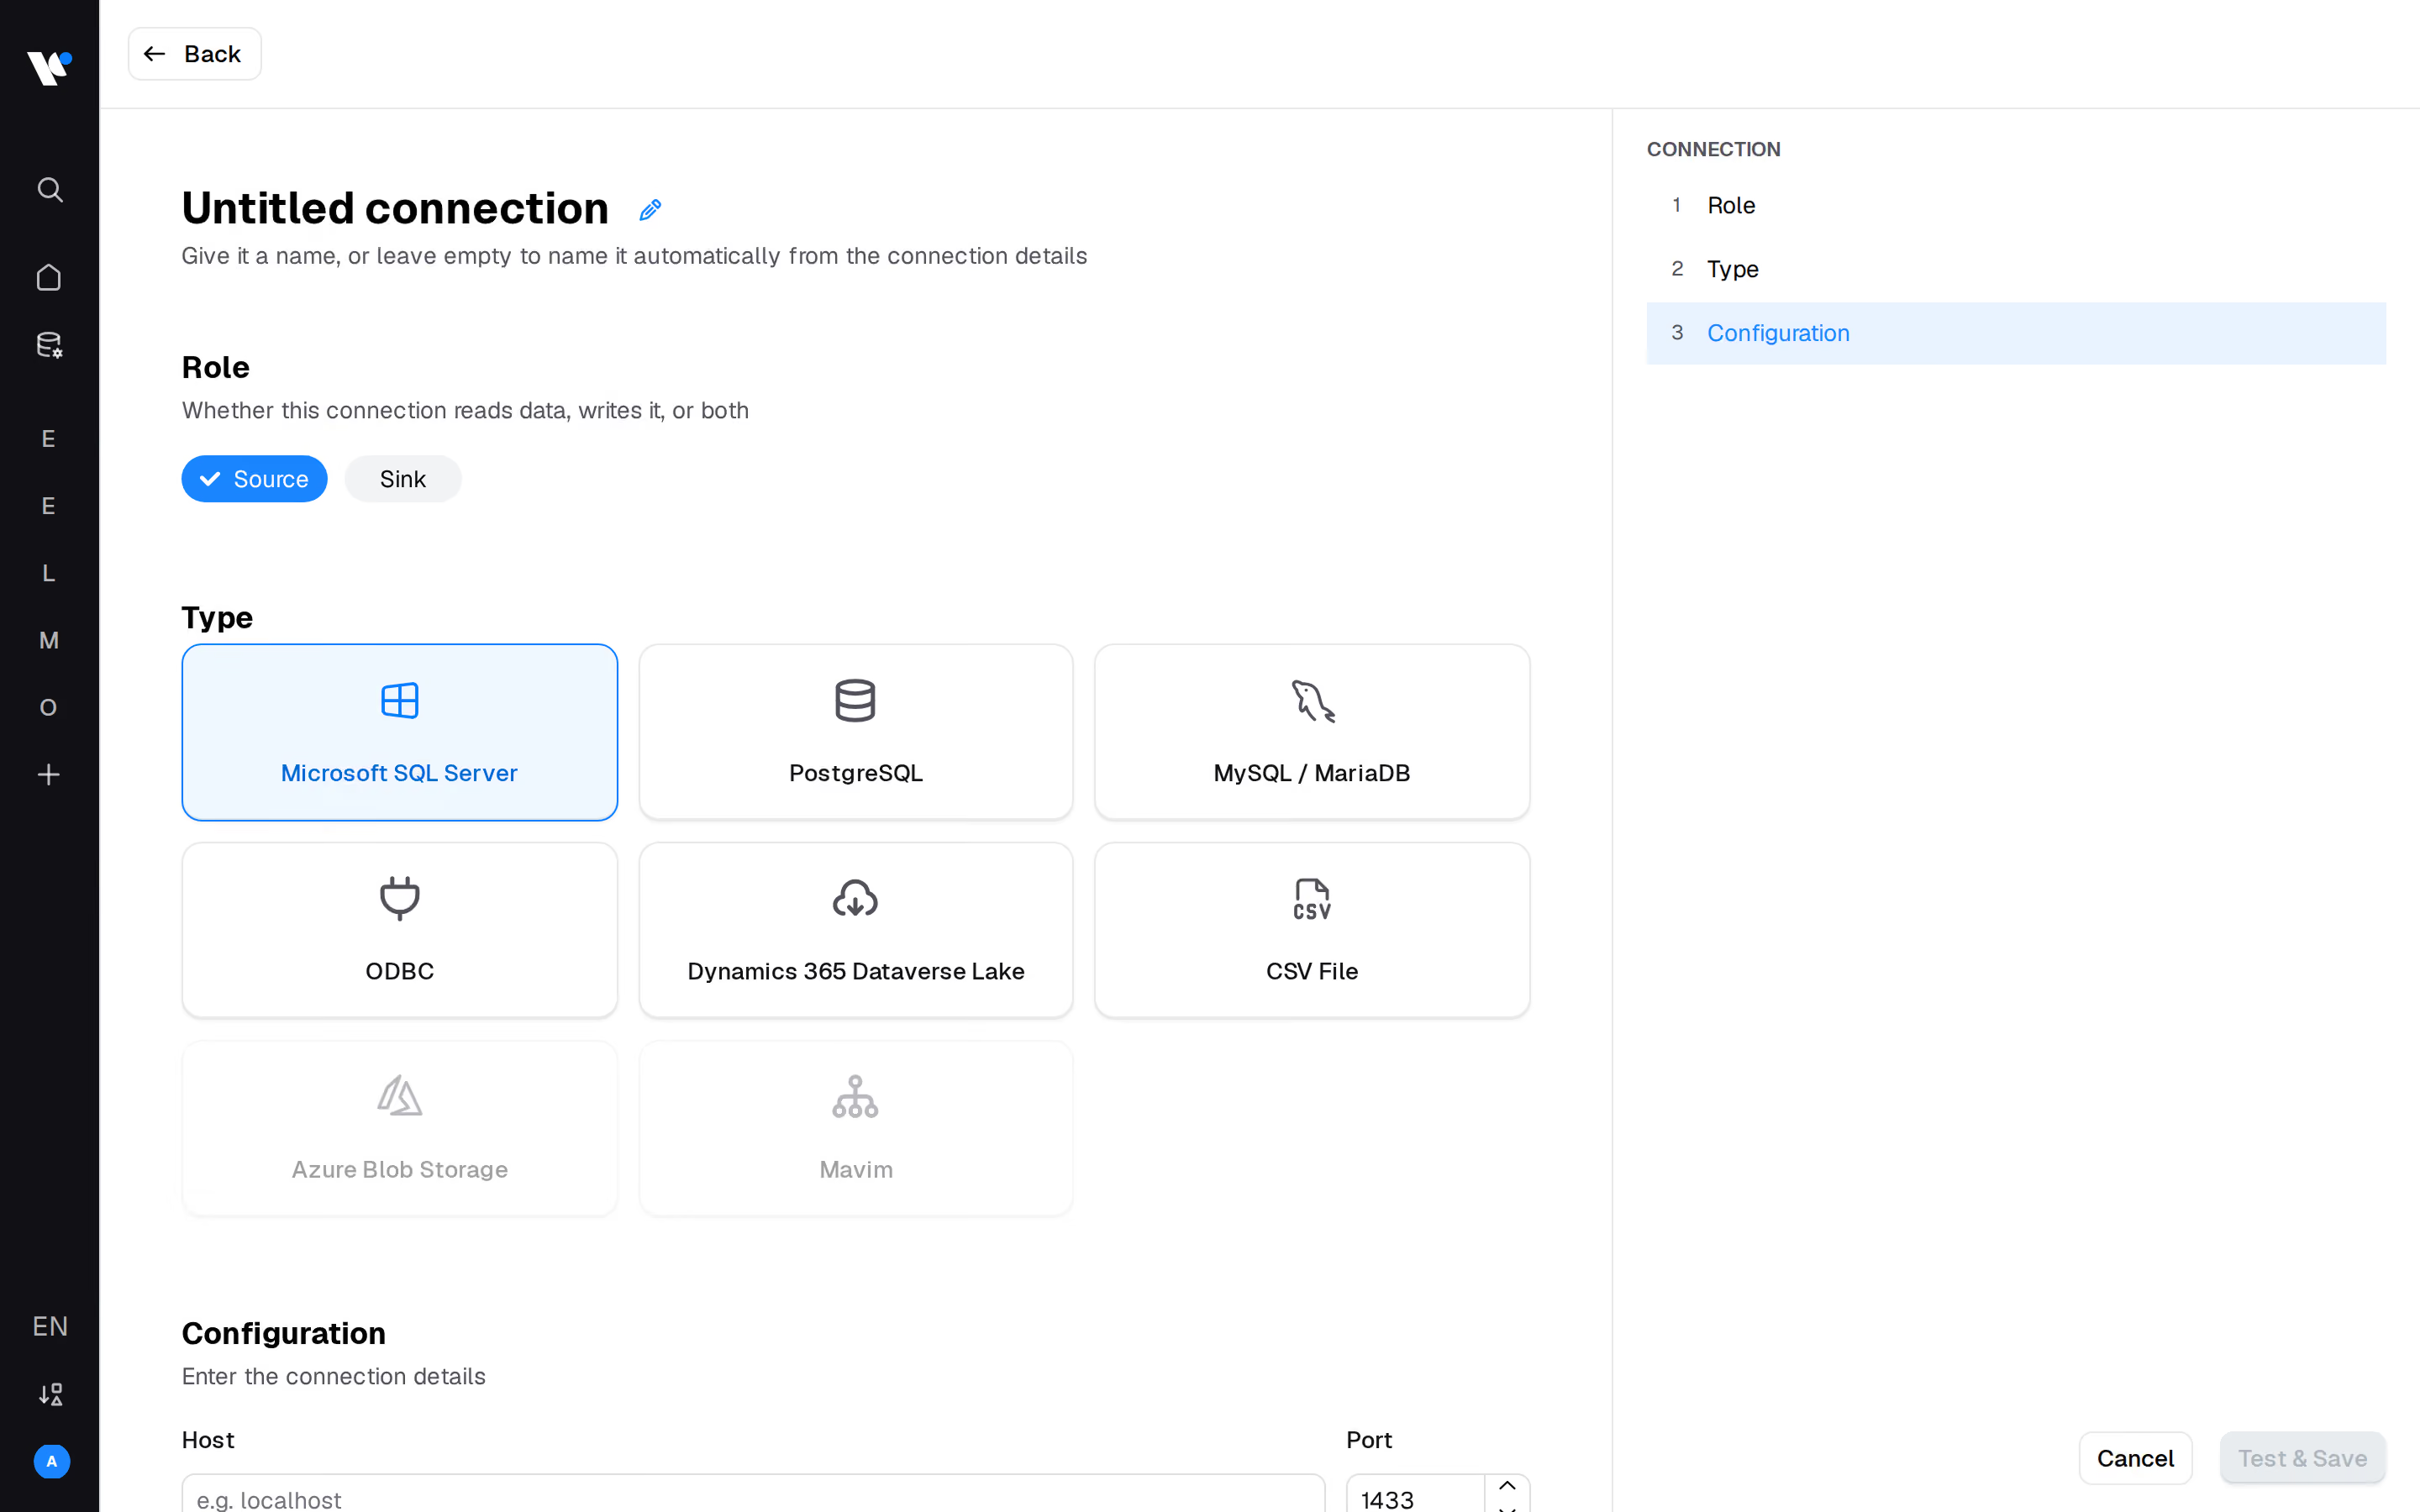
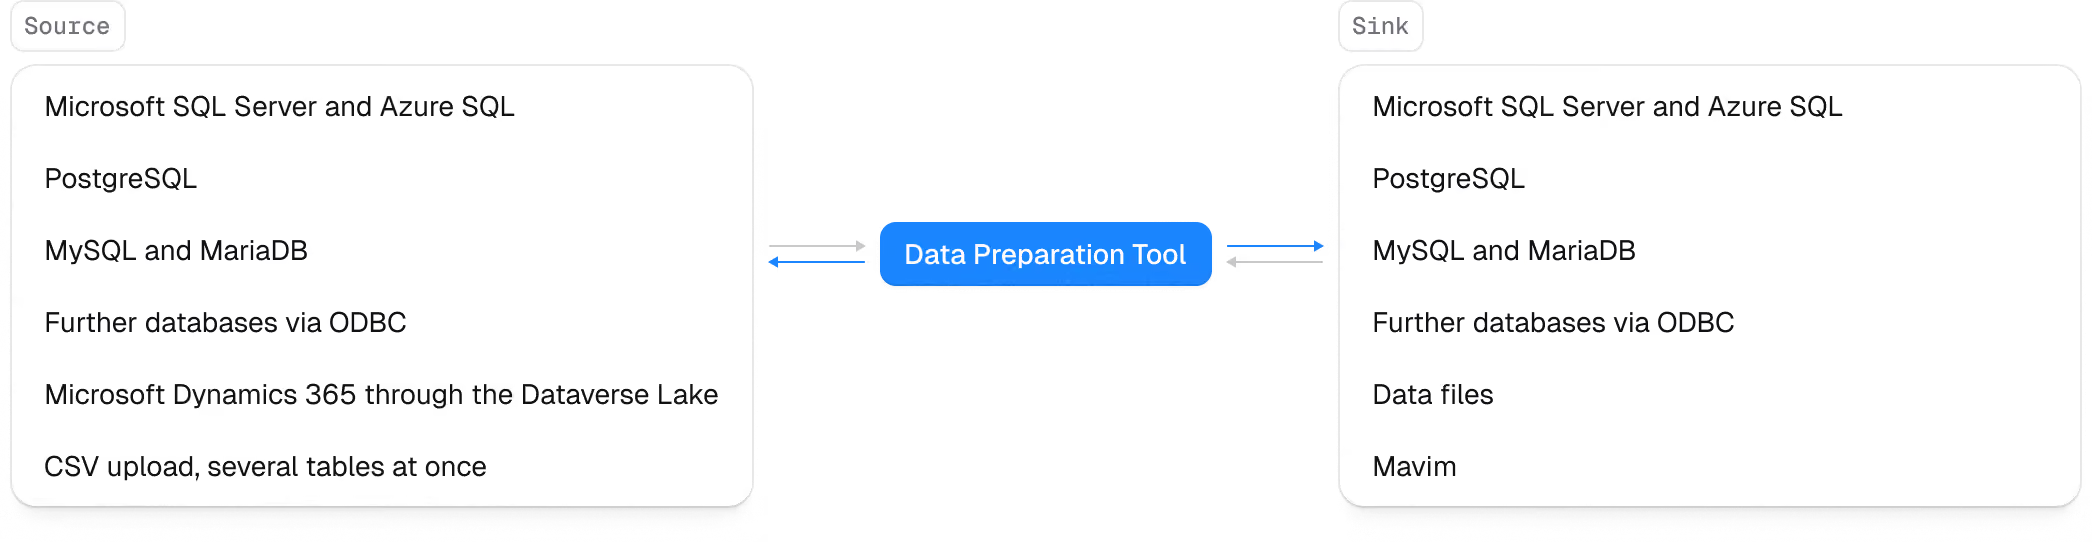
Elija su sistema: Microsoft SQL Server o Azure SQL, PostgreSQL, MySQL o MariaDB, Microsoft Dynamics 365 o una simple carga de CSV. Introduzca los detalles de conexión, pruébelos y guárdelos, luego elija a dónde deben ir los resultados.

02. Elija su proceso

Empiece con una plantilla ya preparada, como SAP Purchase-to-Pay, y seleccione las actividades que le interesan. Las plantillas ya saben qué columnas contienen el caso, la actividad y el tiempo.

03. Ejecútelo o prográmelo

Inicie la canalización una vez, o ejecútela cada hora, día, semana, mes o mediante su propia expresión cron. También puede activar una ejecución desde sus propias herramientas a través de la API.
Configuración inmediata

Plantillas probadas, abiertas hasta la última línea de SQL

No empiece desde cero. Hemos descodificado las estructuras de tablas de los sistemas con los que empiezan la mayoría de las empresas, y cada plantilla es suya para que pueda modificarla.
Listos para sus procesos principales:SAP P2P, desde la solicitud de pedido hasta la compensación de facturas. SAP O2C, desde la cotización hasta la facturación y el pago. Microsoft Dynamics 365 P2P y O2C. Para SAP P2P también existe una variante centrada en objetos, que cubre solicitudes, pedidos, entradas de mercancías y facturas, así como la relación entre ellos.
Nada está bloqueado:Active o desactive actividades, edite el SQL detrás de cada una, añada sus propias actividades y pasos de preparación, y adapte todo a su sistema con parámetros. Si su proceso no está en el catálogo, créelo desde cero.
Escrito una vez, funciona en todas partes:Una plantilla se escribe una vez y se ejecuta en todas las bases de datos compatibles, porque la herramienta traduce el SQL al dialecto de cada sistema.
Catálogo de plantillas del Data Preparation Tool con procesos listos para usar de SAP Purchase-to-Pay y Dynamics 365
Registro de eventos enriquecido del Data Preparation Tool, con caso, actividad y marca de tiempo, además de tiempo de ciclo, variante y costes
Lo que obtiene

Un registro de eventos listo para analizar

Un registro de eventos típico tiene tres columnas: caso, actividad, marca de tiempo. Ahí es donde empieza el nuestro.
Enriquecido, no básico:Cada caso llega con su tiempo de procesamiento, variante, bucles, coste y tasa de automatización. Cada paso incluye su duración, tiempo de espera y marcador de reprocesamiento. Los atributos del caso, como el proveedor, la planta o las condiciones de pago, se incluyen junto con él y los filtros de variantes se calculan de antemano.
Dos niveles de zoom, dos idiomas:Cambie entre la vista detallada ("Registrar entrada de mercancías") y la vista de gestión ("Entrada de mercancías y facturas").
Una estructura para cada proceso:Purchase-to-Pay, Order-to-Cash o un proceso propio, desde SAP, Dynamics o cualquier base de datos: las tablas de salida tienen siempre el mismo diseño. Los informes y paneles funcionan en todos ellos sin necesidad de rehacer el trabajo por proyecto.
Garantía de calidad automatizada

Nada inacabado llega a sus informes

Los datos erróneos no se anuncian, simplemente distorsionan el panel de control. La herramienta de preparación de datos es el guardián de su análisis.
Completo o nada:Un nuevo registro de eventos se activa con un solo interruptor, solo cuando está completo. Su análisis nunca lee un registro a medio escribir y una ejecución fallida deja intacta la versión anterior. Las tablas obsoletas se eliminan automáticamente.
Robusto por diseño:Si una actividad falla, recibe una advertencia y aun así obtiene todo lo demás, en lugar de perder la ejecución completa.
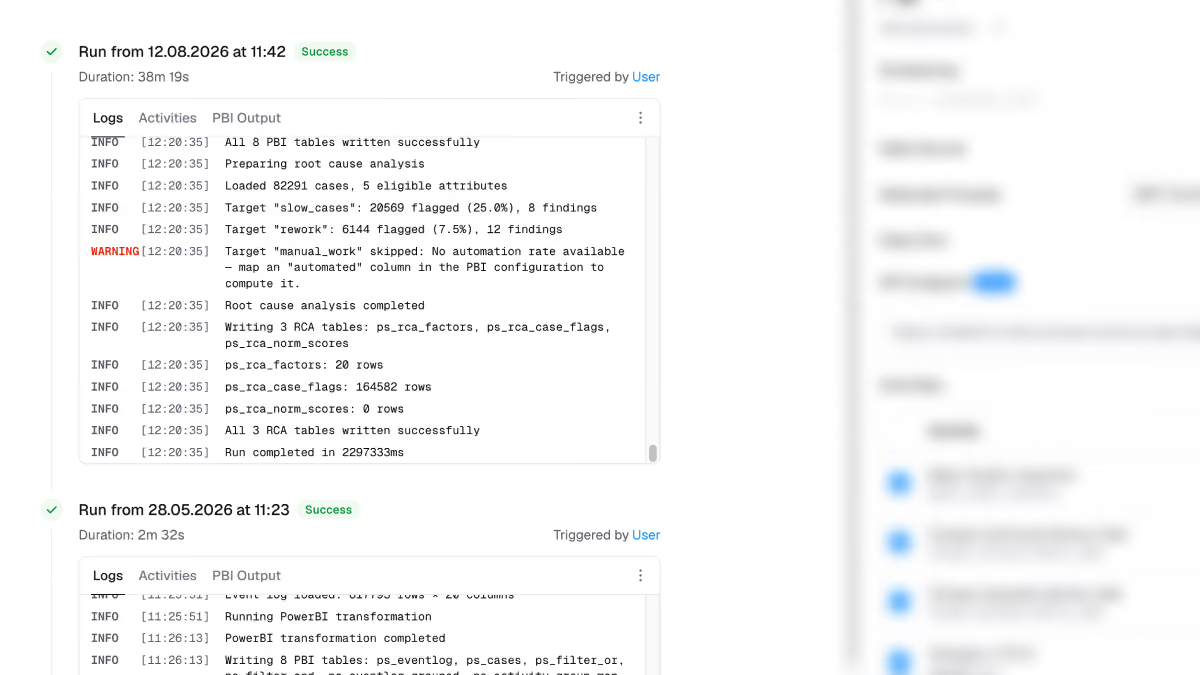
Cada ejecución es trazable:Historial completo de ejecuciones y registros, con recuentos de eventos y duraciones por actividad, para que pueda ver qué produjo una ejecución y qué ha cambiado desde la última.
Control de calidad en el Data Preparation Tool que valida un registro de eventos antes de su publicación
Historial de ejecuciones en el Data Preparation Tool con el número de eventos y la duración por actividad
Integrado en cada ejecución

Cada registro de eventos llega con un primer hallazgo adjunto

Mientras la herramienta prepara sus datos, ya identifica qué casos se comportan de forma diferente. Los señala y nombra los factores que tienen en común.
Casos problemáticos, marcados automáticamente:Casos lentos por encima de su objetivo o el cuartil más lento, casos que contienen bucles de retrabajo, casos con una baja tasa de automatización y violaciones de las normas de proceso en cinco tipos de reglas, incluyendo una norma predeterminada para SAP Purchase-to-Pay.
Factores influyentes, no conjeturas:La herramienta analiza cada atributo de caso y clasifica lo que destaca entre los casos problemáticos, considerando el tamaño del efecto, el recuento de casos y la significación estadística. Por ejemplo: los casos con un proveedor específico incumplen el objetivo de rendimiento 3,2 veces más a menudo que el resto.
Hacia dónde conduce:Los hallazgos aparecen junto a sus tablas de Power BI y en Process.Science Intelligence. Allí podrá seguirlos a través del gráfico de procesos, comparar poblaciones y conservar lo que se consolide como una conclusión con sus respectivas pruebas.
¿Qué sigue?

Describa su proceso y deje que la herramienta lo encuentre

Llevamos la experiencia en reconocimiento de patrones de nuestro IoT Miner a la preparación de datos. Usted describe en una frase de qué tratan sus datos, por ejemplo: "adquisiciones, desde la solicitud de compra hasta el pago de la factura", y la herramienta propone candidatos de proceso con actividades reales de sus propias tablas.
Verificado con sus datos, sin suposiciones:Cada actividad propuesta se verifica con lo que realmente existe. ¿Existen las tablas y columnas?, ¿hay suficientes filas coincidentes?, ¿las marcas de tiempo parecen reales?, ¿la actividad comparte identificadores de caso con el resto del proceso?
Solo pregunta cuando no está seguro:Cada actividad conlleva una puntuación de confianza basada en diversas señales, y usted refina el resultado mediante una conversación antes de convertirlo en un flujo de trabajo ejecutable.
Aprende de sus expertos:Lo que su equipo confirma queda registrado, por lo que el siguiente descubrimiento en el mismo sistema parte de una mejor base.
Descubrimiento automático de procesos en el Data Preparation Tool, que propone actividades a partir de sus propias tablas de base de datos
Conexiones

Lee de tus sistemas,
escribe de vuelta donde trabajas

Una fuente es de donde la herramienta lee los datos, y un destino es donde los escribe. Toda conexión a base de datos funciona en ambas direcciones.
Diagrama de las conexiones del Data Preparation Tool con los sistemas de origen y destino: bases de datos, Dynamics 365, Power BI y Process.Science Intelligence
¿Te falta algo?
La configuración perfecta

Diseñado para suPower BIyInteligencia

La herramienta de preparación de datos es el motor de su minería de procesos. Los registros de eventos que genera fluyen directamente al sistema con el que trabaja, sin pasos de modelado adicionales.

Integración con Power BI

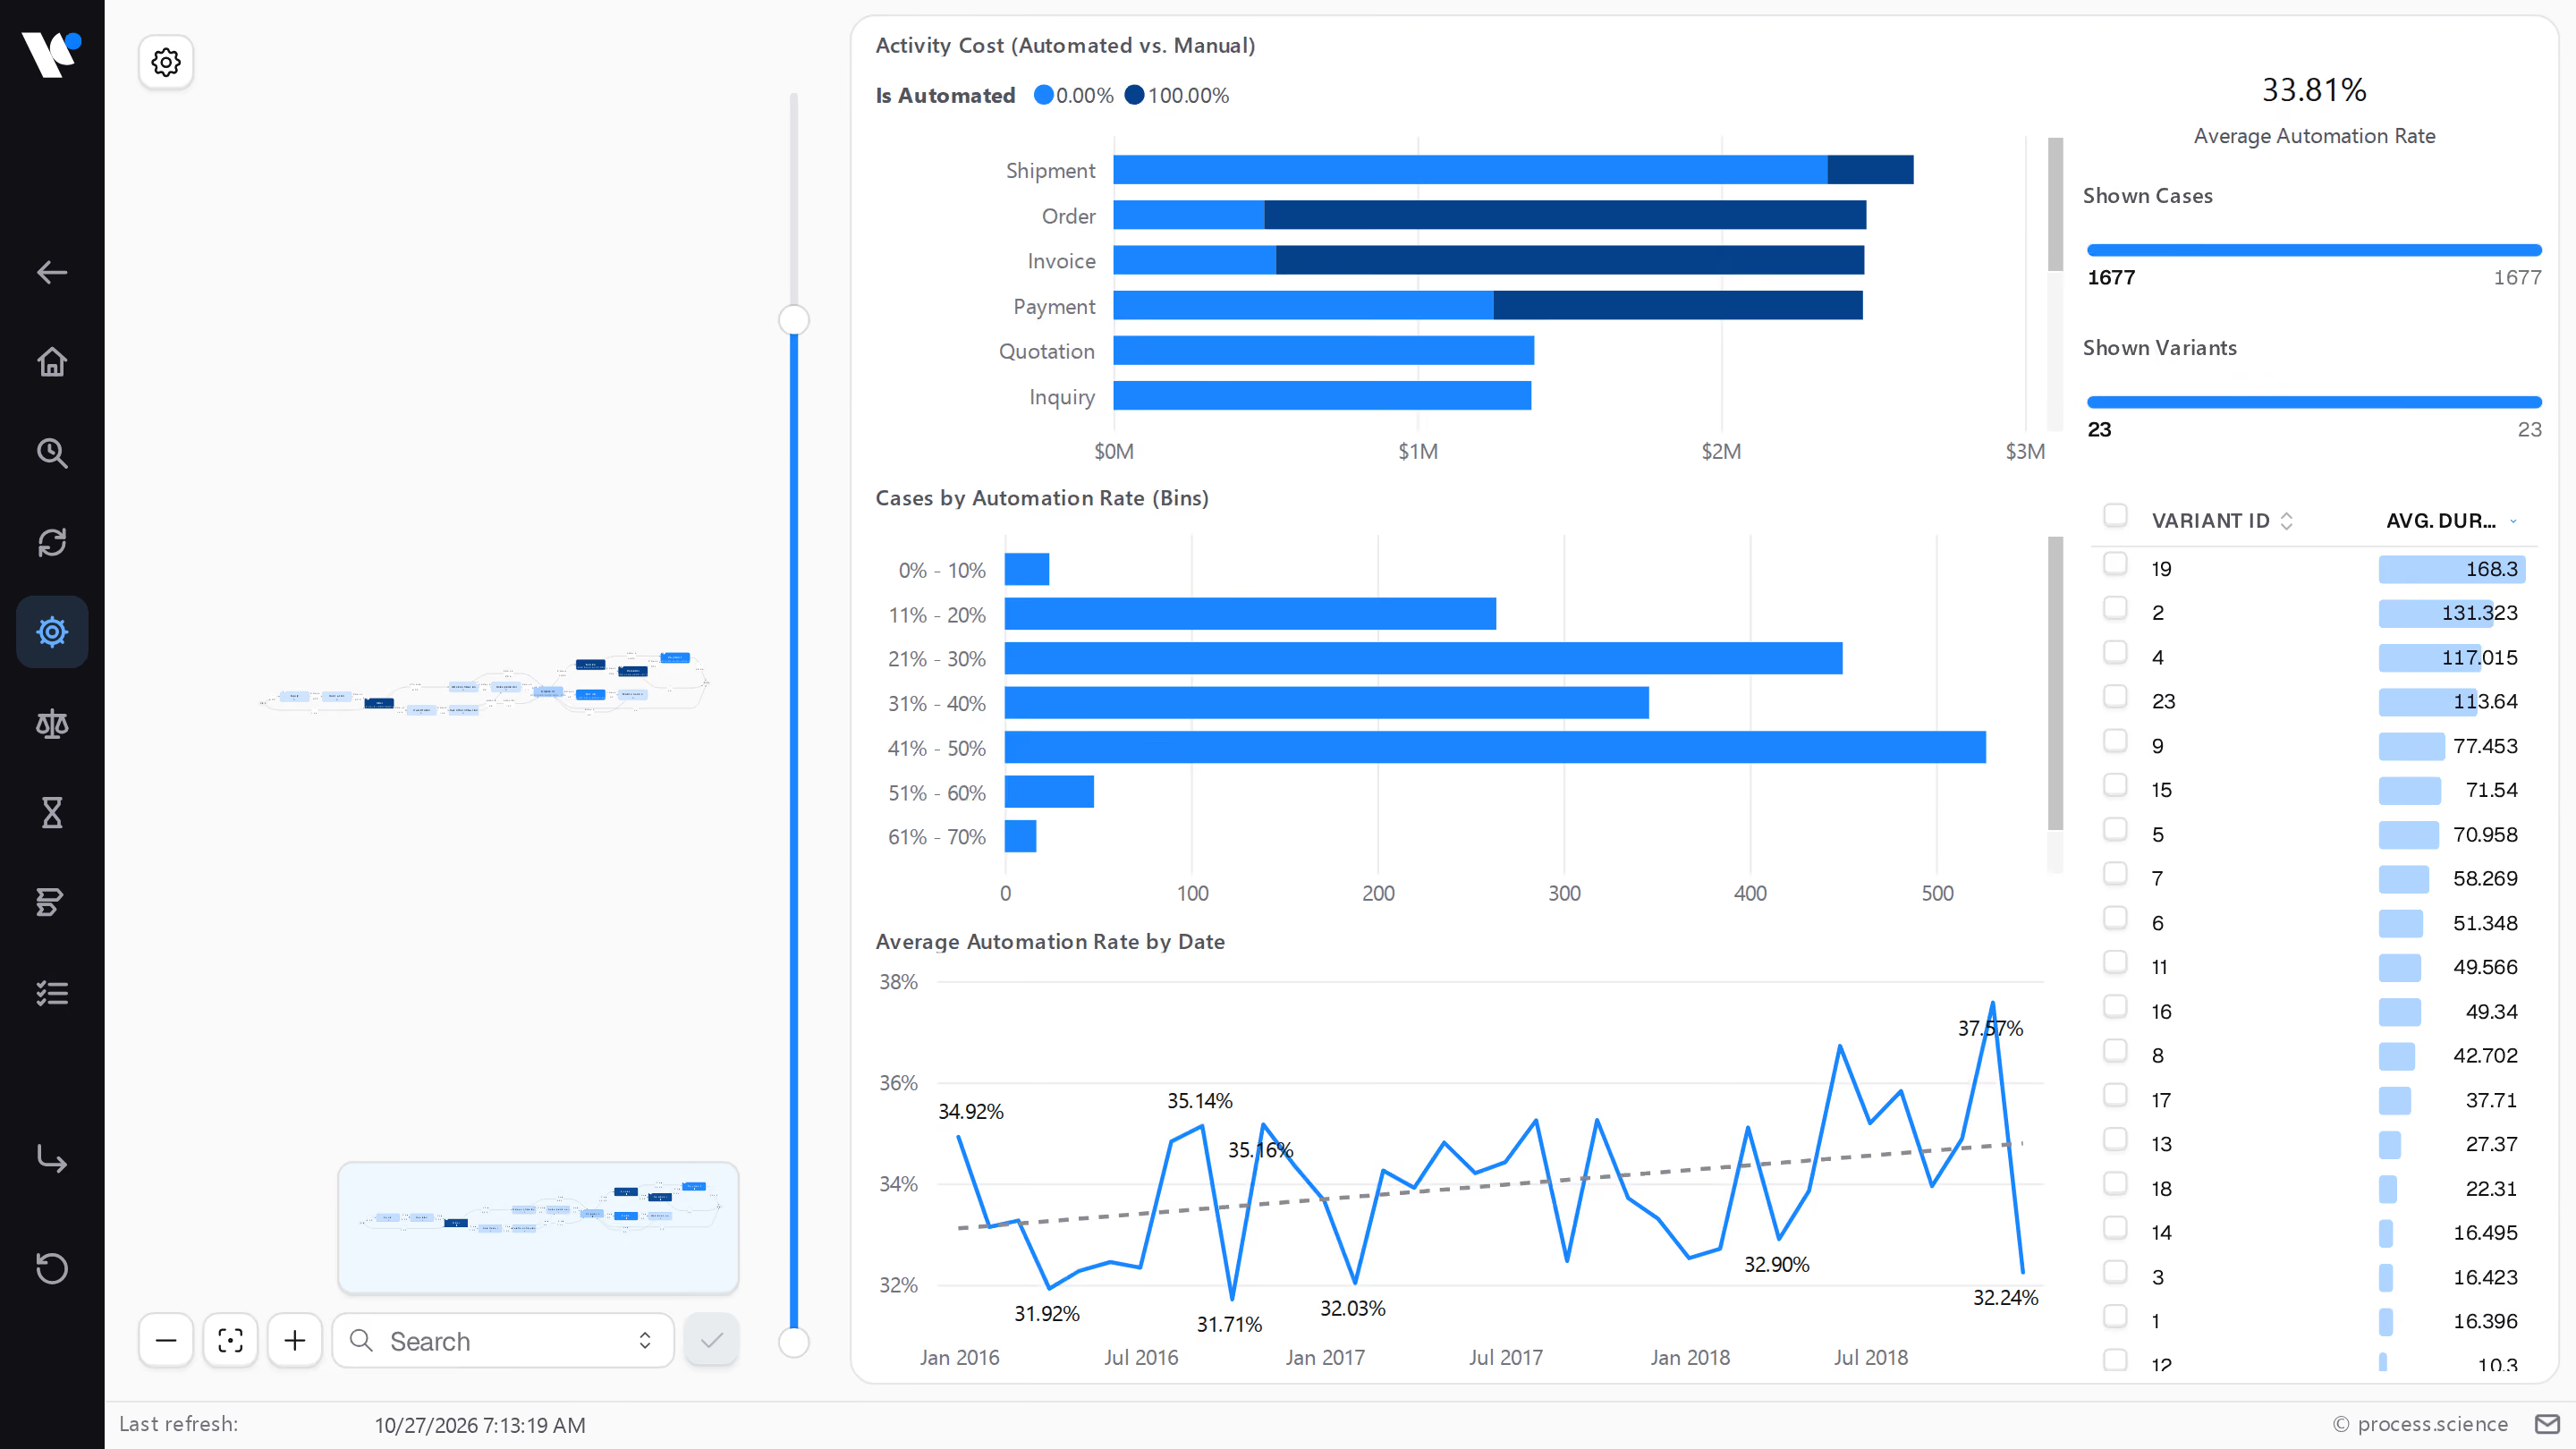
Las tablas de salida tienen el diseño que esperan nuestras plantillas de informes de Power BI. Su registro de eventos se integra en su propio modelo, junto a sus dimensiones existentes, y los paneles funcionan sin necesidad de realizar ajustes por proyecto.
Automation rates by activity and over time in Process.Science

Process.Science Intelligence

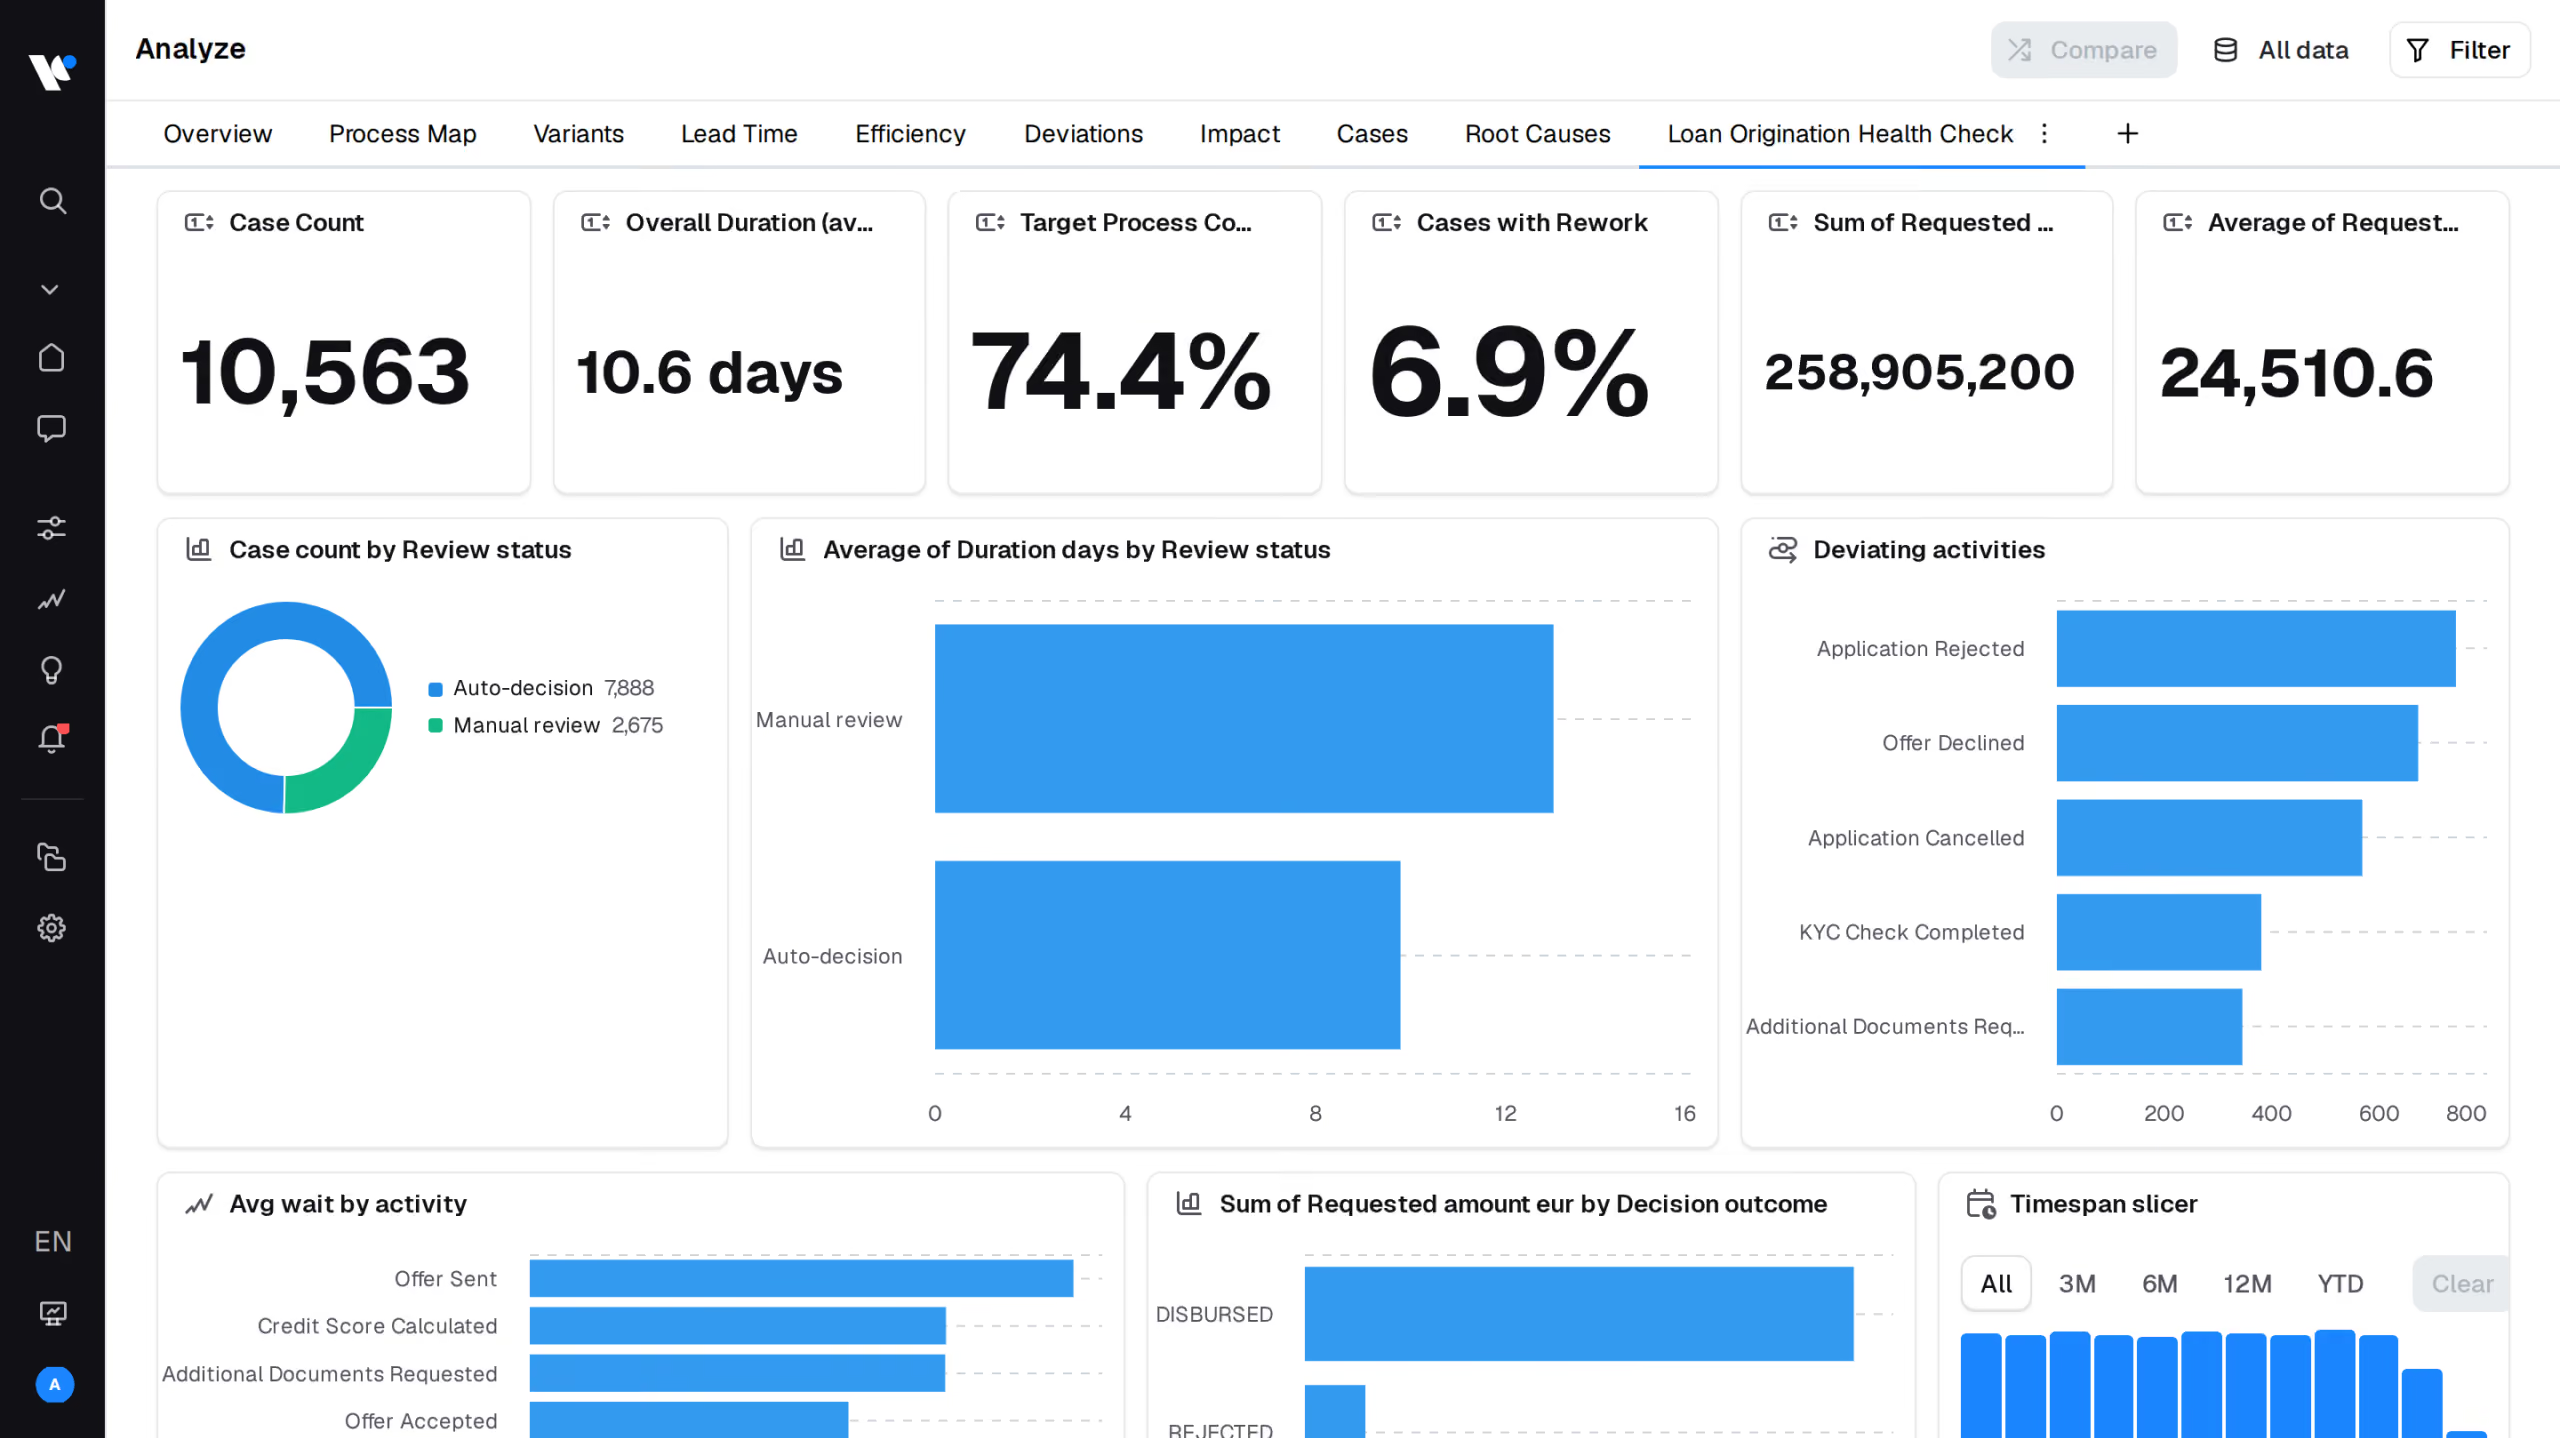
Una ejecución finalizada se convierte en el conjunto de datos con el que trabajan sus proyectos de Intelligence y actualiza el análisis automáticamente. A partir de ahí, dispone de configuración, análisis, información, chat y alertas.
Interfaz de Process.Science Intelligence con configuración, análisis, conocimientos, chat y notificaciones
Empezar

Vea su propio registro de eventos, no una demostración

Conecte un sistema, elija un proceso y vea los resultados. Lo hacemos juntos con sus datos, por lo que el resultado es su proceso real y no un conjunto de datos de muestra.
Se ejecuta en sus propios sistemas y bases de datos
Plantillas listas para usar para sus procesos principales
No requiere ETL escrito a mano
Al enviar la solicitud, usted acepta la Política de privacidadde Process.Science.
¡Gracias! ¡Hemos recibido su envío!
Recibirá un correo electrónico con un enlace de confirmación.
¡Ups! Algo salió mal al enviar el formulario.
¿Tiene más preguntas?

Preguntas frecuentes:Tecnología y arquitectura

Las respuestas que buscan primero los administradores de TI y los ingenieros de datos
¿Qué sistemas de origen son compatibles?

Microsoft SQL Server y Azure SQL, PostgreSQL, MySQL y MariaDB directamente, otras bases de datos mediante ODBC, Microsoft Dynamics 365 a través de la exportación a Dataverse Lake y carga de CSV para varias tablas a la vez. SAP se lee a través de su base de datos, por lo que las plantillas de SAP funcionan independientemente de su versión de SAP. Los resultados pueden escribirse de nuevo en cualquiera de esas bases de datos, entregarse como archivos de datos o enviarse a Mavim.

¿La preparación de datos debe realizarse en la nube?

No. La herramienta lee y escribe en sus propias bases de datos, por lo que los datos permanecen en el entorno en el que usted opera. Las contraseñas y los tokens de acceso se almacenan cifrados, el acceso se organiza por espacio de trabajo y las ejecuciones se escalan entre los trabajadores a medida que aumentan los volúmenes.

¿La herramienta reemplaza a Power Query?

No es una herramienta ETL de propósito general y no pretende serlo. Power Query y herramientas similares mueven y remodelan datos sin saber qué es un proceso. La herramienta de preparación de datos está diseñada para una sola tarea: convertir tablas operativas en un registro de eventos, con actividades, casos, variantes y datos maestros ya integrados. Puede seguir usando Power Query para todo lo demás.

¿Cuánto tiempo lleva obtener el primer registro de eventos?

Una vez establecida la conexión y elegida la plantilla, la primera ejecución es cuestión de minutos en lugar de semanas, porque el trabajo de mapeo ya está hecho. Lo que lleva tiempo es acordar qué actividades forman parte de su proceso, y eso es una conversación con su equipo, no una tarea de ingeniería de datos.

¿Qué sucede cuando cambia nuestro sistema de origen?

Una plantilla es un conjunto de pasos SQL que puede leer y editar. Si un campo se mueve o una tabla cambia de nombre, usted ajusta ese paso en lugar de reconstruir toda la canalización. Cada ejecución se registra con recuentos de eventos y duraciones por actividad, por lo que cualquier cambio en la fuente se refleja como un cambio en las cifras.

¿Podemos crear un proceso que no esté en el catálogo?

Sí. Puede empezar con una plantilla y añadir sus propias actividades y pasos de preparación, o crear un proceso personalizado desde cero. En ambos casos, el resultado tiene la misma estructura que cualquier otro registro de eventos, por lo que sus informes seguirán funcionando.