Inteligencia de procesos intuitiva

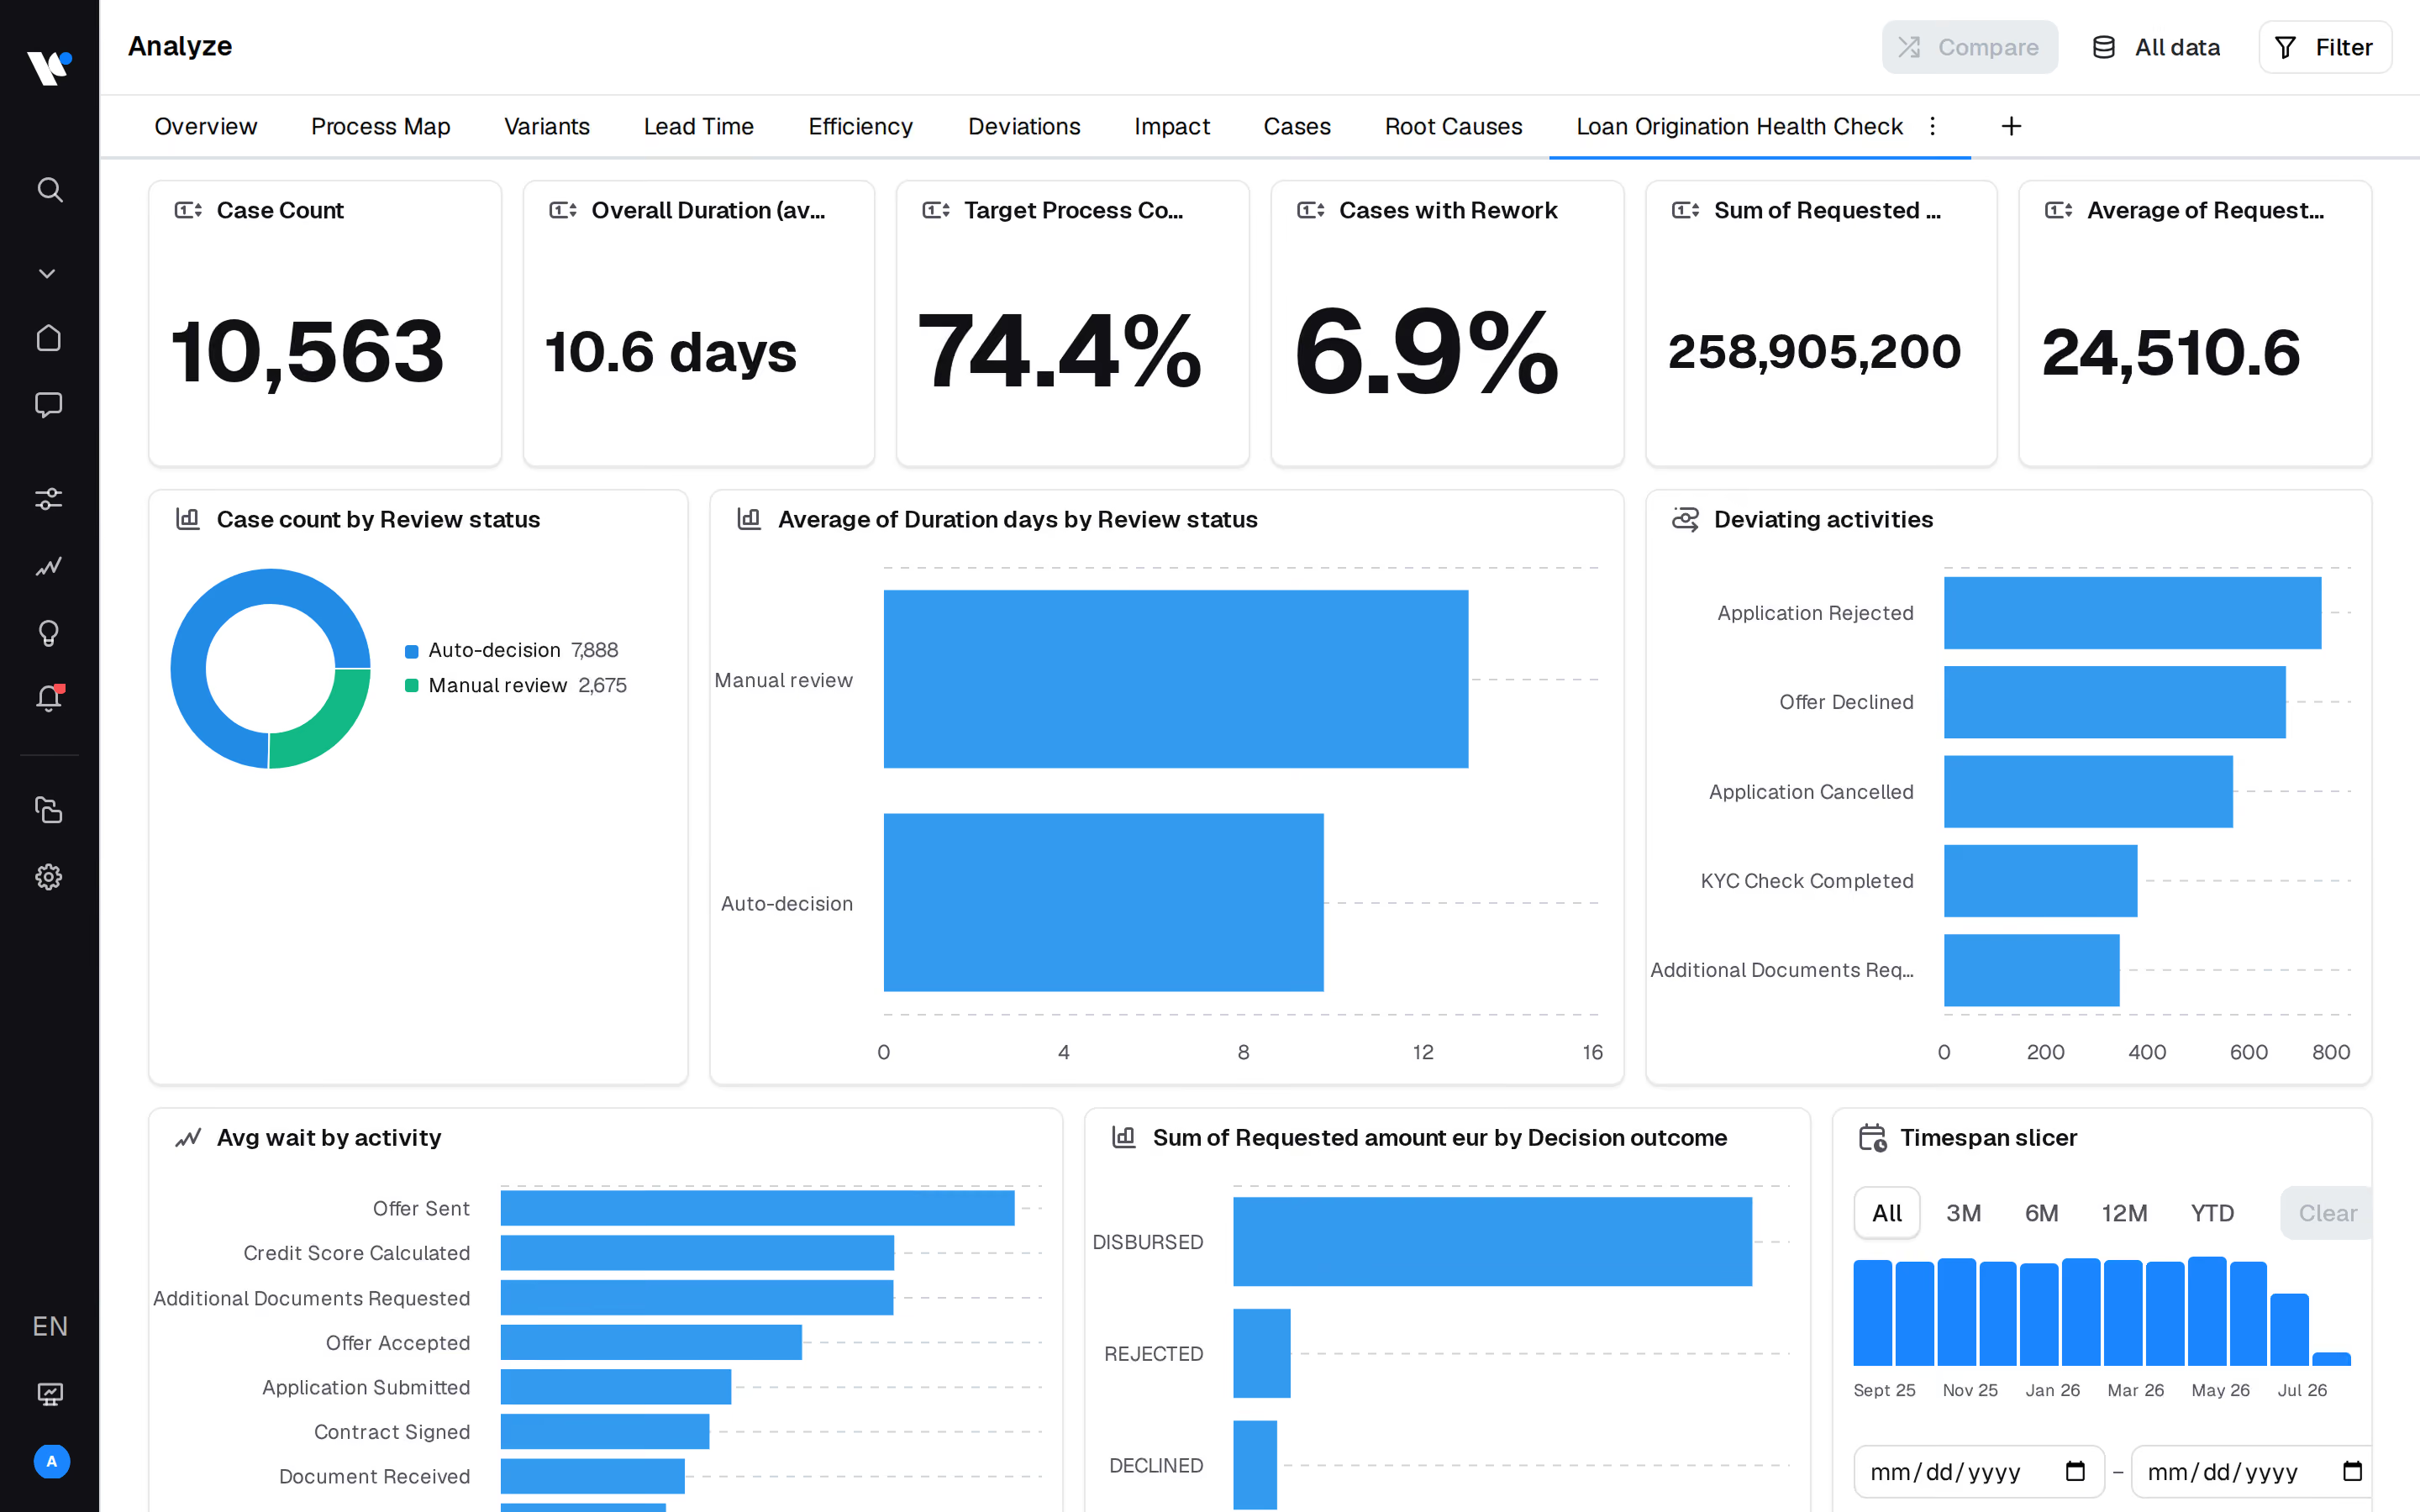
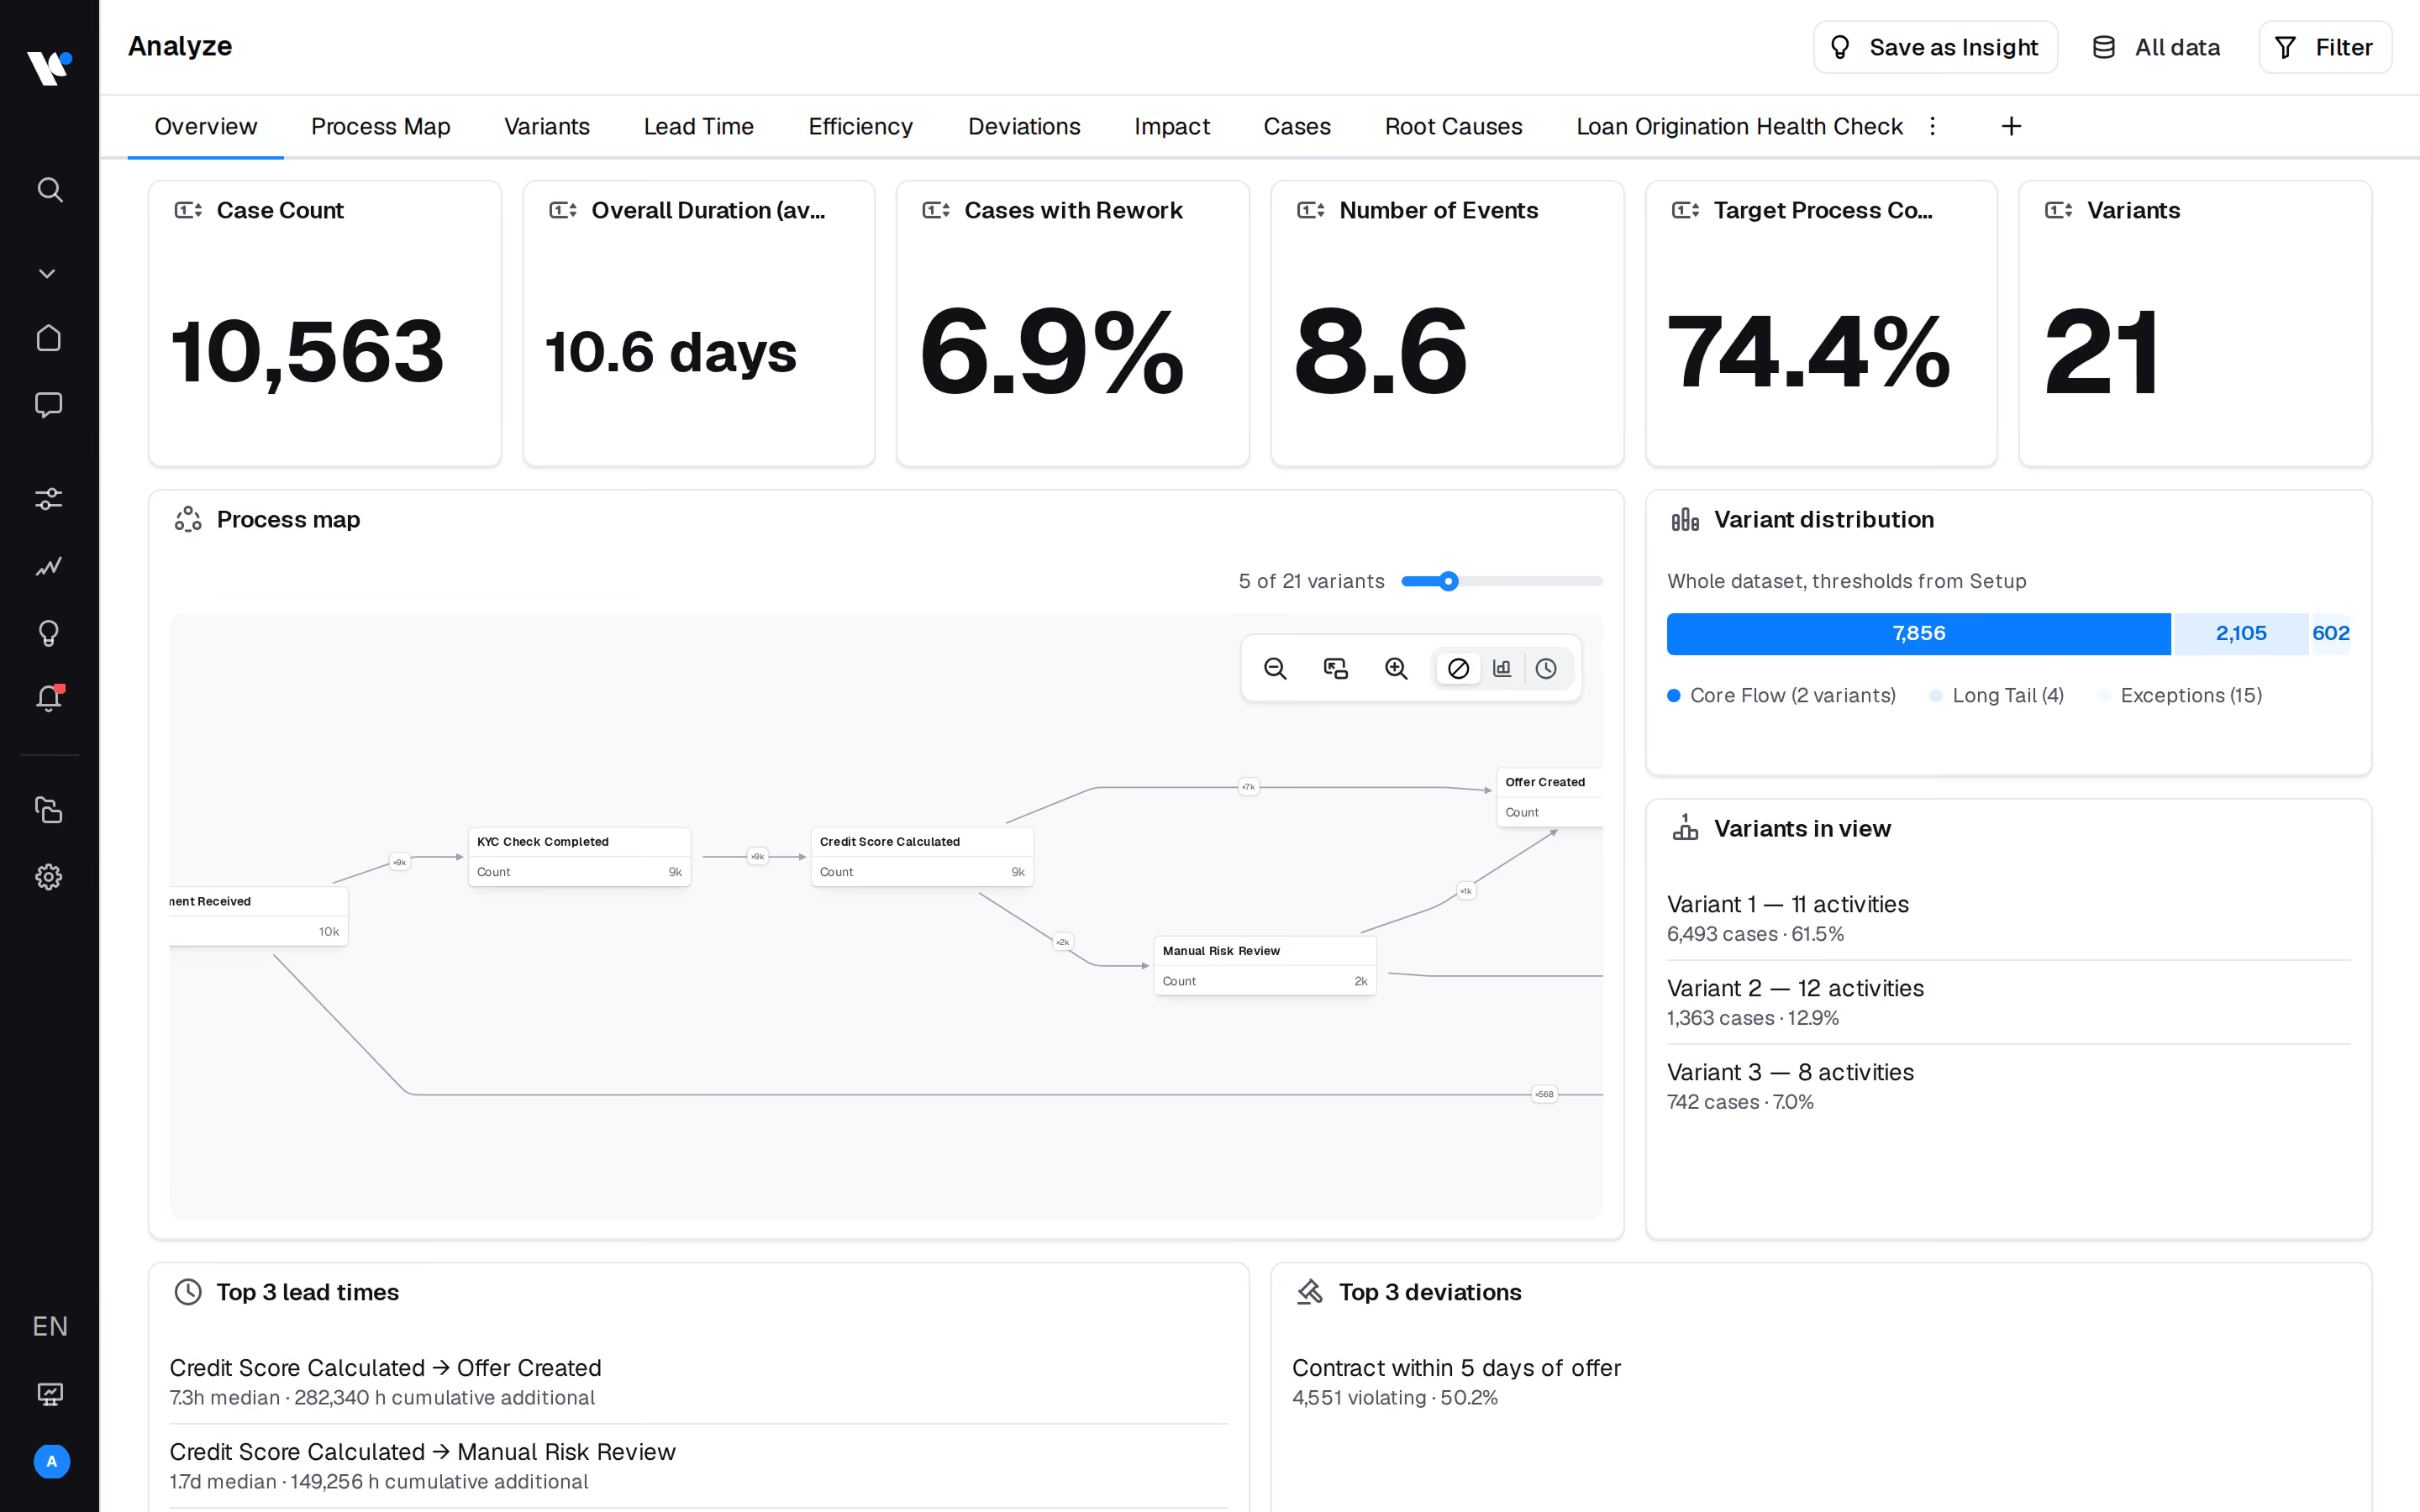
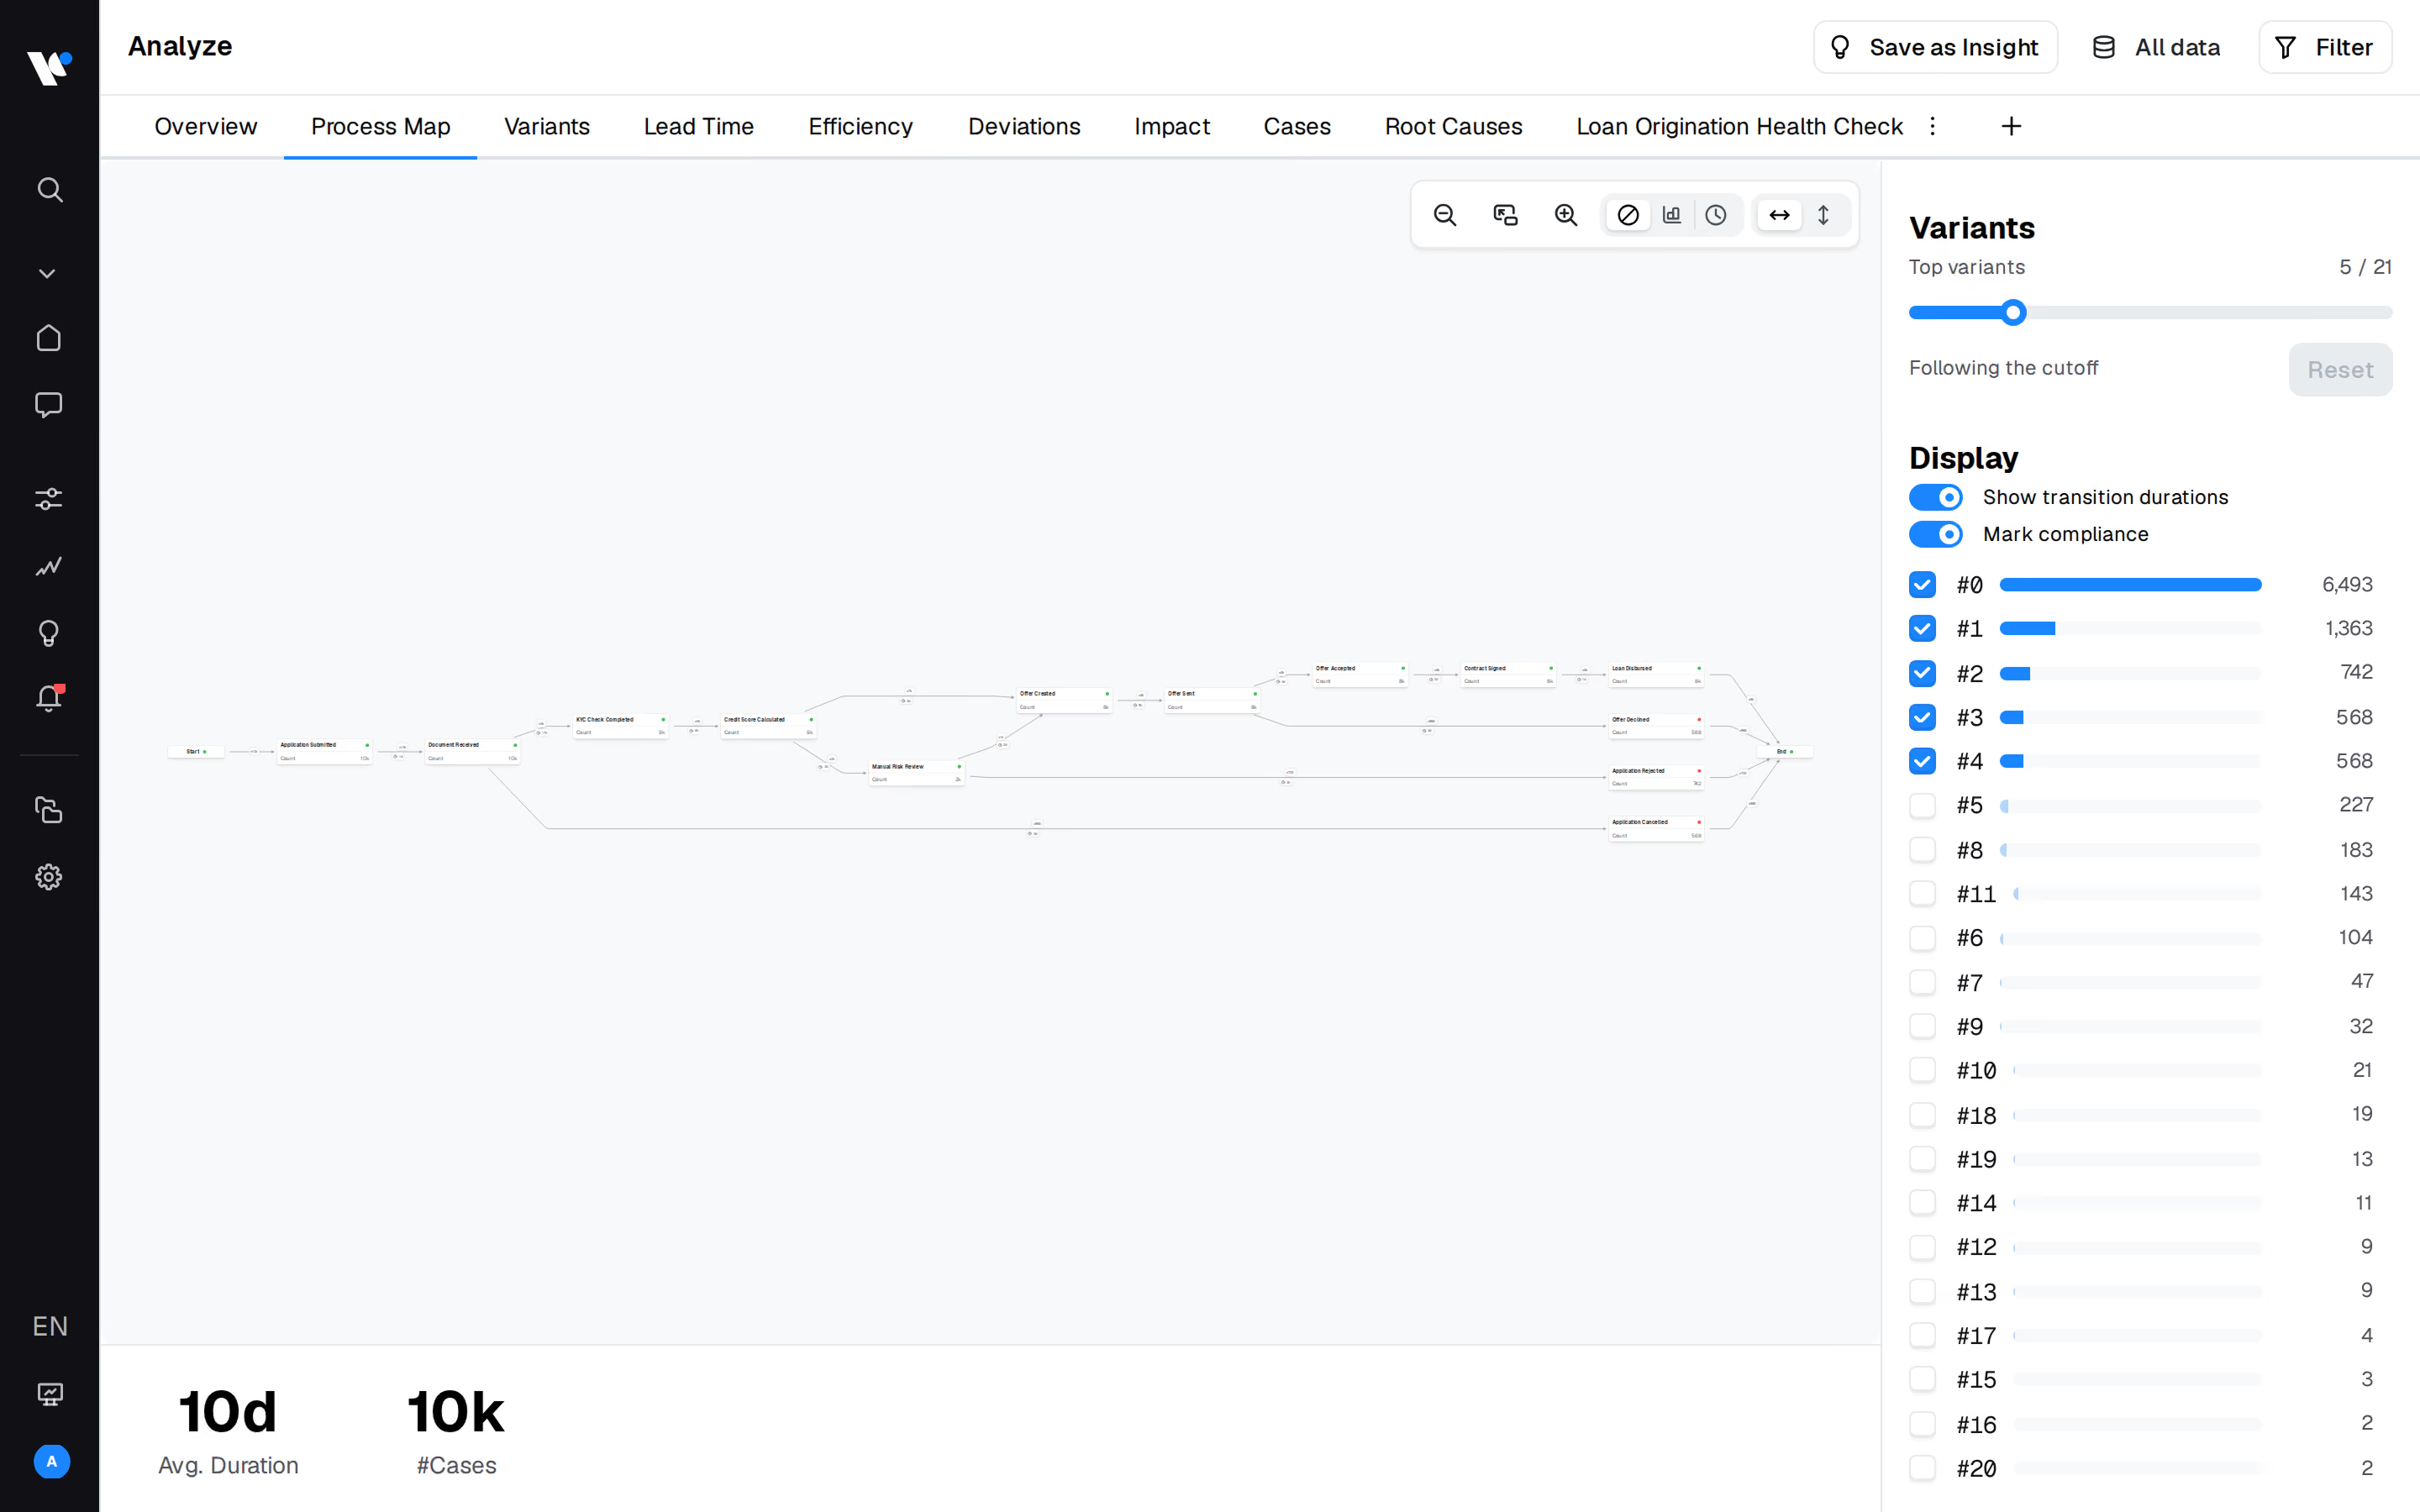
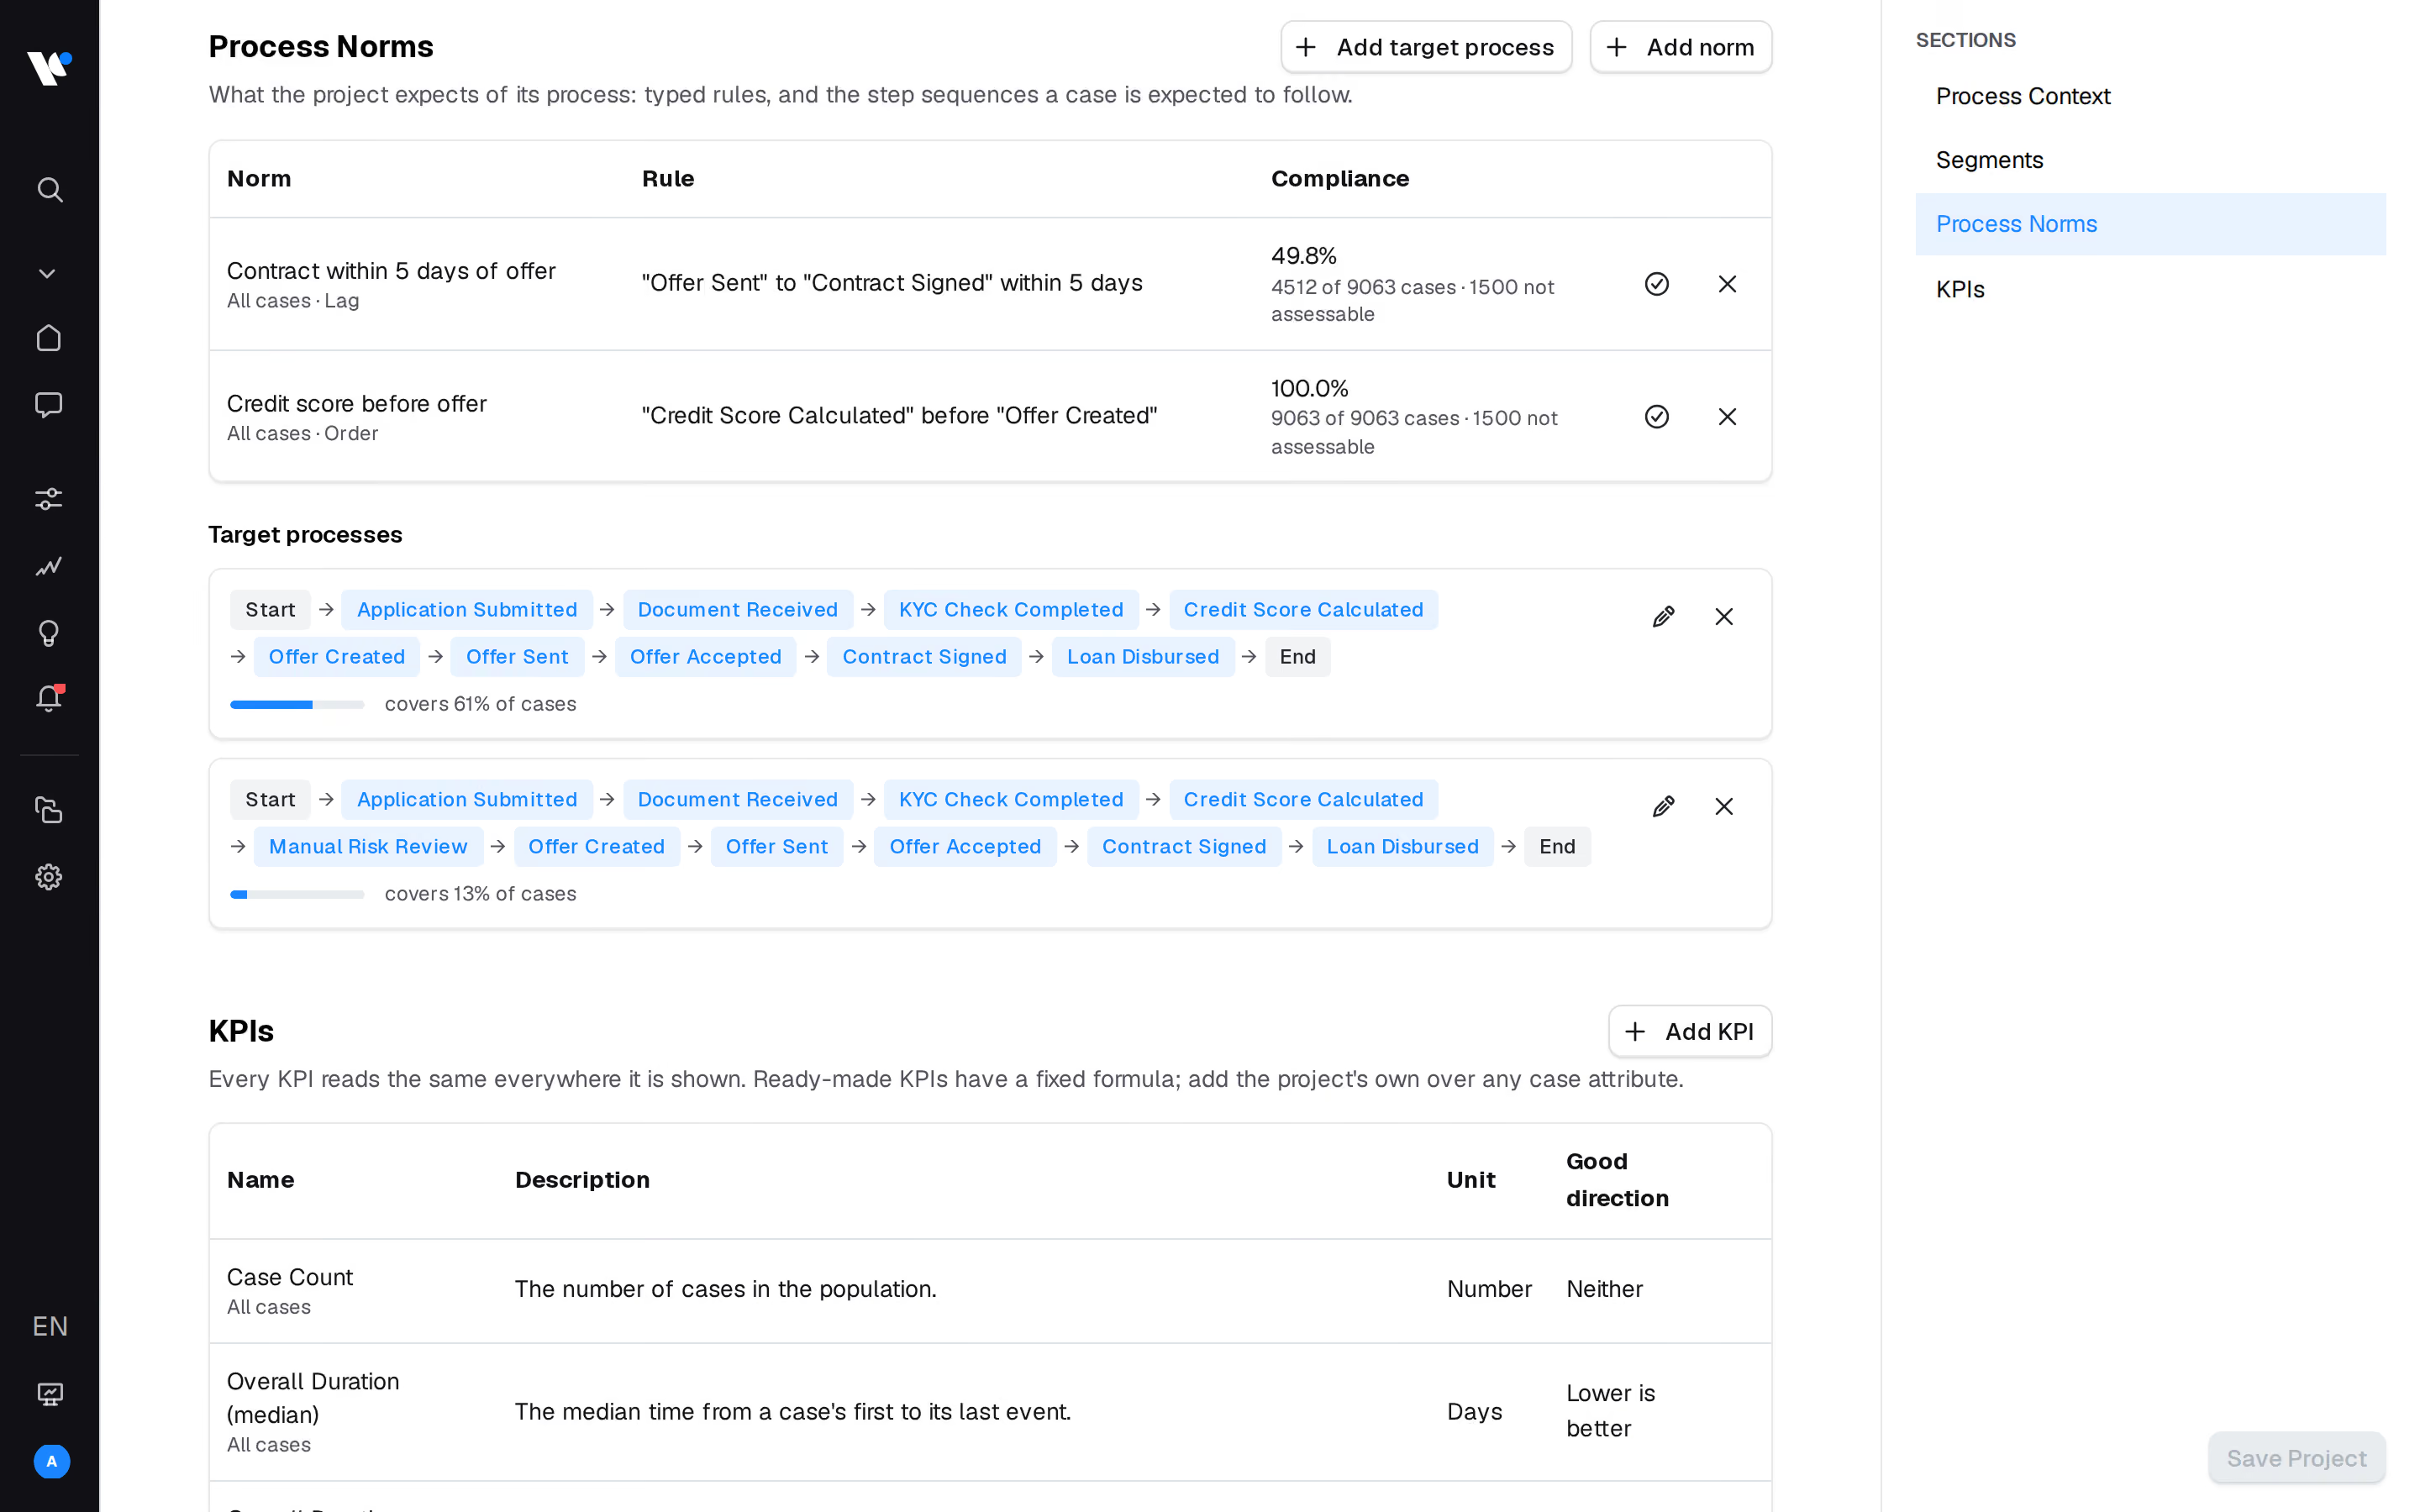

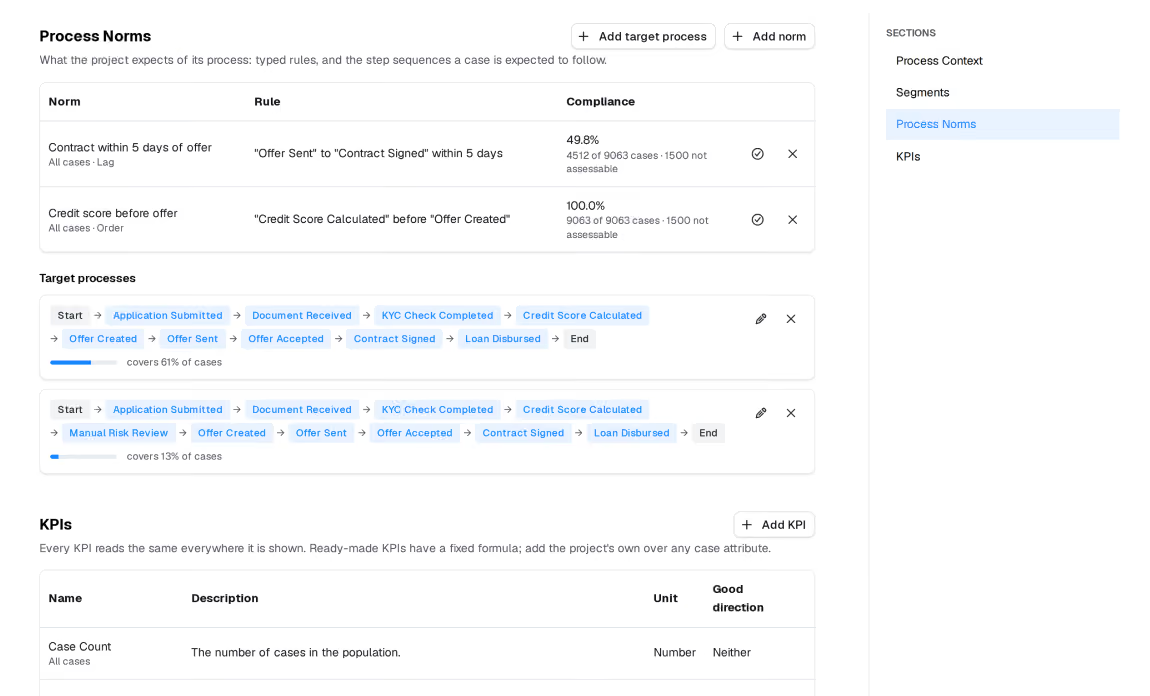
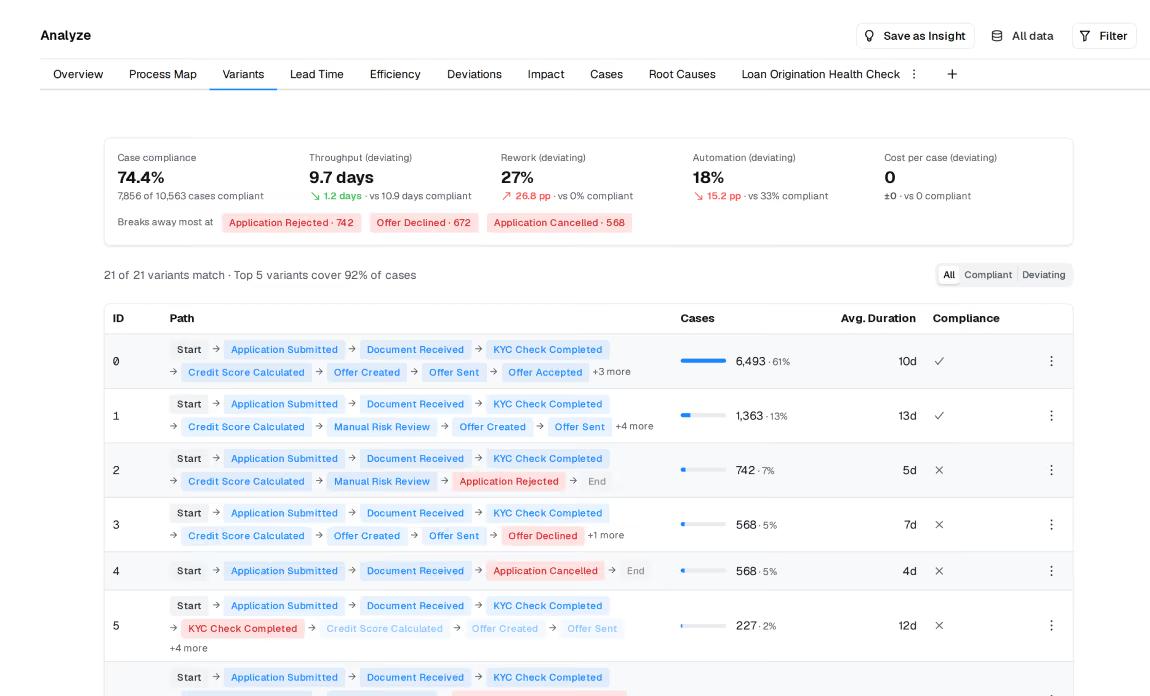
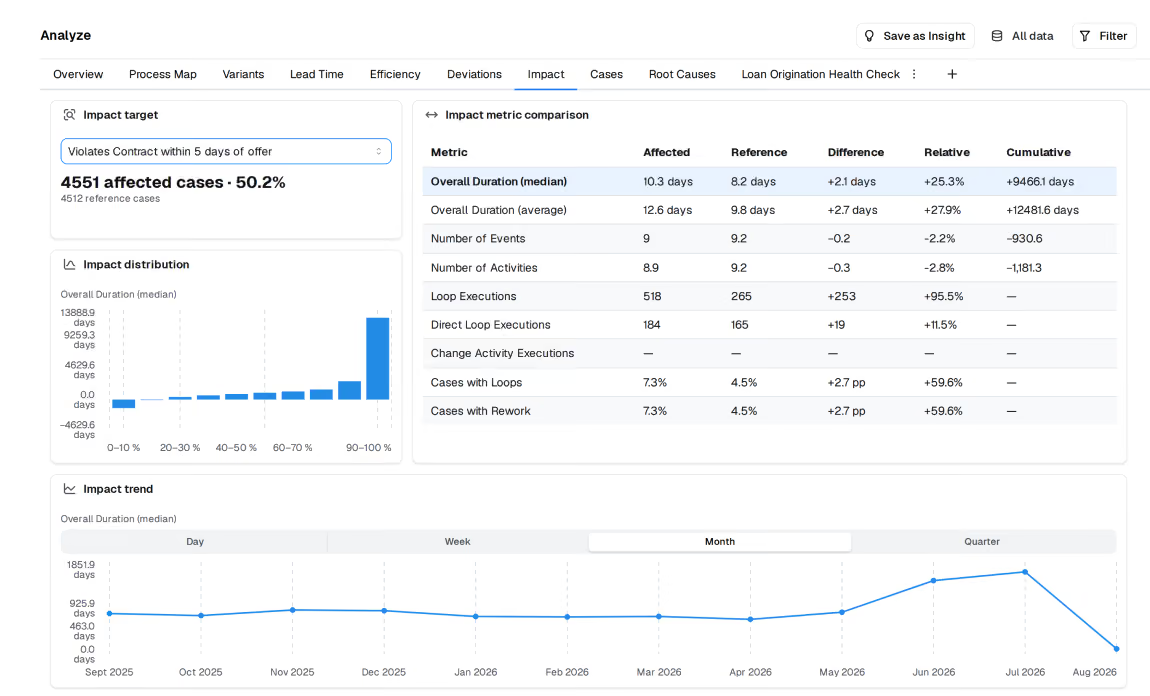
Datos extraídos de sus sistemas operativos, normalmente ERP, y para la mayoría de los procesos eso significa un puñado de tablas. Nuestra herramienta de preparación de datos los convierte en un registro de eventos limpio, por lo que no es necesario que nos proporcione uno terminado. Si ya tiene un registro de eventos, también podemos trabajar con él.
No. A diferencia de nuestras conocidas integraciones para Microsoft o Qlik, process.science Intelligence está diseñada como una plataforma totalmente independiente. Todo lo que necesita son sus datos extraídos del ERP.
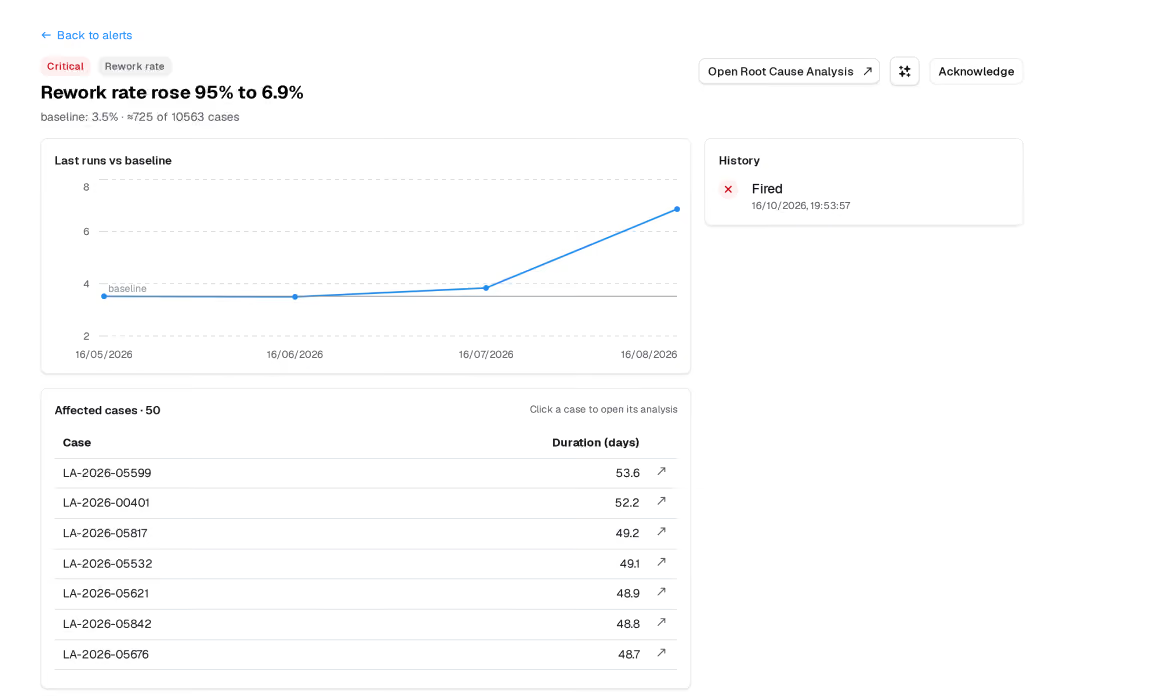
Intelligence incluye normas de proceso predeterminadas que cubren las desviaciones habituales en cualquier proceso: bucles de retrabajo, pasos omitidos, secuencias interrumpidas y tiempos de espera inusuales. Por lo tanto, el monitoreo comienza con su primer conjunto de datos. En la configuración, puede ajustar esas normas o guardar un proceso objetivo como referencia siempre que desee ser más específico sobre su propio negocio.
No tiene que formular una hipótesis y luego filtrar hasta llegar a ella. Intelligence busca por sí mismo en sus datos los factores que impulsan un problema, por ejemplo, un proveedor, una planta o un tipo de pedido que aparece de forma desproporcionada entre los casos retrasados, y los clasifica según su nivel de asociación. Luego le muestra la evidencia detrás de cada uno, para que el hallazgo pueda ser verificado en lugar de simplemente aceptado. El último paso, decidir que un factor es la causa y actuar en consecuencia, sigue siendo responsabilidad de quienes conocen el negocio.
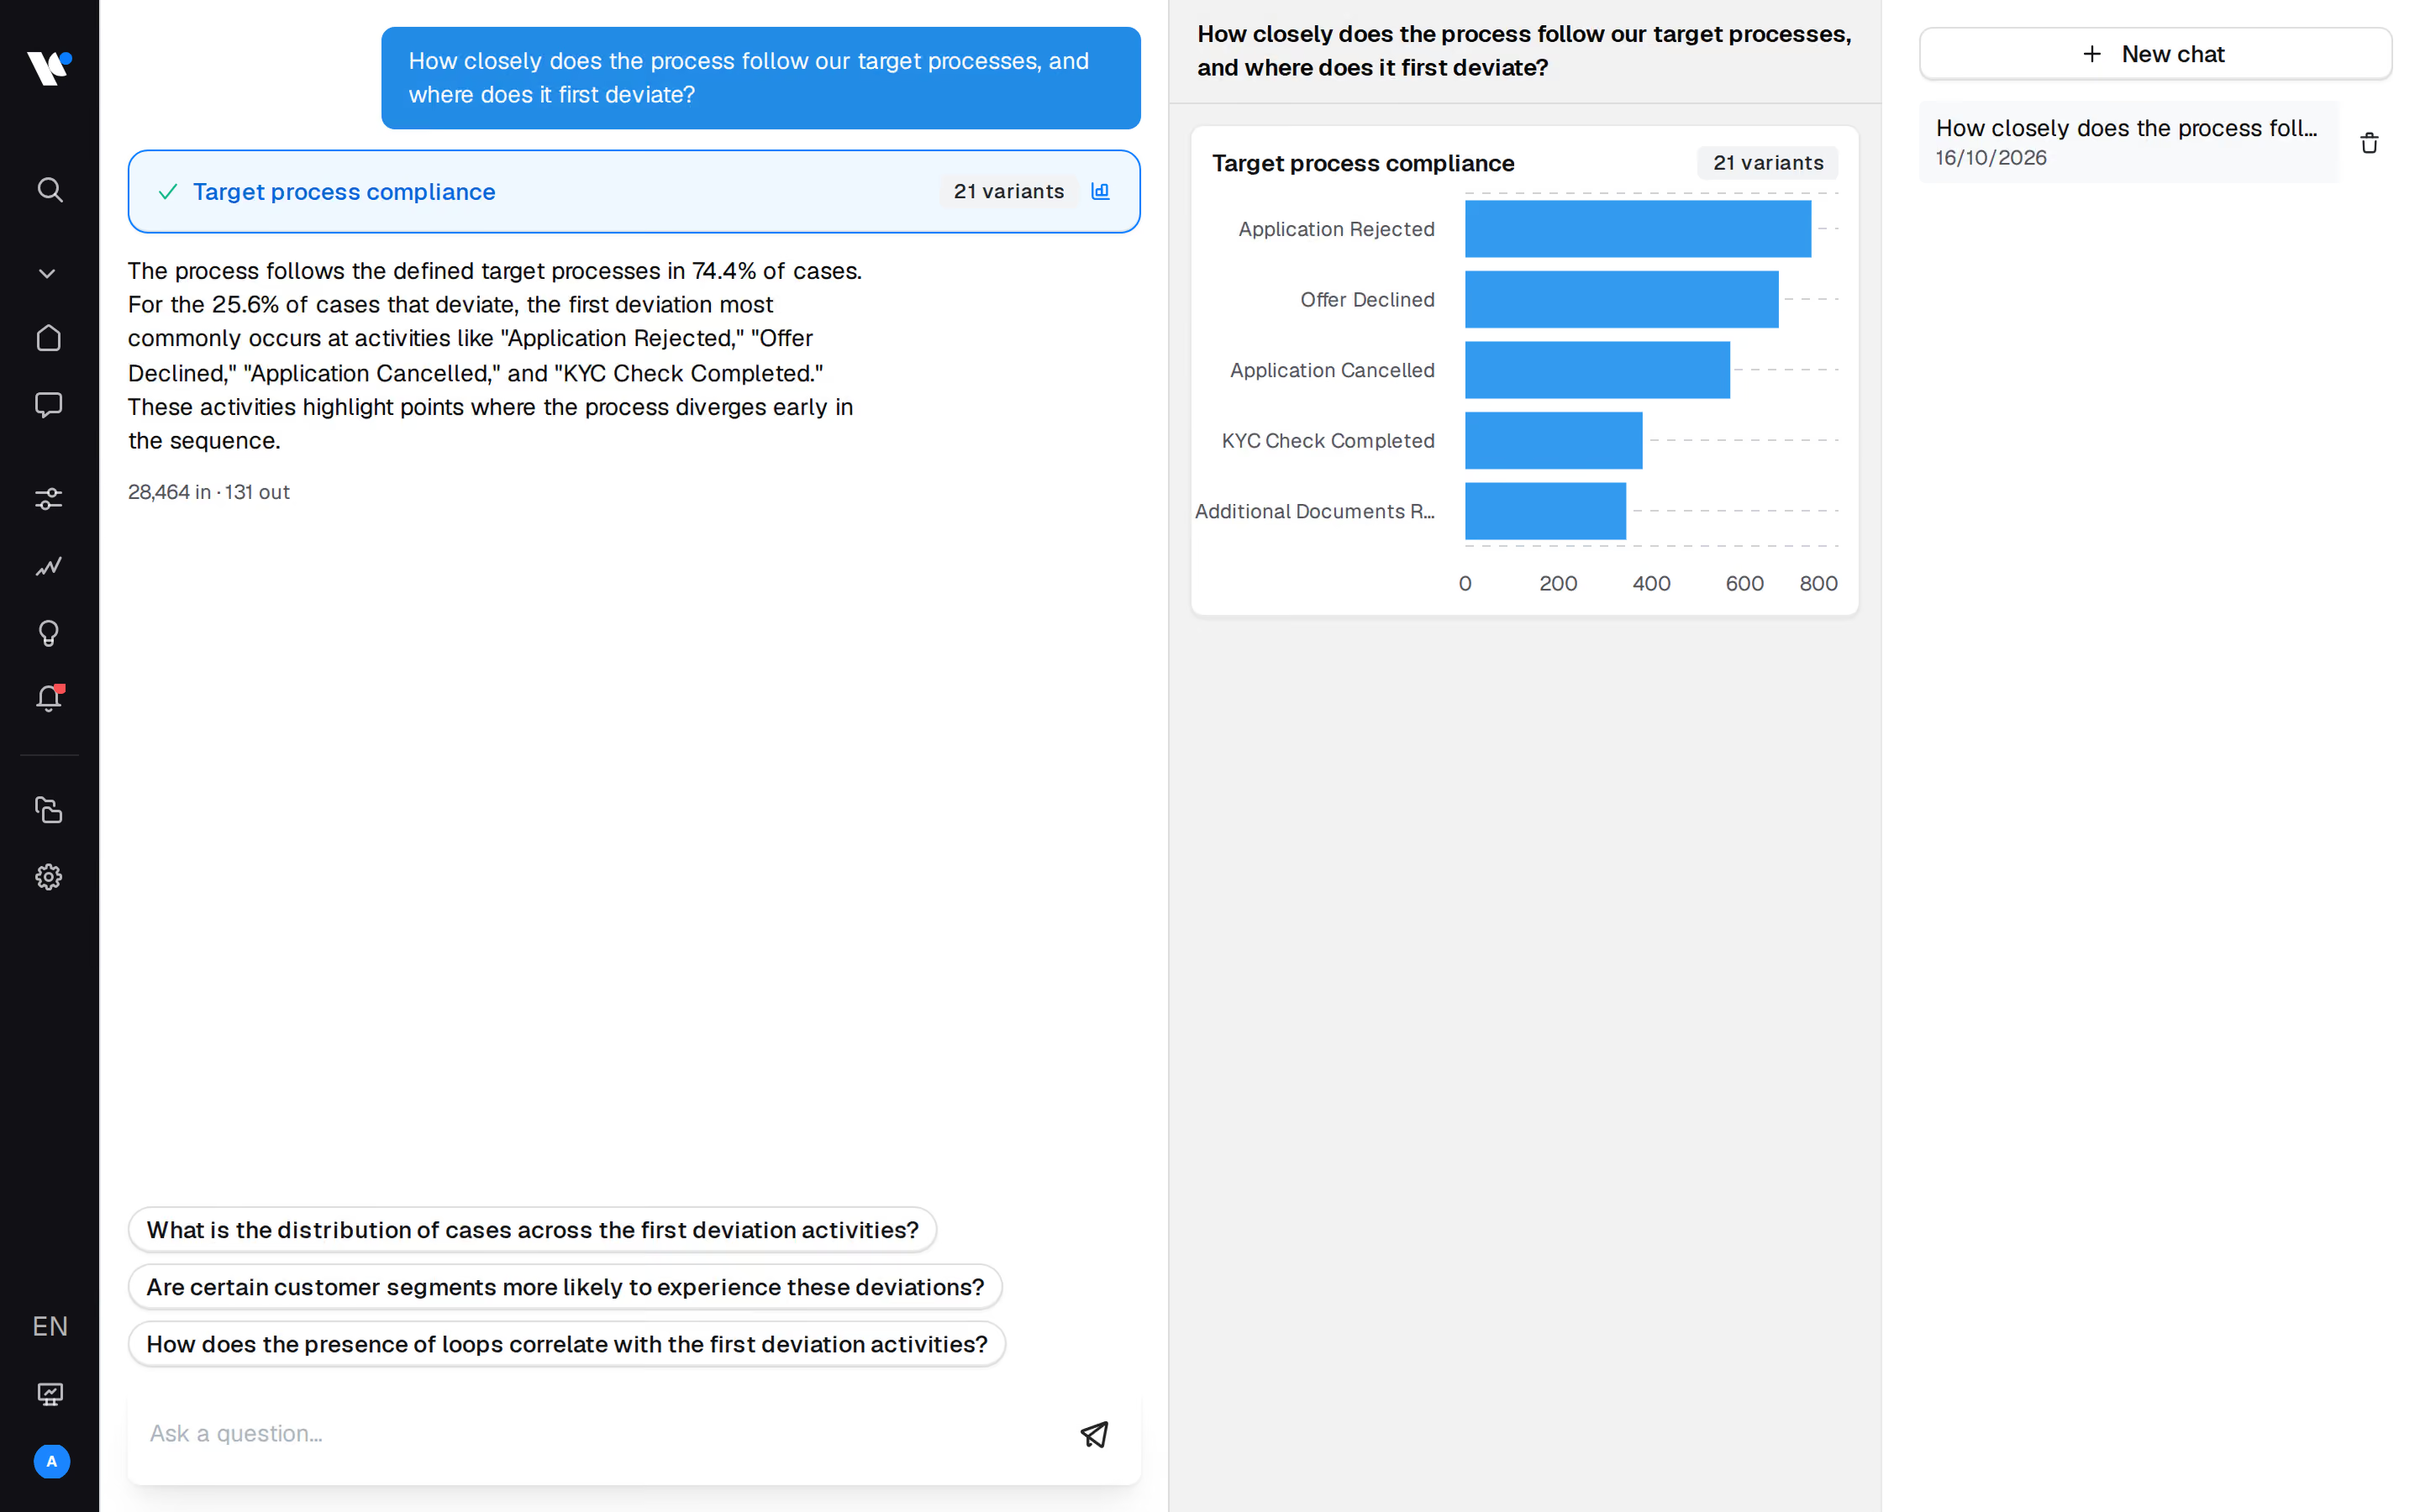
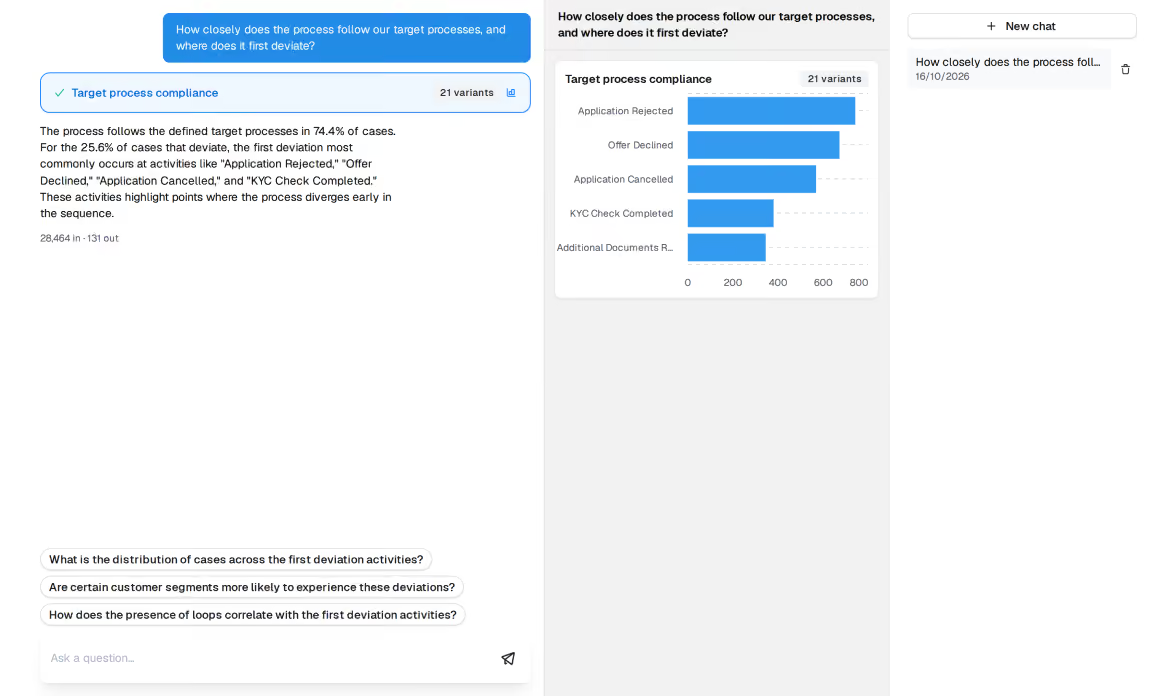
Sí, porque el chat no realiza estimaciones. Su pregunta se traduce en una consulta sobre sus datos de proceso y la respuesta proviene de los mismos cálculos que generan las vistas de análisis. Cada hallazgo que guarda como una conclusión almacena la herramienta, el intervalo de tiempo, los filtros, la selección, la población afectada y la versión del conjunto de datos, para que cualquiera pueda verificar la cifra más adelante.
No se requieren conocimientos de ciencia de datos. Existen tres roles: un administrador para proyectos y conjuntos de datos, un analista que configura la configuración y ejecuta los análisis, y usuarios de negocio que leen los hallazgos y hacen preguntas en el chat. La mayor parte del uso diario recae en personas que conocen el proceso, no la base de datos.
Sus datos de proceso permanecen dentro del entorno acordado y nunca se utilizan para entrenar modelos públicos. Los modelos de lenguaje que empleamos son modelos empresariales aislados. Process.Science opera cumpliendo con el RGPD y cuenta con la certificación ISO 27001, y los derechos de acceso controlan qué procesos y datos puede consultar cada usuario.
La herramienta de preparación de datos crea y mantiene los registros de eventos, Intelligence los analiza y el IoT Miner añade datos de máquinas y sensores allí donde su proceso llega a la planta. Funcionan en conjunto, aunque cada una puede utilizarse de forma independiente.