Process Intelligence intuitiva

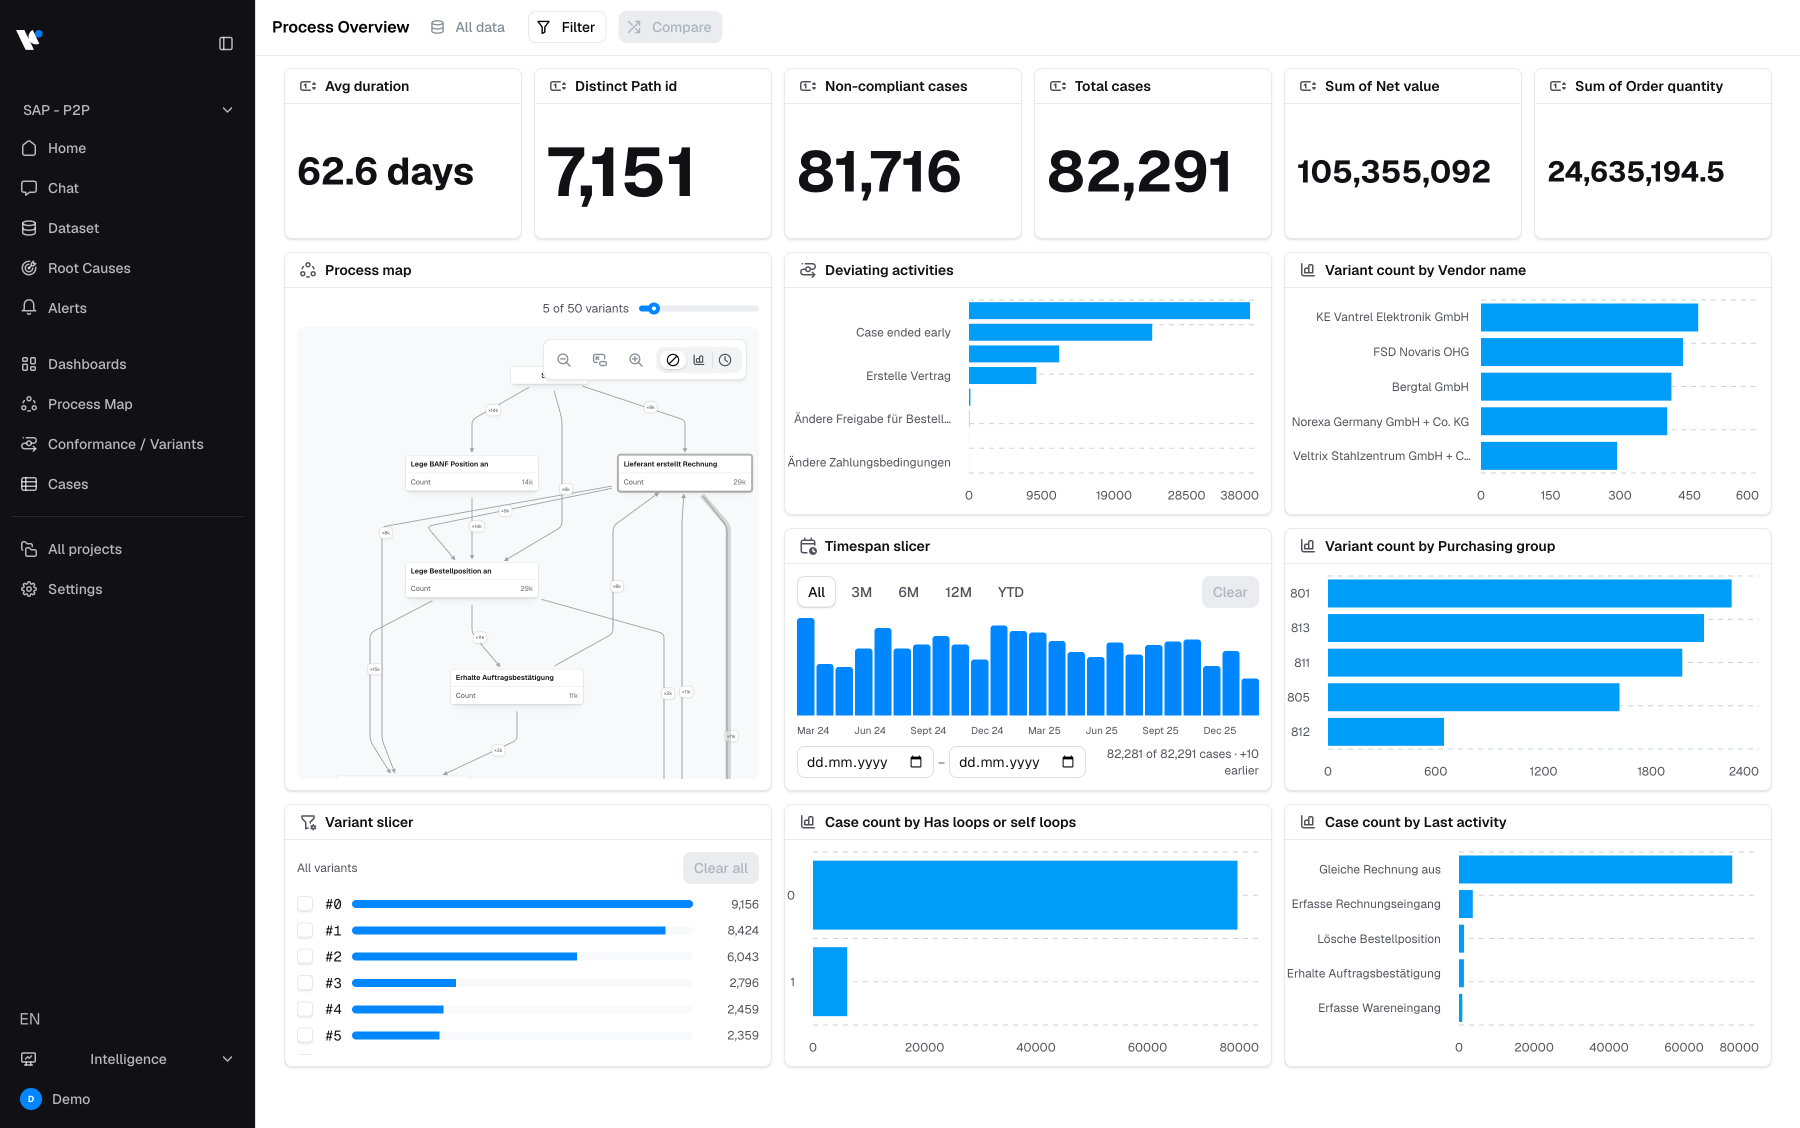
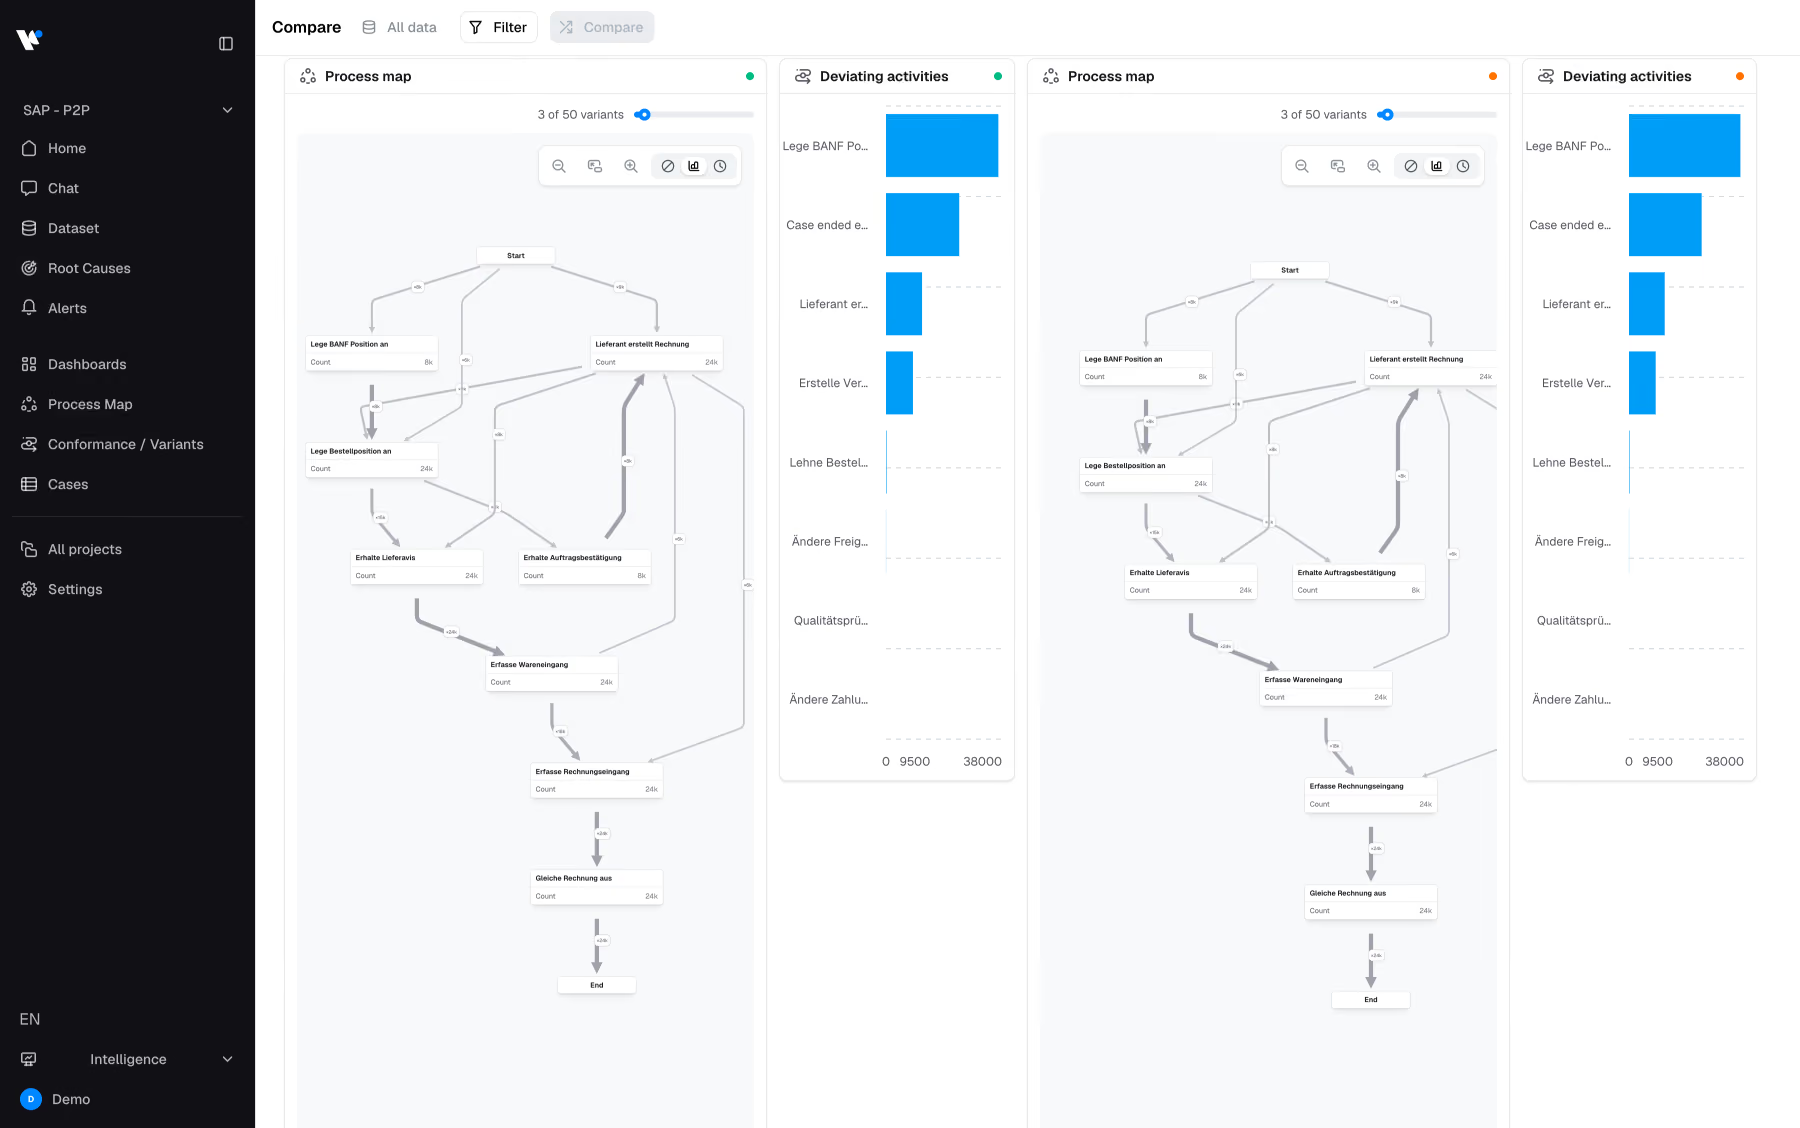
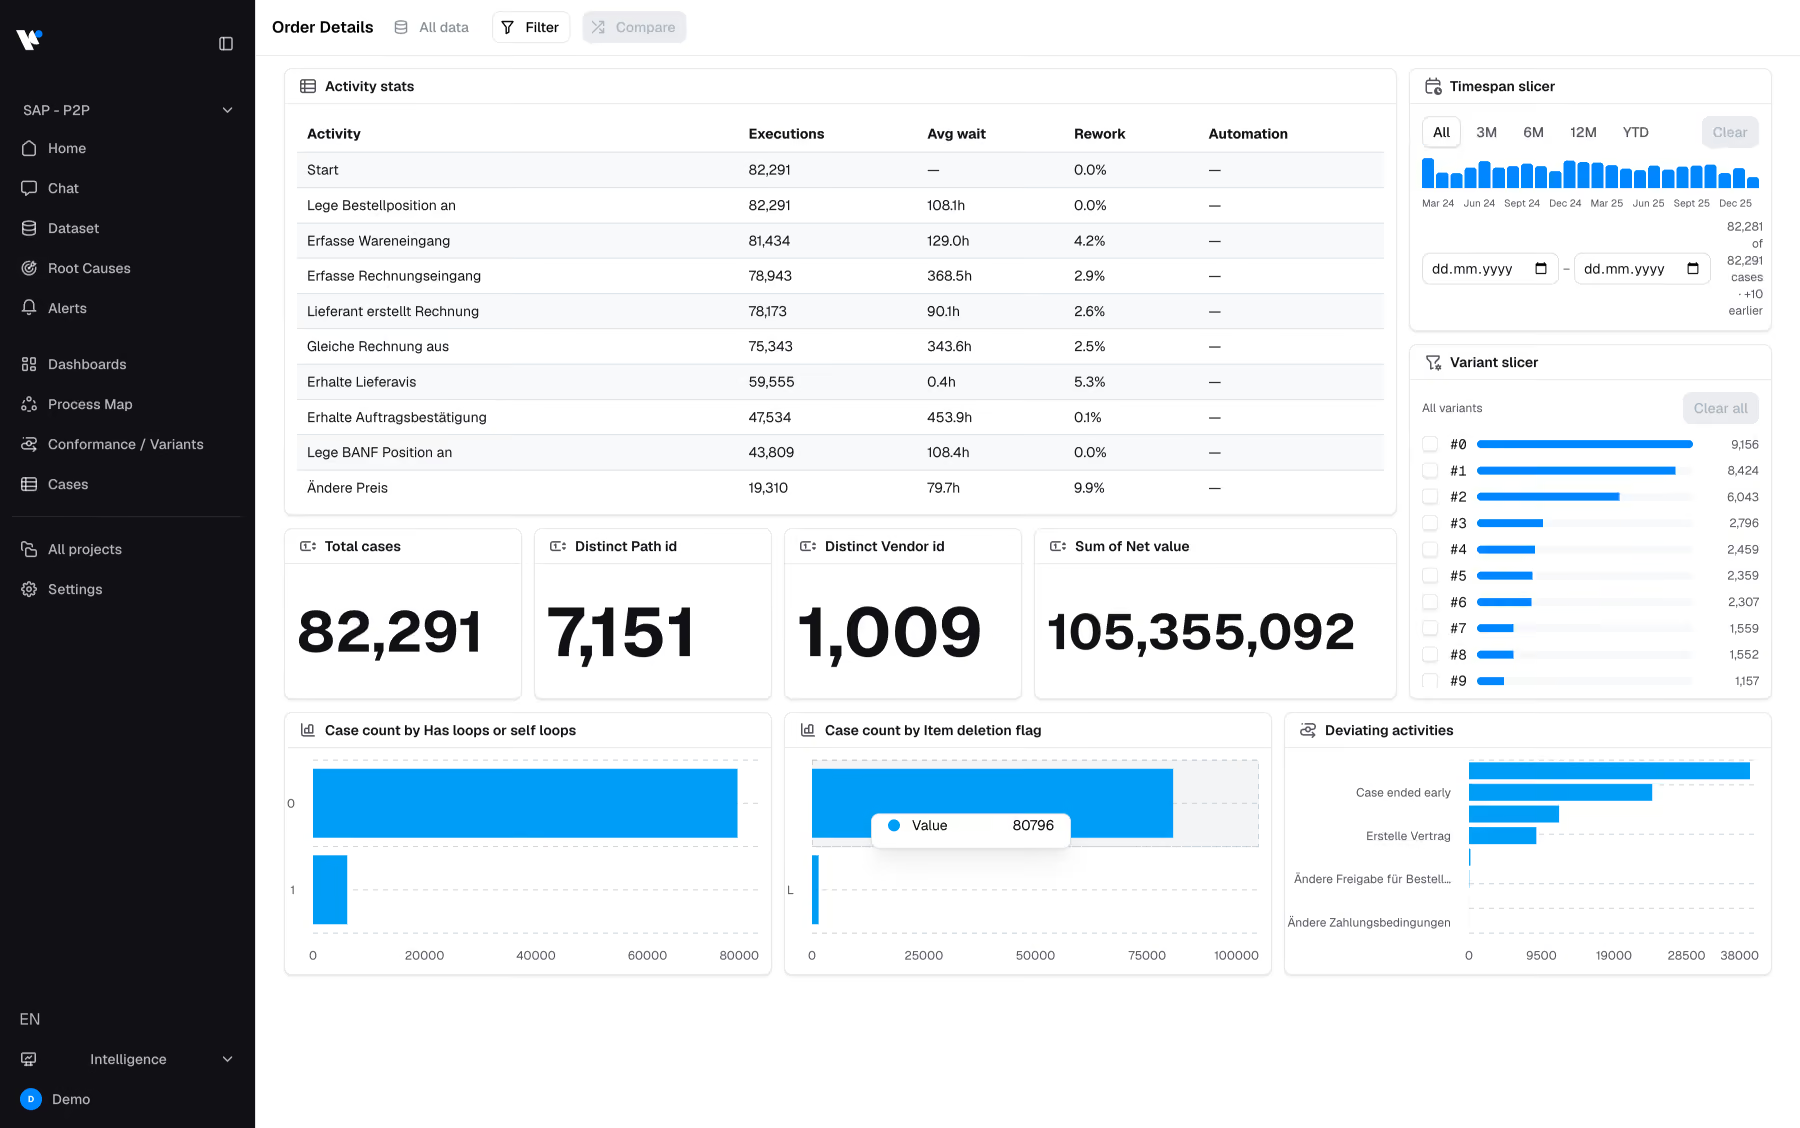
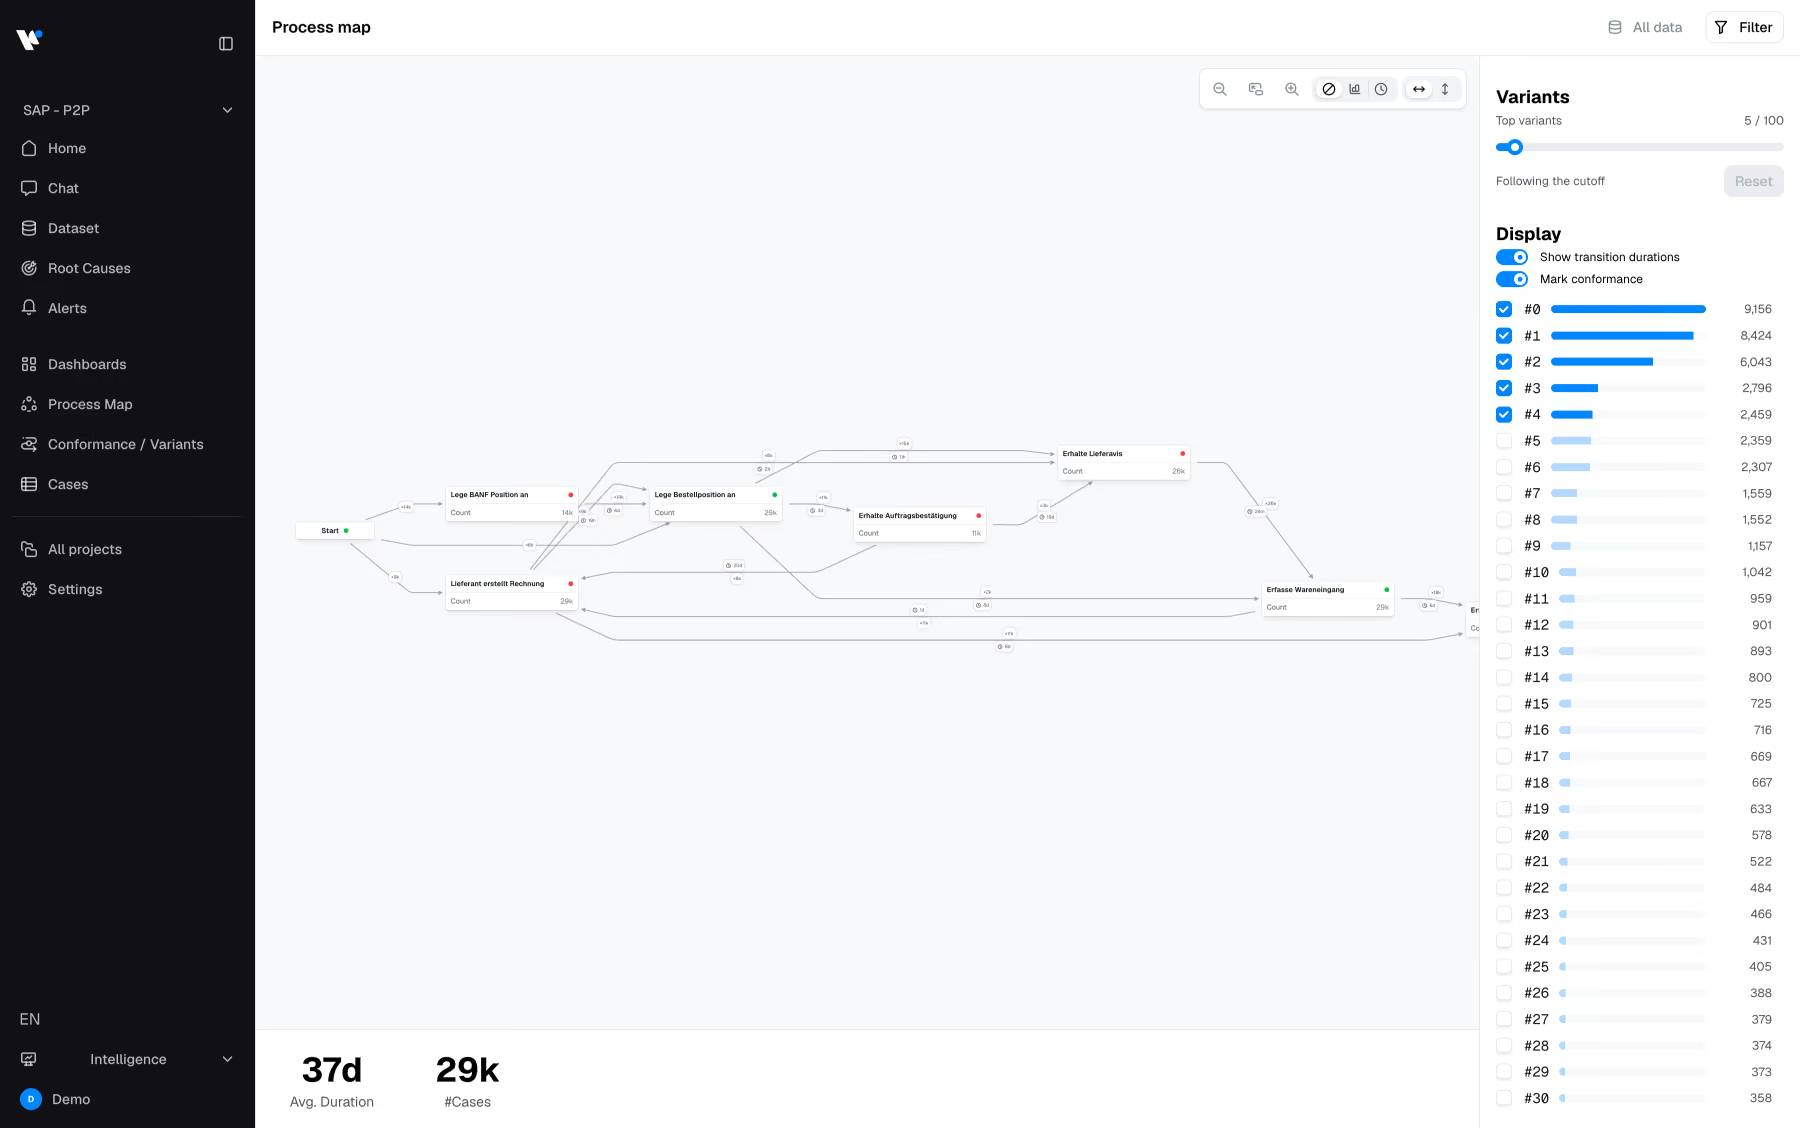
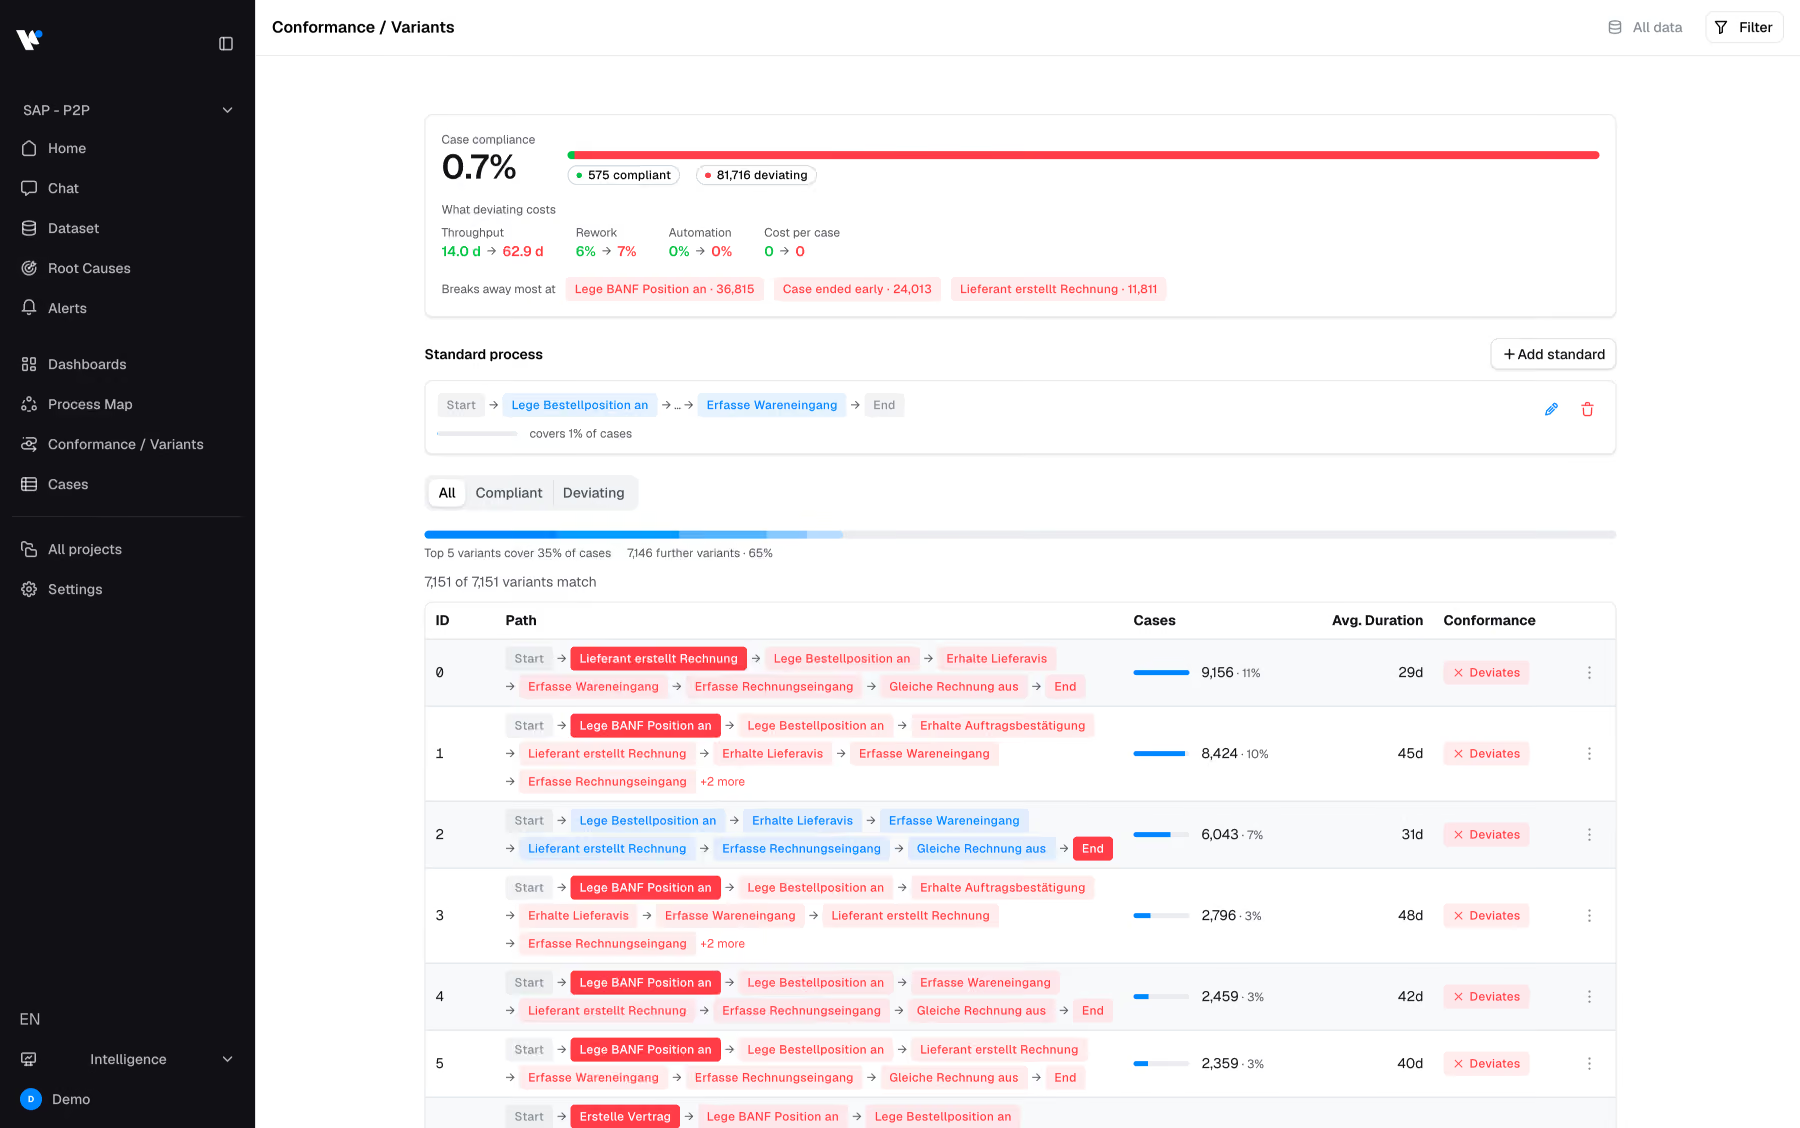

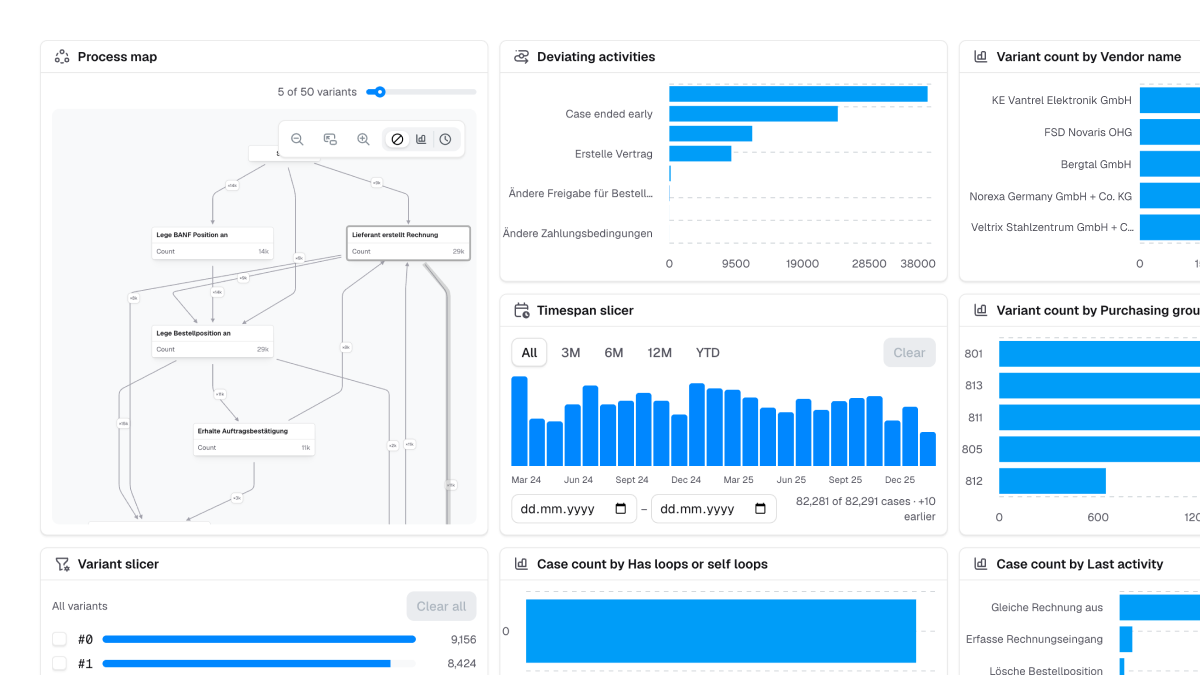
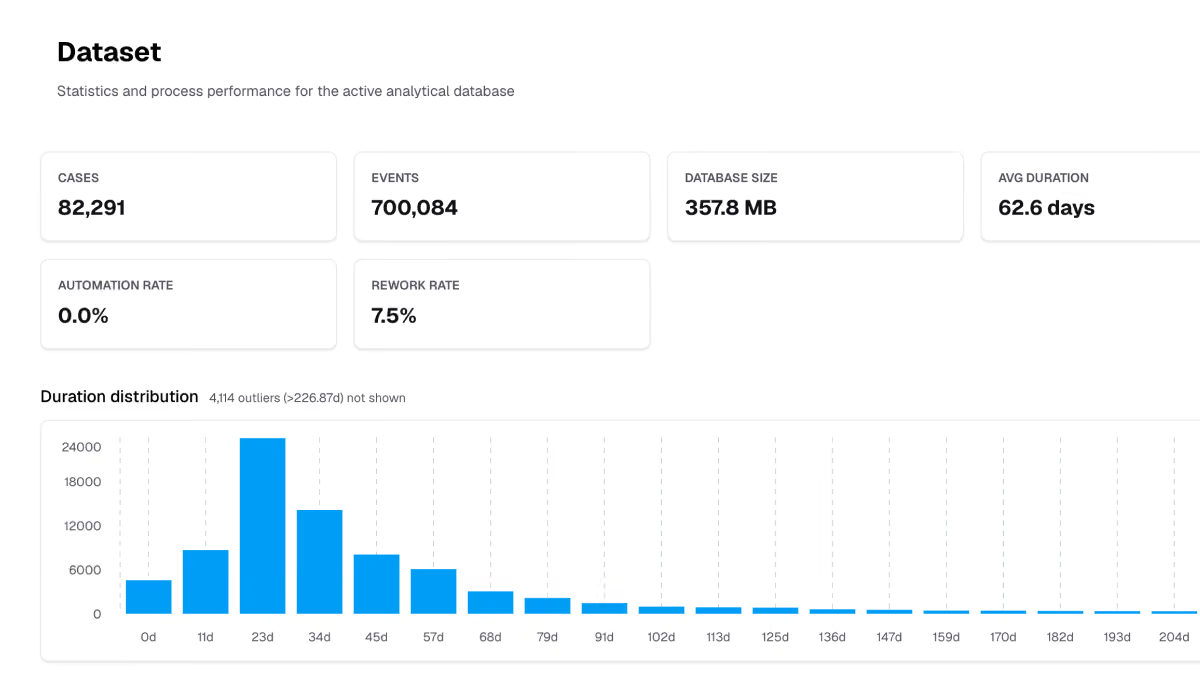
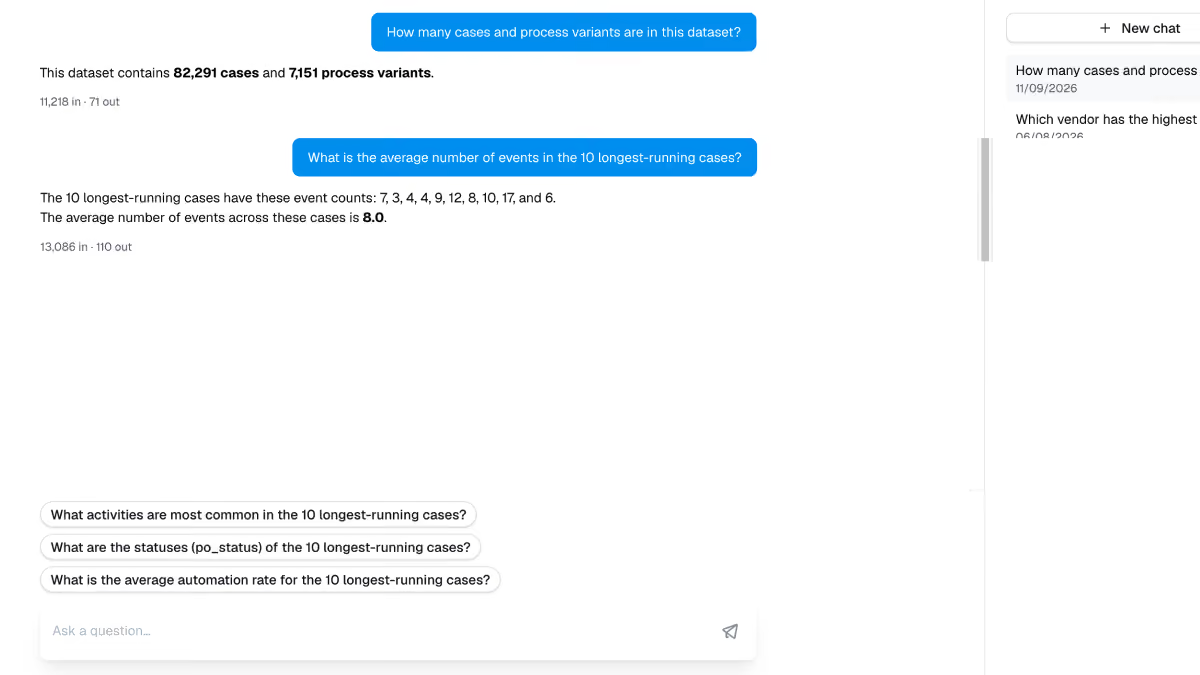
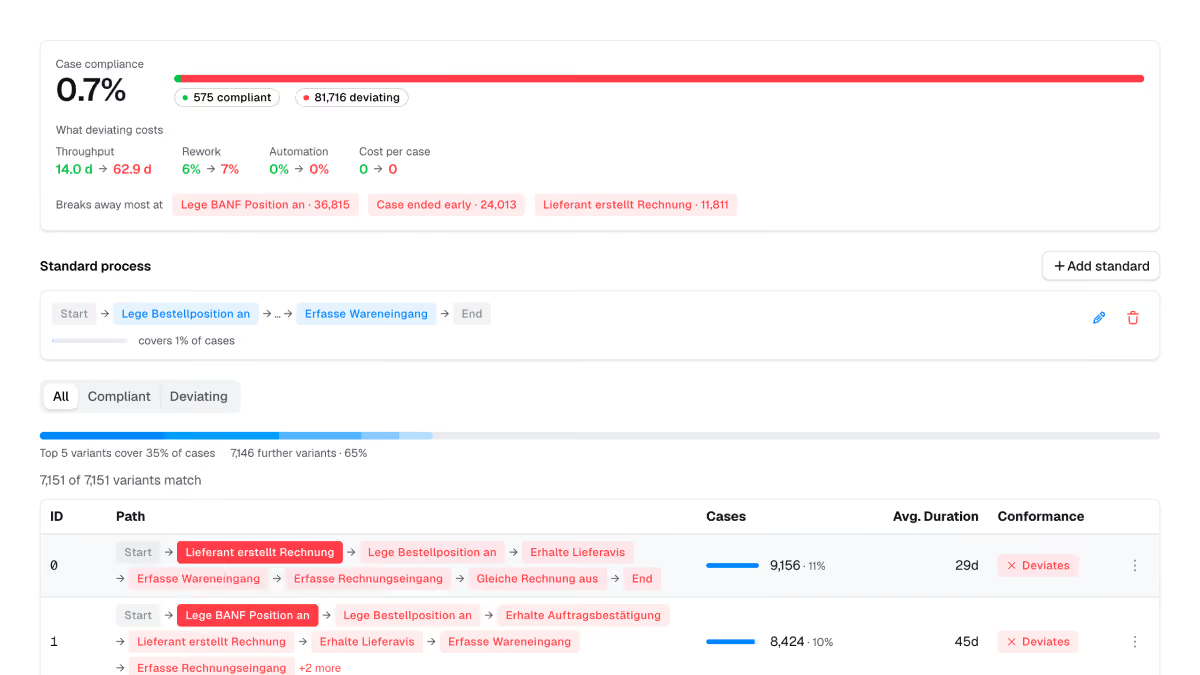
Dati estratti dai tuoi sistemi operativi, tipicamente ERP; per la maggior parte dei processi si tratta di una manciata di tabelle. Il nostro strumento di preparazione dei dati li trasforma in un registro eventi pulito, così non dovrai fornircene uno già pronto. Se possiedi già un registro eventi, possiamo lavorare anche con quello.
No. A differenza delle nostre note integrazioni per Microsoft o Qlik, process.science Intelligence è progettata come una piattaforma completamente autonoma. Tutto ciò che serve sono i dati estratti dal tuo ERP.
Intelligence include norme di processo predefinite che coprono le deviazioni tipiche di ogni flusso: cicli di rilavorazione, passaggi saltati, sequenze interrotte e tempi di attesa insoliti. Il monitoraggio inizia quindi con il primo set di dati. Nella sezione Setup è possibile affinare tali norme o salvare un processo target come riferimento, ogni volta che si desidera essere più specifici riguardo alla propria attività.
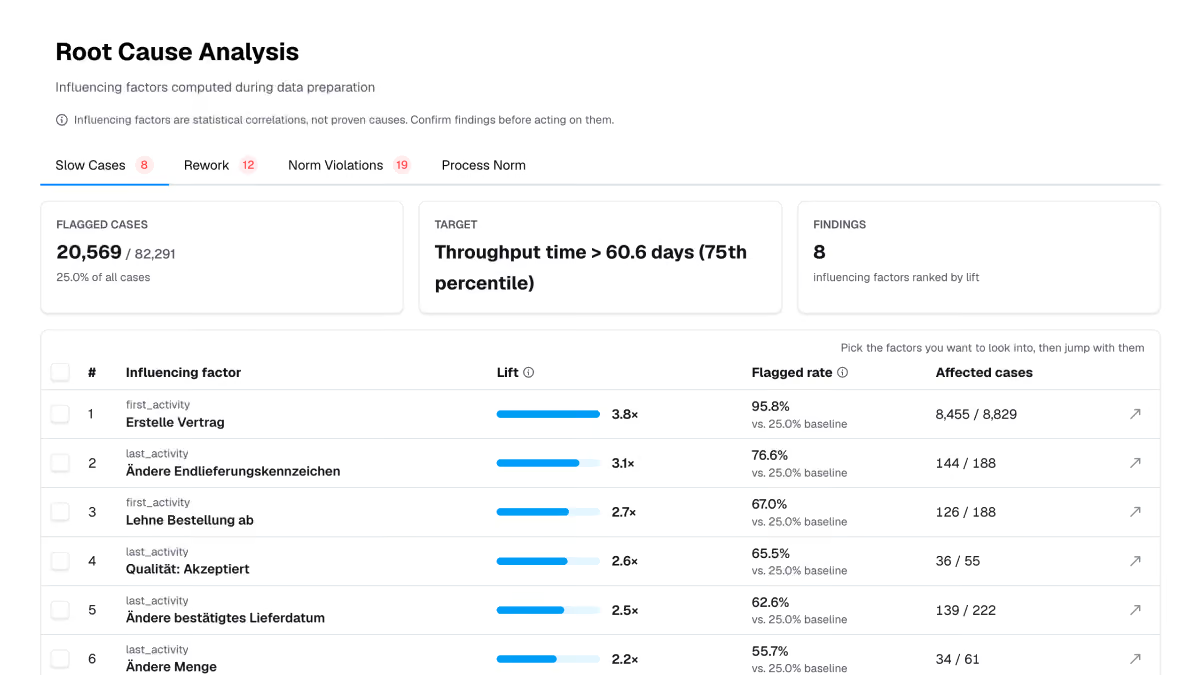
Non è necessario formulare un'ipotesi per poi cercare di confermarla tramite filtri. Intelligence analizza autonomamente i tuoi dati alla ricerca dei fattori che causano un problema, ad esempio un fornitore, uno stabilimento o un tipo di ordine che appare in modo sproporzionato tra i casi in ritardo, e li classifica in base alla forza della loro correlazione. Successivamente, ti mostra le prove a supporto di ciascun fattore, affinché il risultato possa essere verificato anziché dato per scontato. L'ultimo passaggio, ovvero stabilire che un driver sia la causa effettiva e intervenire di conseguenza, spetta sempre a chi conosce il business.
Sì, perché la chat non effettua stime. La tua domanda viene tradotta in una query sui dati di processo e la risposta deriva dagli stessi calcoli che generano le viste di analisi. Ogni risultato salvato come insight memorizza lo strumento, l'intervallo temporale, i filtri, la selezione, la popolazione interessata e la versione del set di dati, in modo che chiunque possa verificare il numero in un secondo momento.
Non sono richieste competenze di data science. Esistono tre ruoli: un amministratore per i progetti e i set di dati, un analista che configura il setup ed esegue le analisi, e gli utenti business che leggono gli insight e pongono domande nella chat. La maggior parte dell'utilizzo quotidiano spetta a chi conosce il processo, non il database.
I dati dei tuoi processi rimangono all'interno dell'ambiente concordato e non vengono mai utilizzati per addestrare modelli pubblici. I modelli linguistici che utilizziamo sono modelli aziendali isolati. Process.Science opera in conformità al GDPR ed è certificata ISO 27001; inoltre, i diritti di accesso controllano quali processi e dati ogni utente può interrogare.
Il Data Preparation Tool crea e gestisce i log degli eventi, Intelligence li analizza e l'IoT Miner aggiunge i dati di macchine e sensori laddove il processo raggiunge l'area operativa. Lavorano insieme, ma ciascuno può essere utilizzato anche singolarmente.