Automated Data Preparation

Überspringen Sie den schwersten Teilvon Process Mining

Das Process.Science Data Preparation Tool macht aus Rohdaten von SAP, Microsoft Dynamics 365 und Ihren eigenen Datenbanken analysefertige Event Logs. Kein Data-Engineering-Projekt, kein handgeschriebenes ETL. Wählen Sie einen fertigen Prozess, verbinden Sie Ihr System, und jeder geplante Lauf liefert ein vollständiges Event Log an Power BI oder an Process.Science Intelligence.

Alles vor der Analyse,schon gelöst

Schnell aufgesetzt, flexibel mit Ihren Systemen und kompromisslos bei der Qualität des Event Logs, denn alles, was Sie danach analysieren, steht darauf.
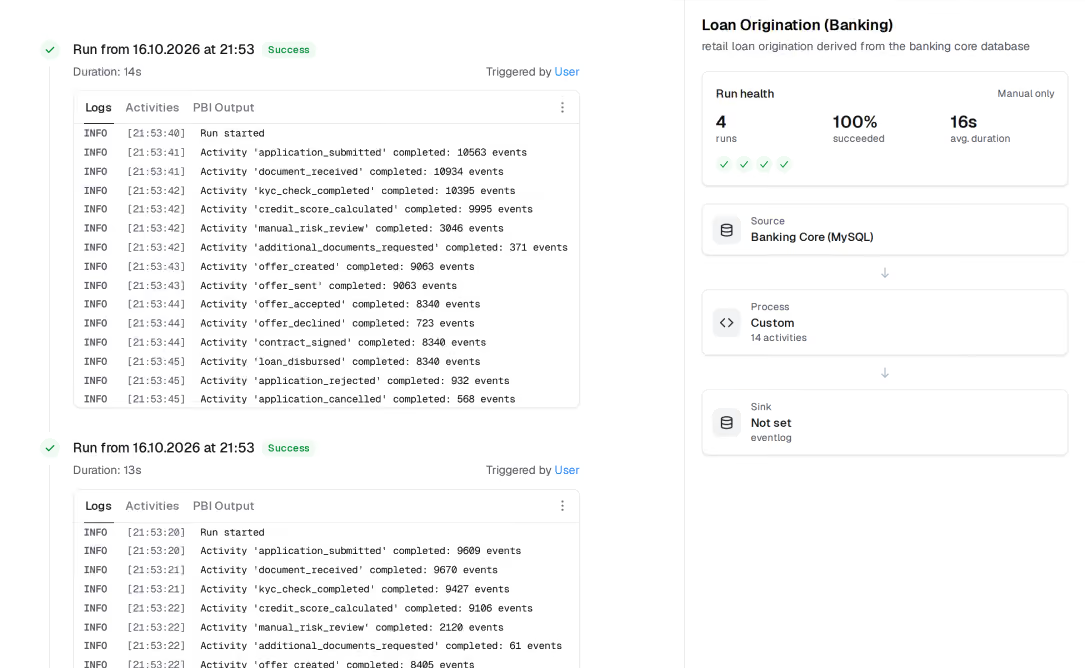
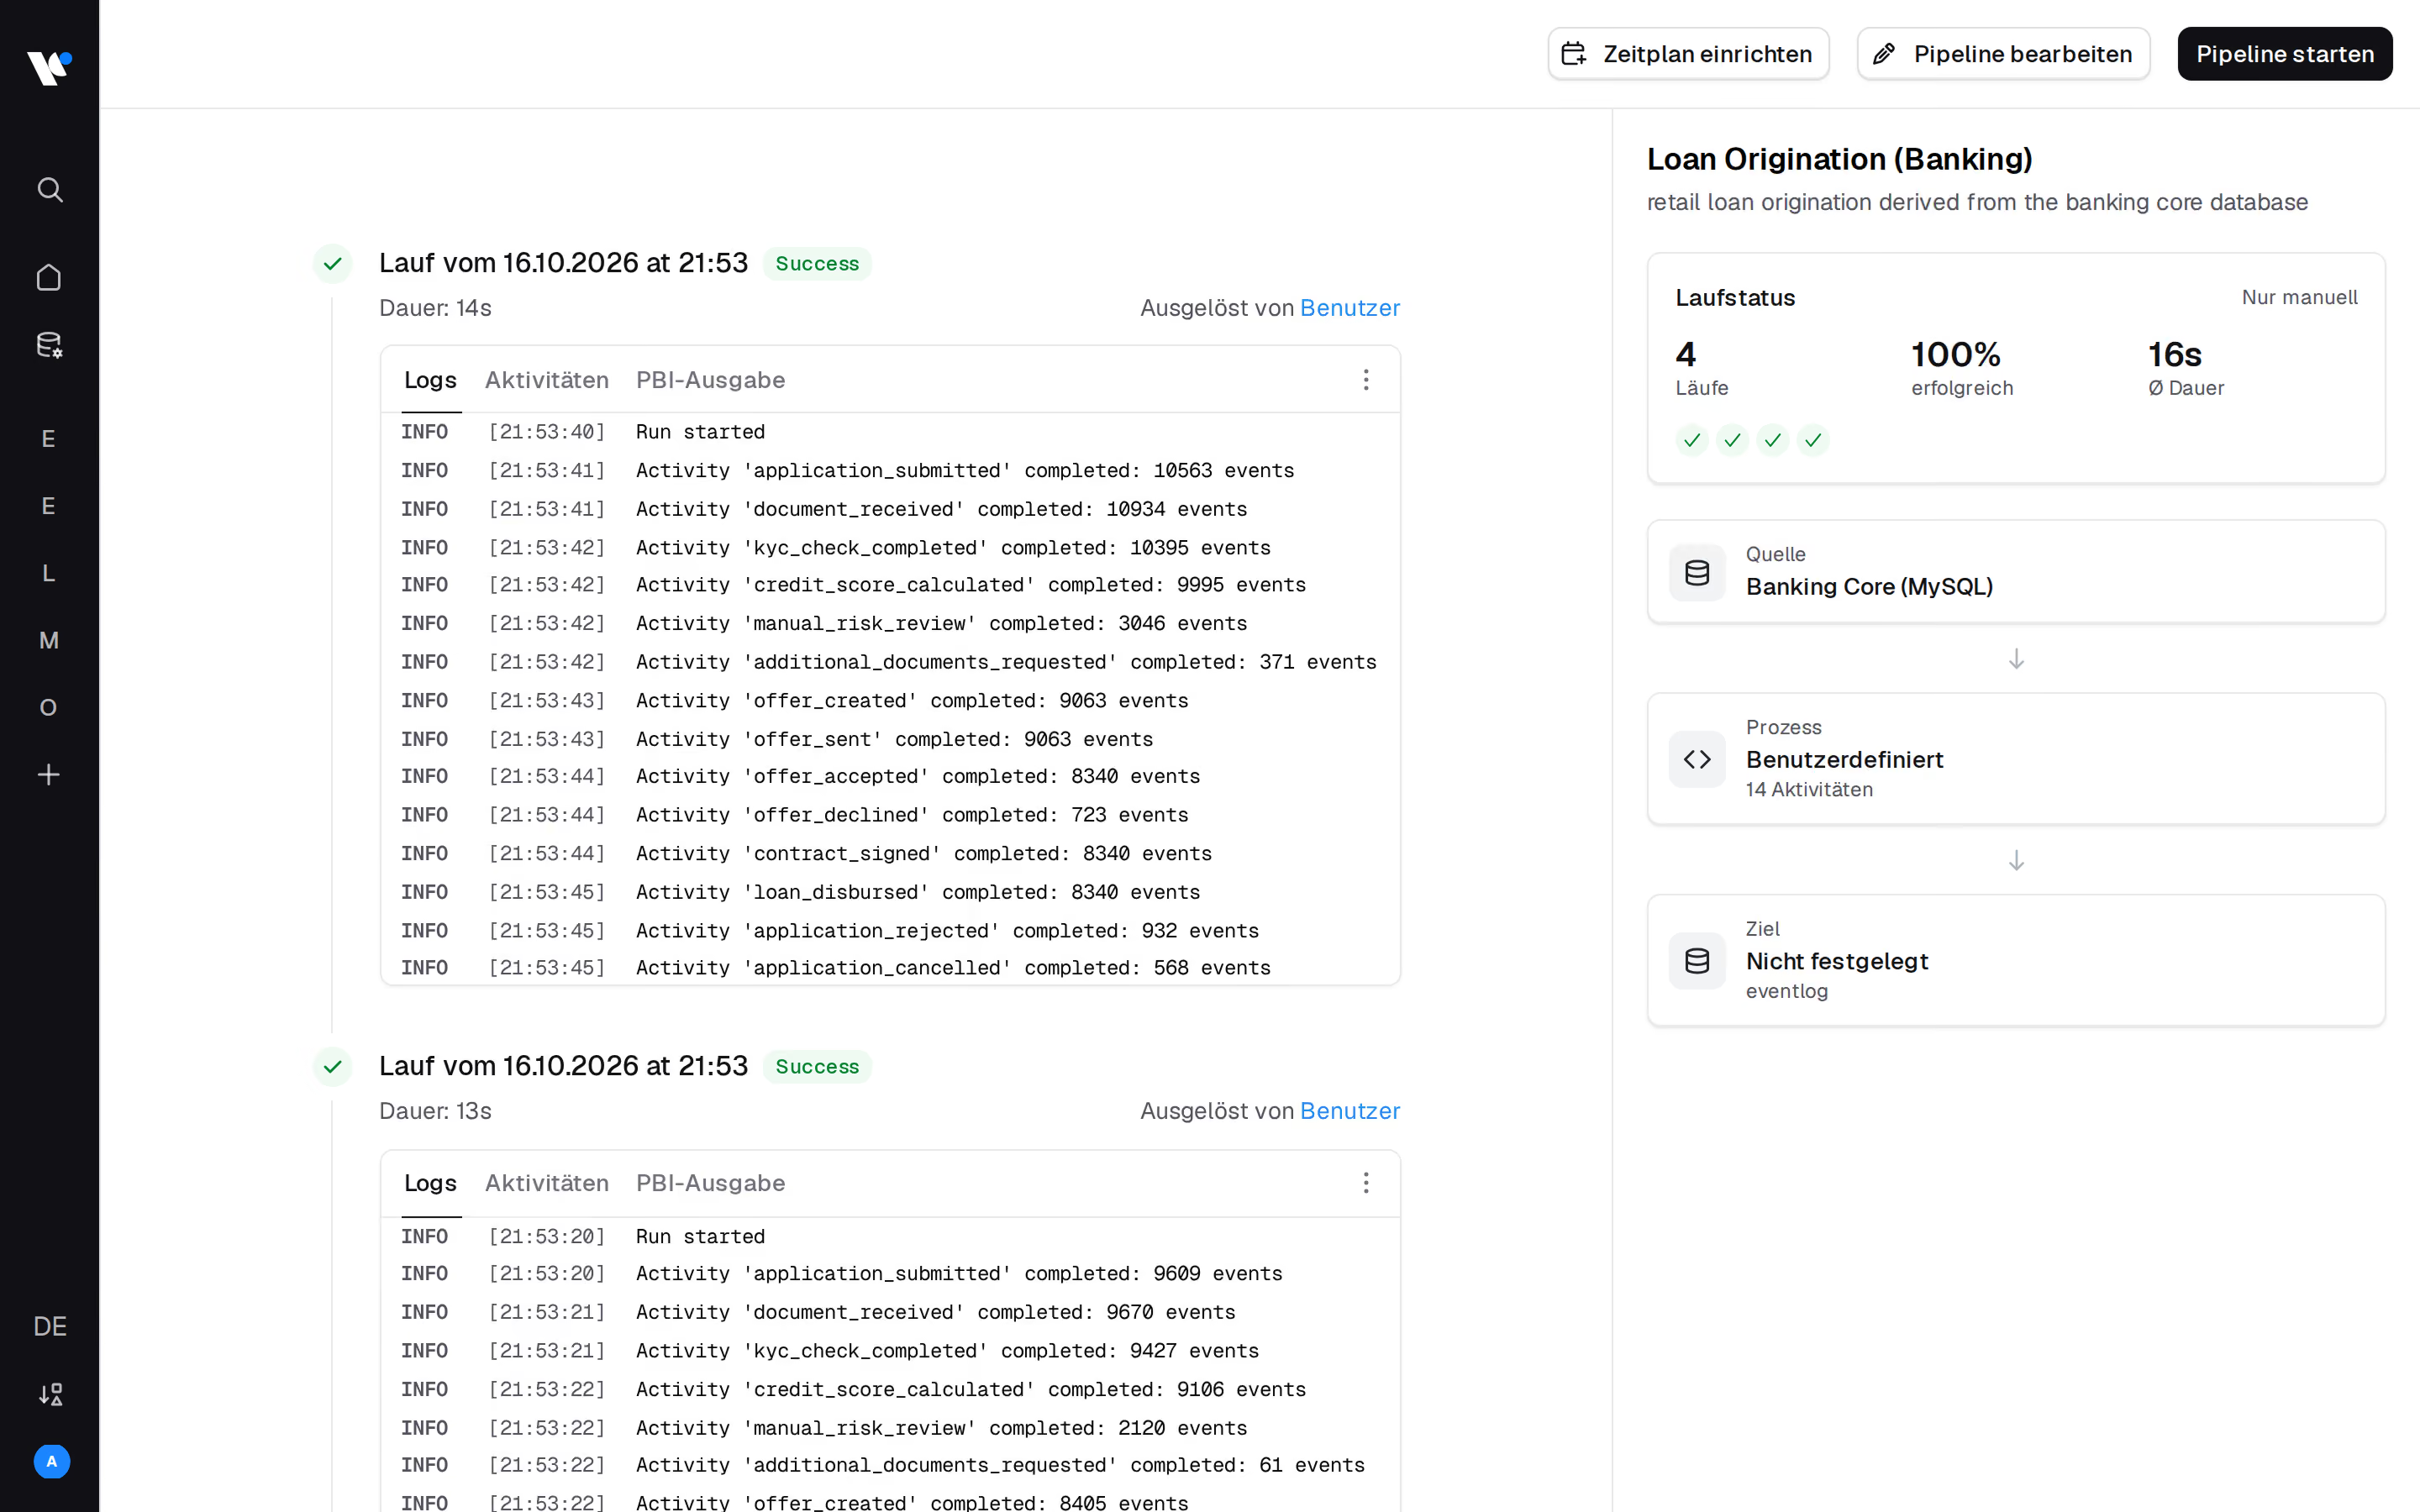
Screenshot der Benutzeroberfläche eines Kreditvergabesystems, das zwei erfolgreiche Durchläufe vom 16.10.2026 zeigt. Die Protokolle führen die Aktivitäten und Ereignisanzahlen jedes Schrittes detailliert auf, einschließlich Antragseinreichung, Dokumenteneingang, Bonitätsprüfung und Entscheidungsergebnissen. Ergänzt wird dies durch Informationen in der Seitenleiste, die den Kreditvergabeprozess zusammenfassen, einschließlich Quelldatenbank, benutzerdefinierter Prozesse und eines nicht näher spezifizierten Ereignisziels.
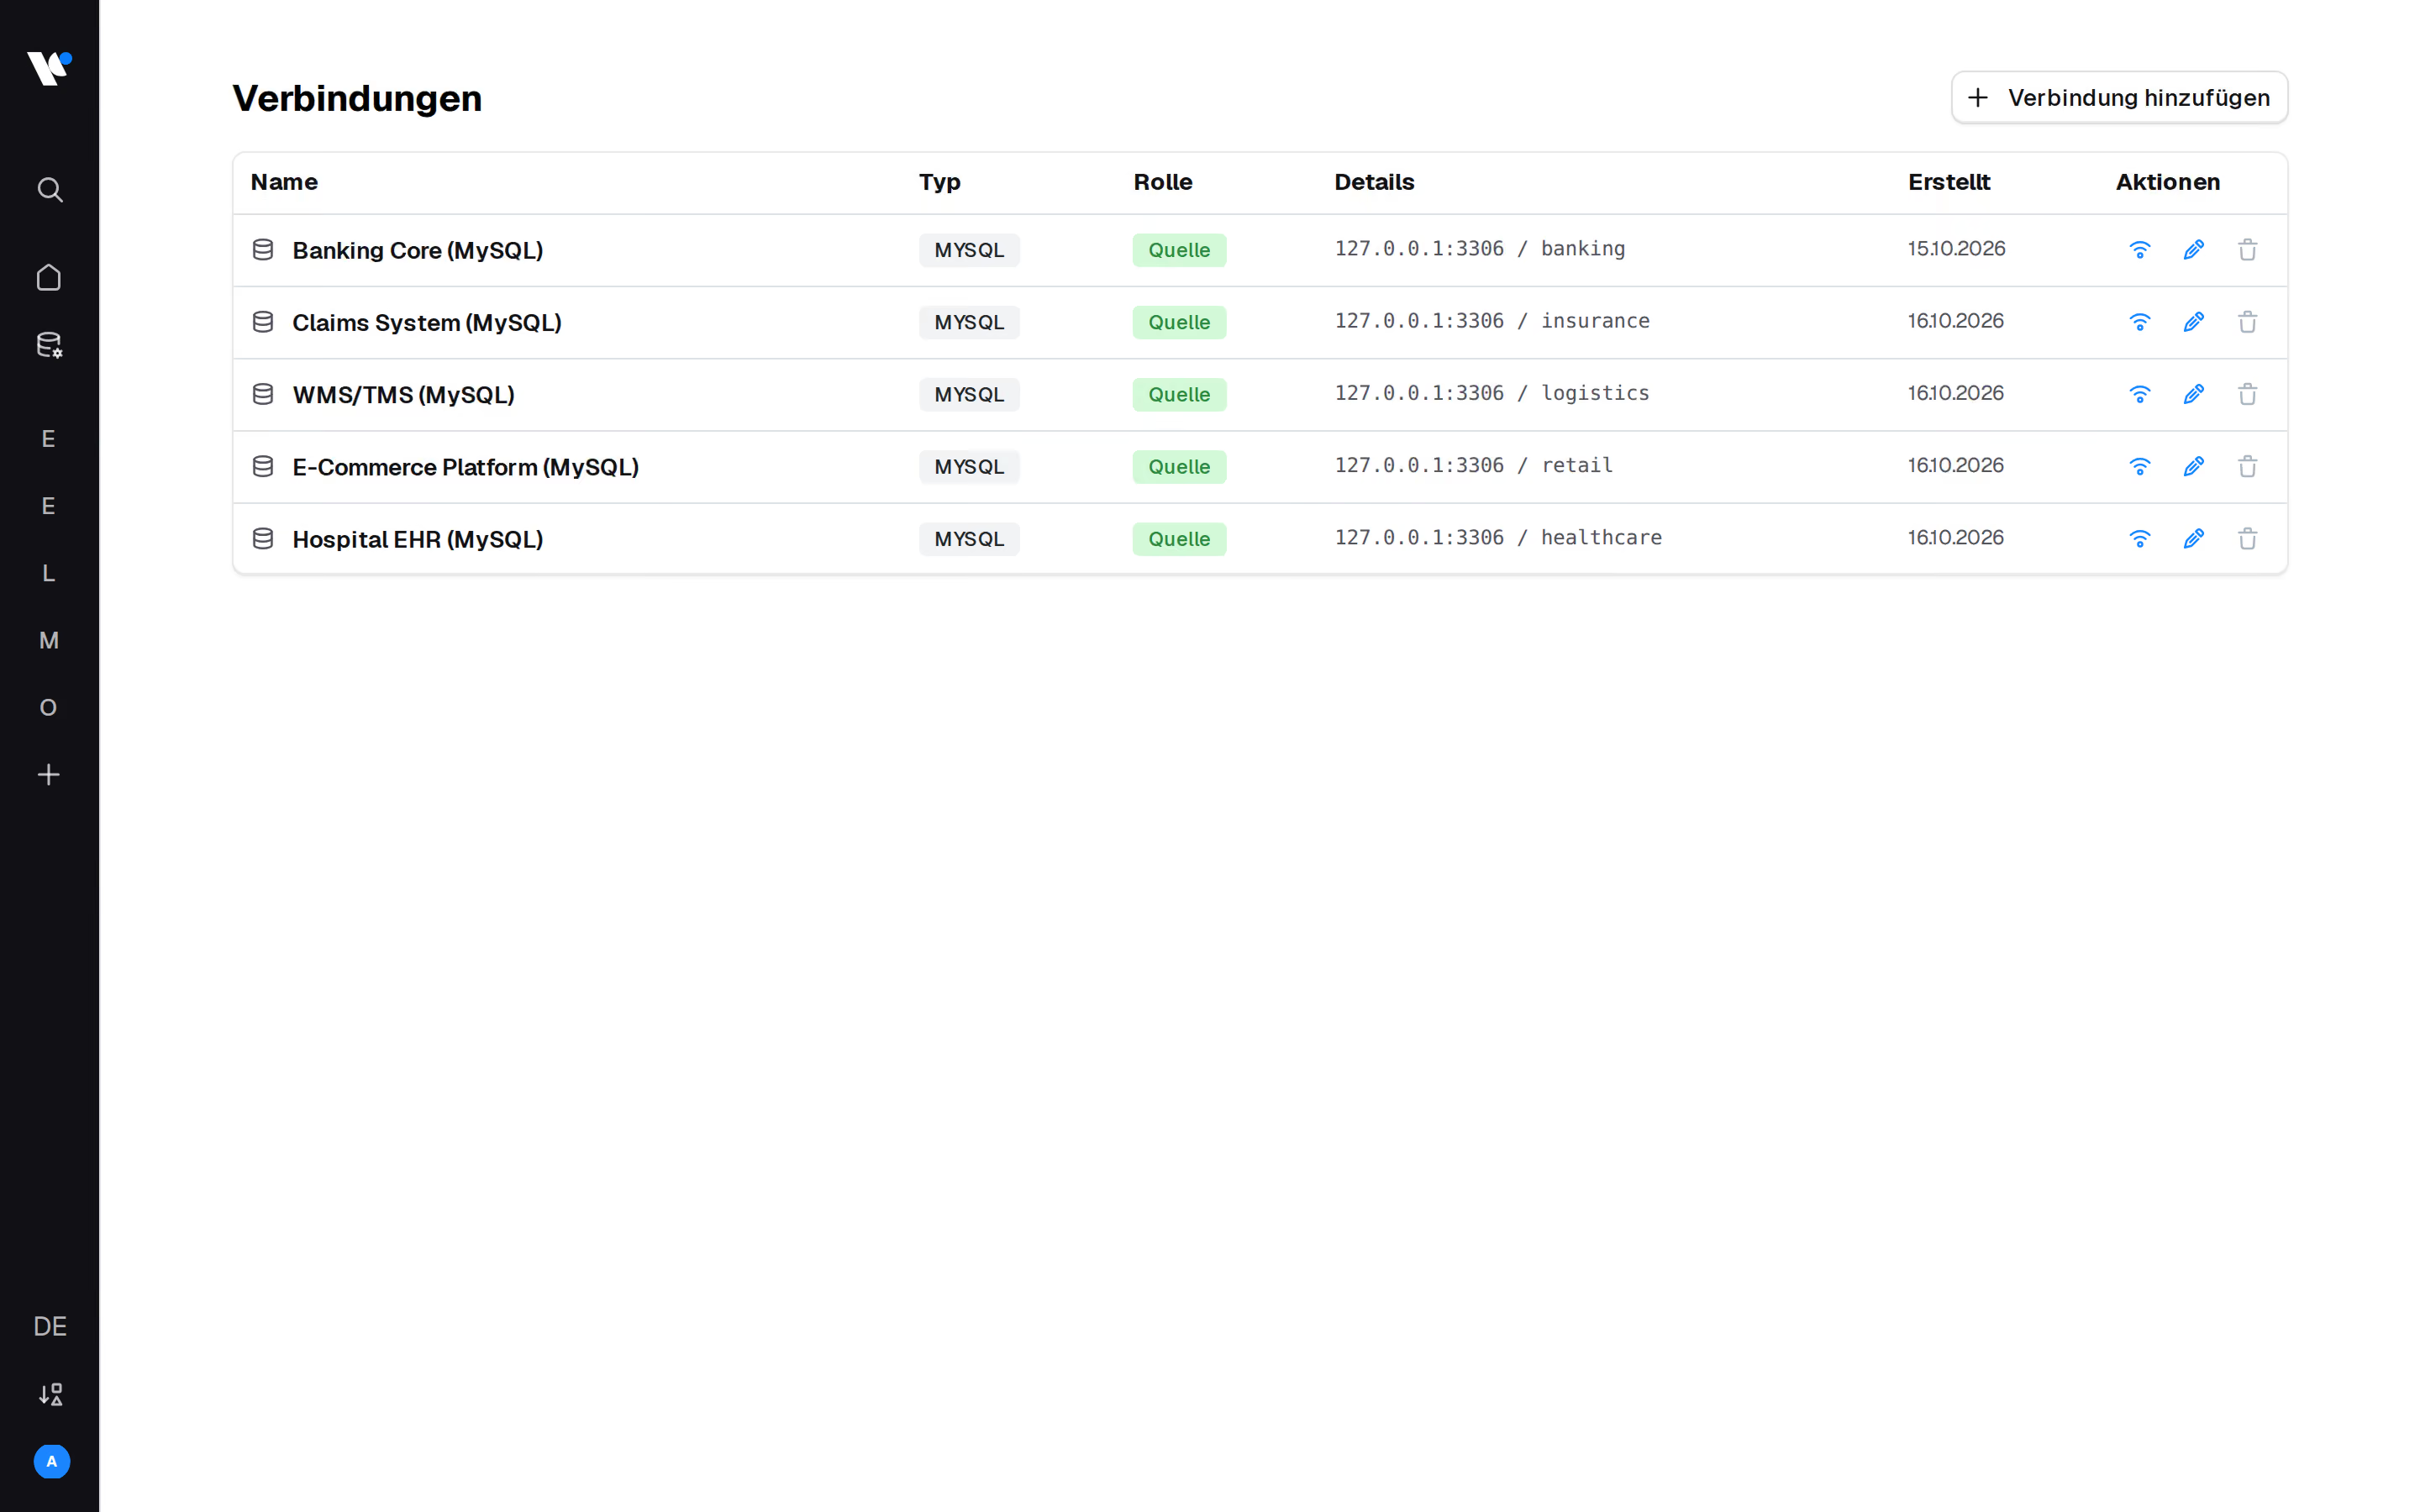
Screenshot der Software-Oberfläche mit dem Titel „Verbindungen“, die eine Liste von fünf MySQL-Datenbankverbindungen zeigt: Banking Core, Claims System, WMS/TMS, E-Commerce Platform und Hospital EHR. Jede Verbindung ist als „Quelle“ gekennzeichnet, verfügt über die IP-Adresse 127.0.0.1:3306 mit entsprechenden Domain-Suffixen, ein Erstellungsdatum im Oktober 2026 sowie Aktionssymbole für Einstellungen, Berechtigungen und Löschvorgänge.
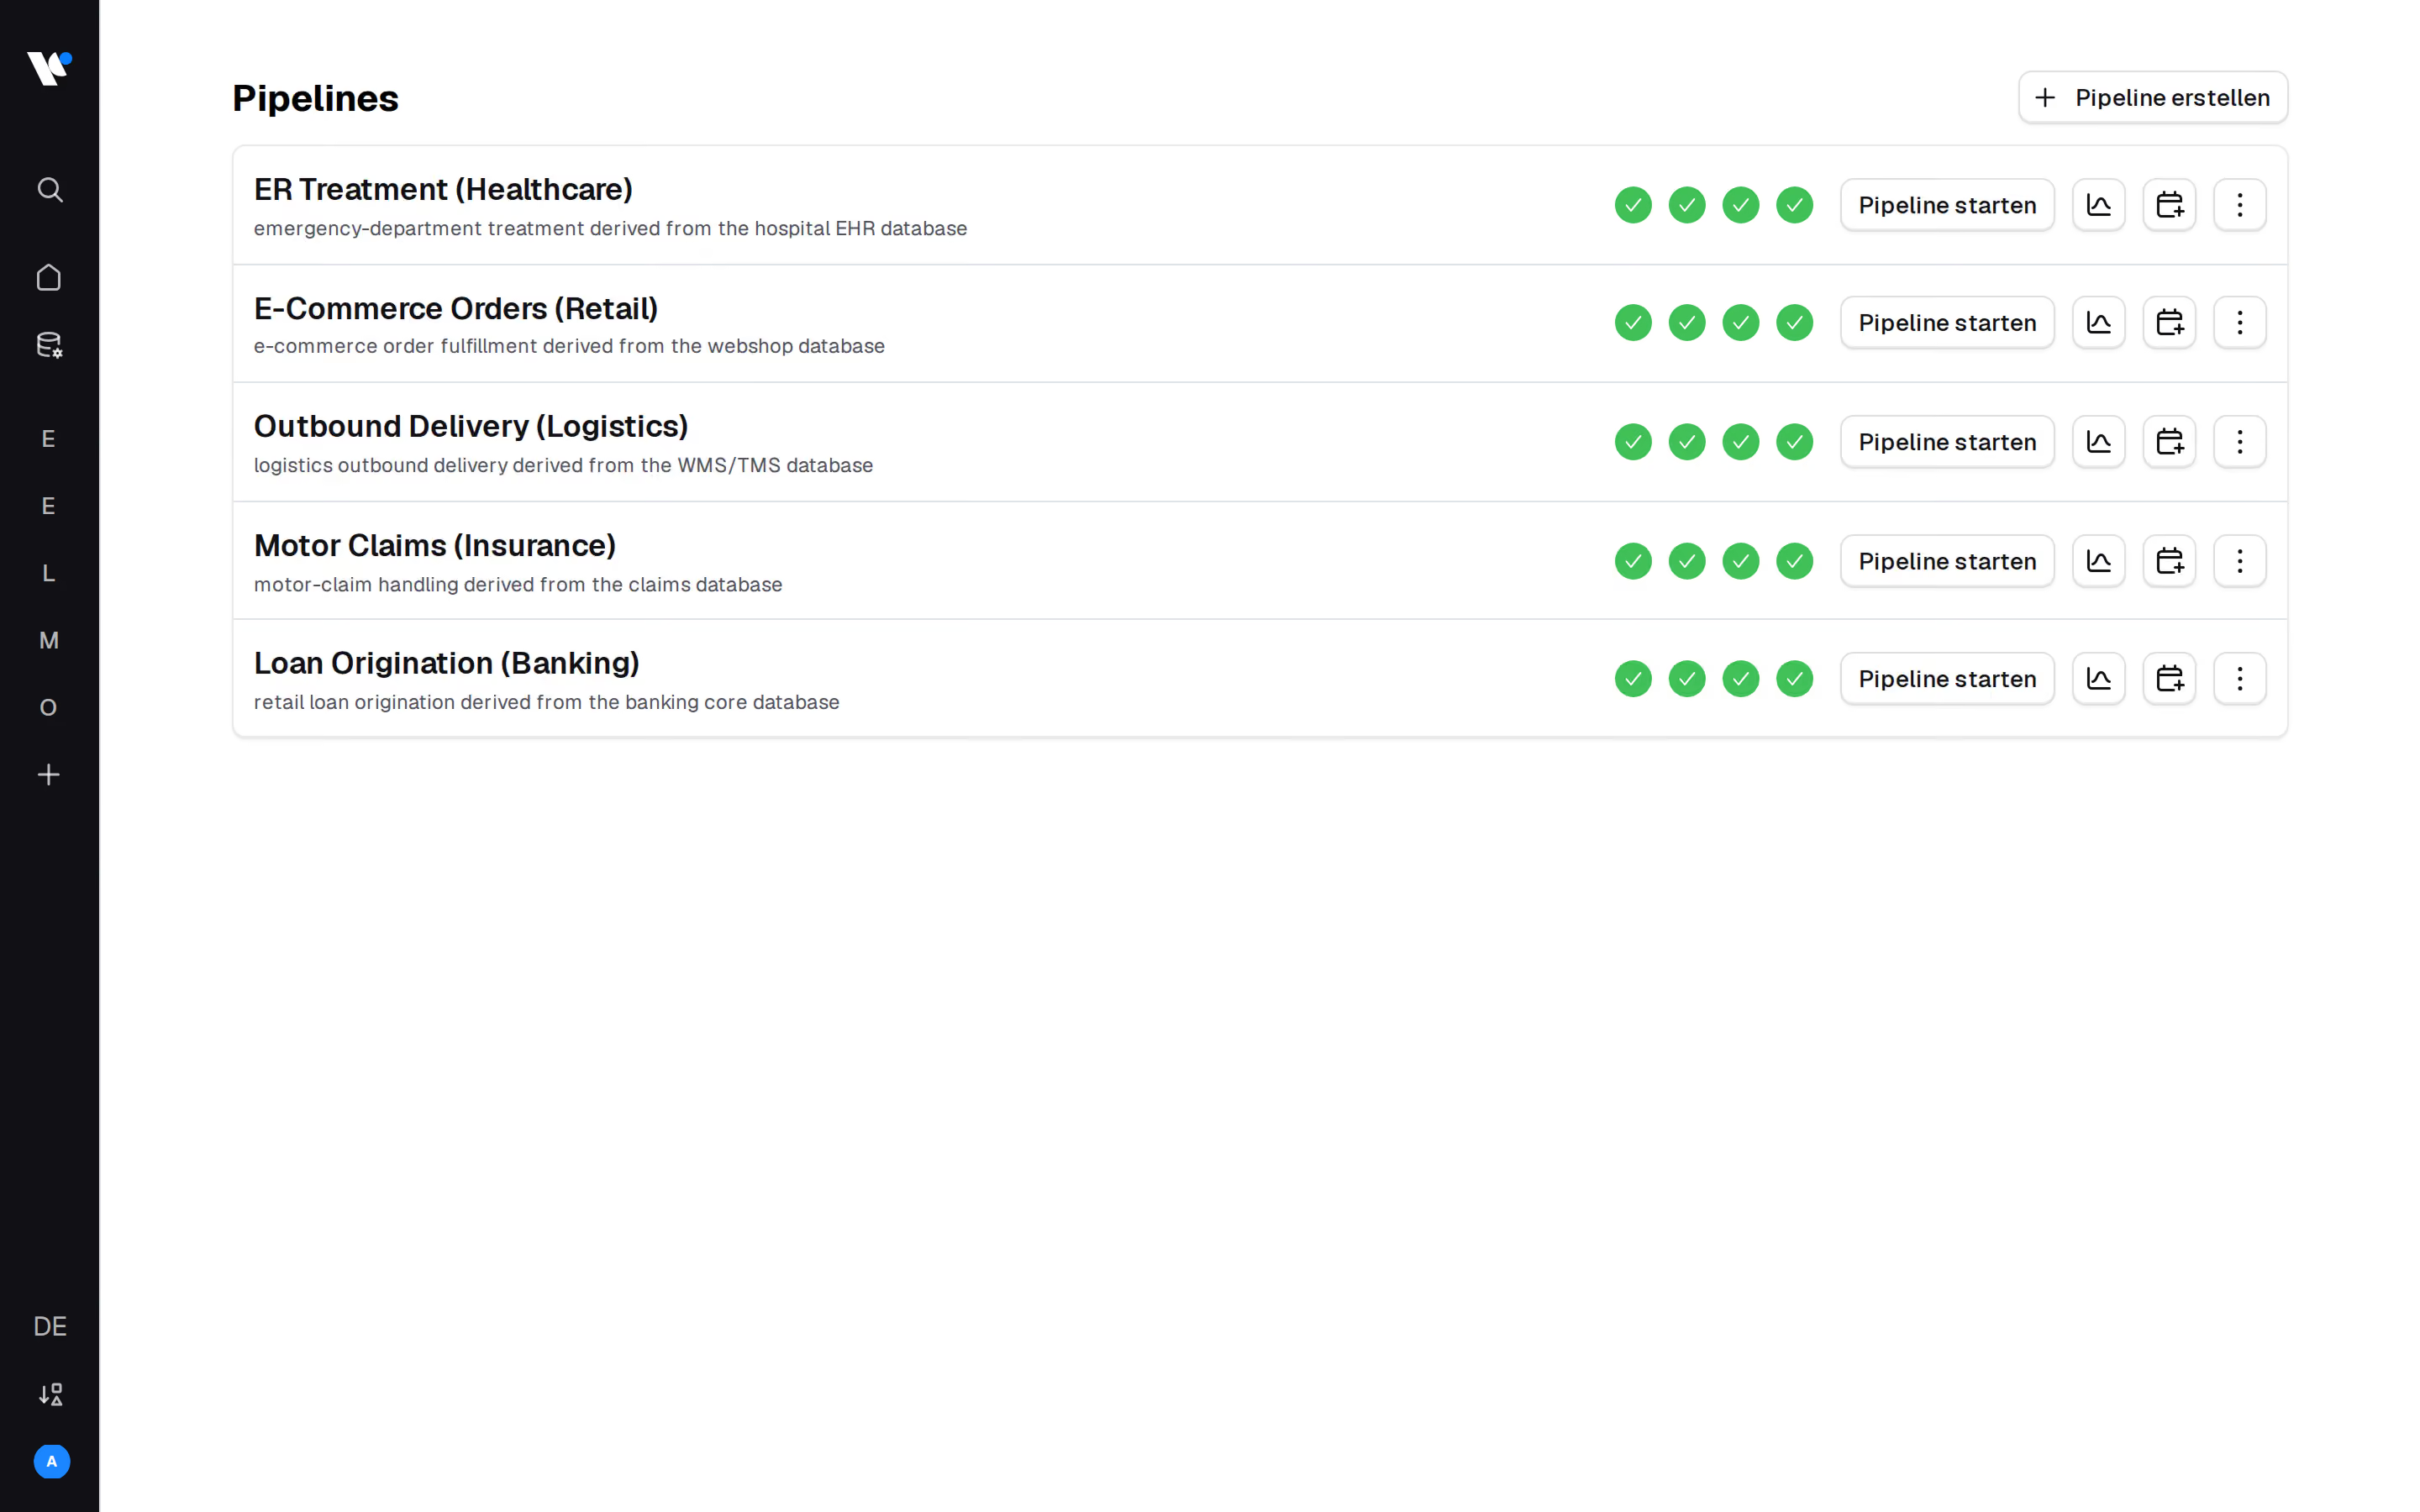
Dashboard-Ansicht mit einer Liste von fünf Daten-Pipelines: ER Treatment (Gesundheitswesen), E-Commerce Orders (Einzelhandel), Outbound Delivery (Logistik), Motor Claims (Versicherung) und Loan Origination (Bankwesen). Jede Pipeline enthält eine Beschreibung, eine Statusanzeige mit grünem Häkchen sowie Schaltflächen zum Starten der Pipeline oder zum Aufrufen der Analysedaten.
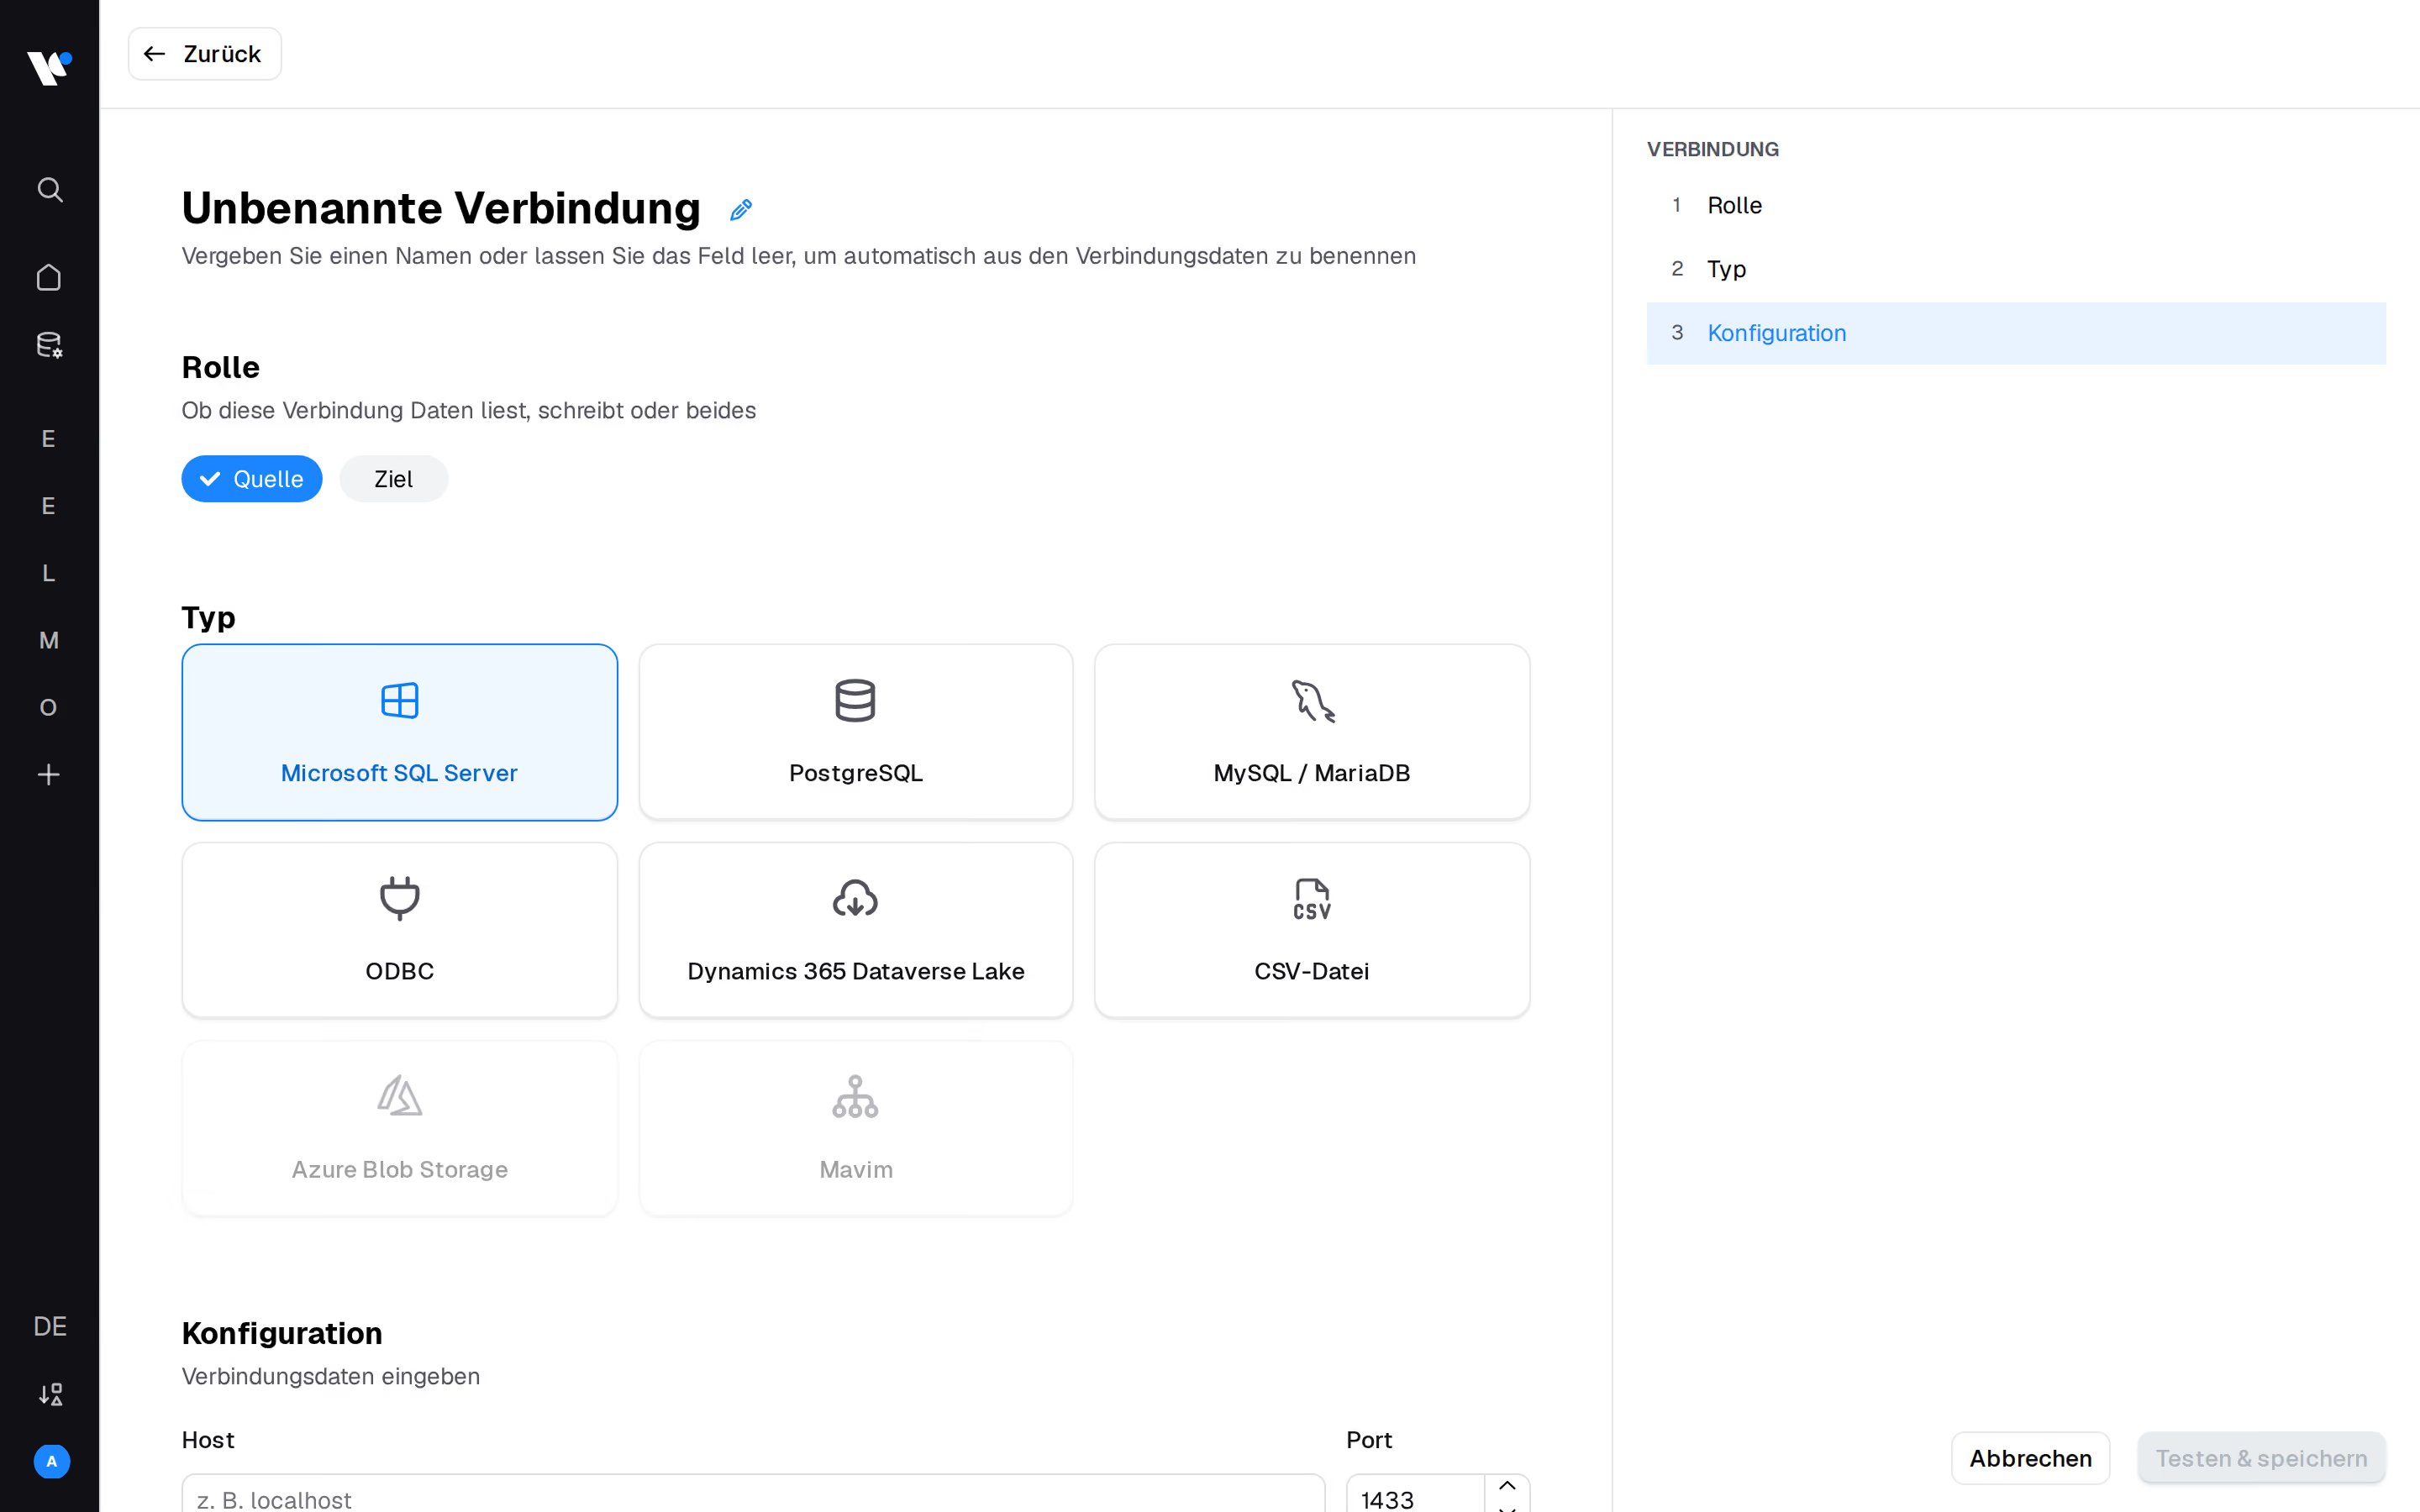
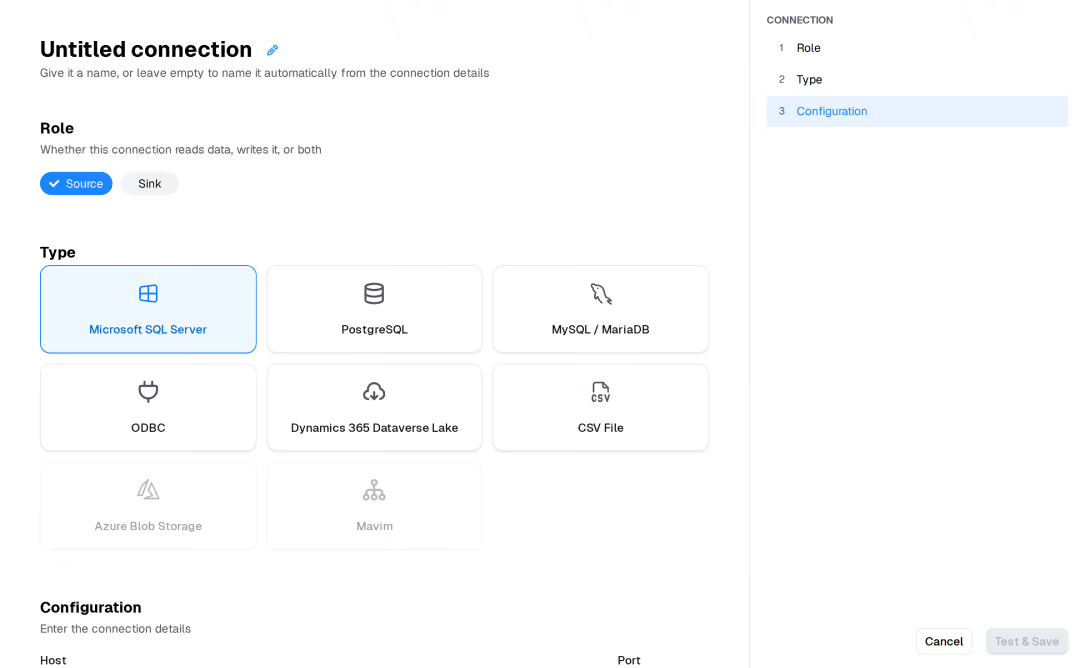
Benutzeroberfläche für die Einrichtung einer Datenbankverbindung mit dem Titel „Unbenannte Verbindung“. Es gibt Optionen zur Auswahl der Rolle als Quelle oder Ziel sowie eine Auswahl an Datenbanktypen, darunter Microsoft SQL Server, PostgreSQL, MySQL/MariaDB, ODBC, Dynamics 365 Dataverse Lake und CSV-Datei. Die Optionen für Azure Blob Storage und Mavim sind deaktiviert. Konfigurationsfelder für Host und Port (Standard 1433) sind sichtbar, ebenso wie Schaltflächen für „Abbrechen“ und „Testen & Speichern“ sowie eine Navigationsleiste auf der linken Seite.
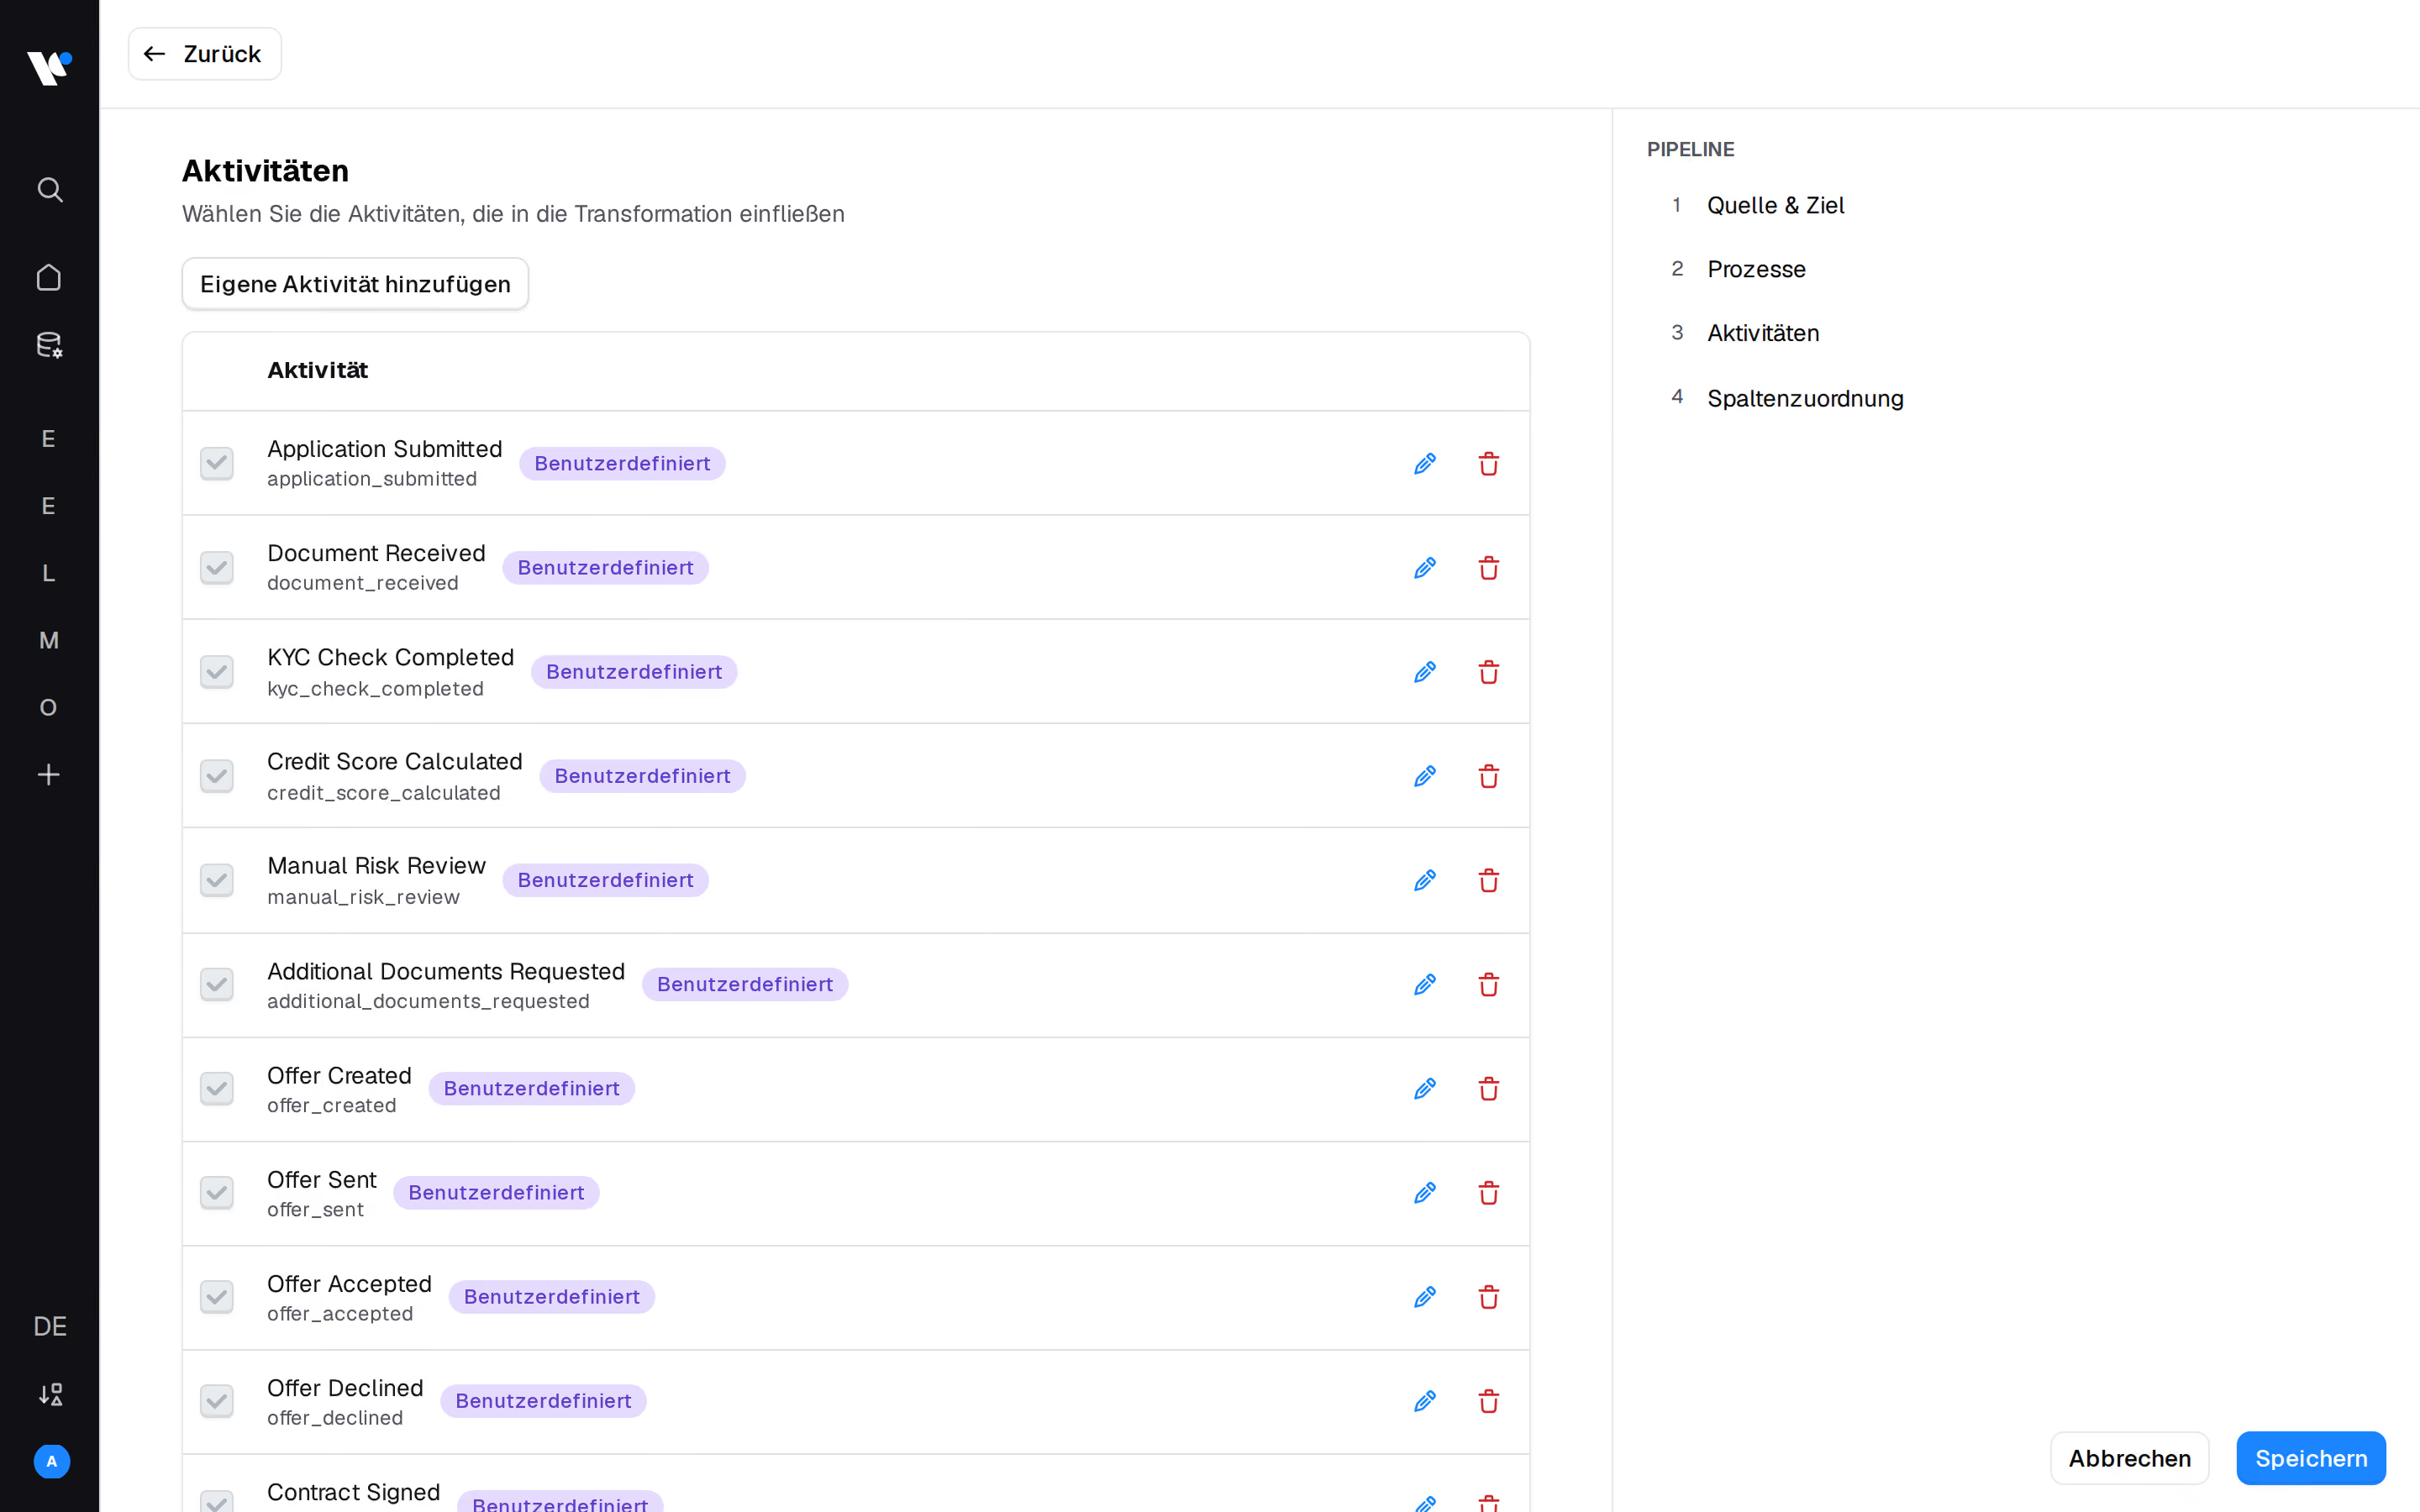
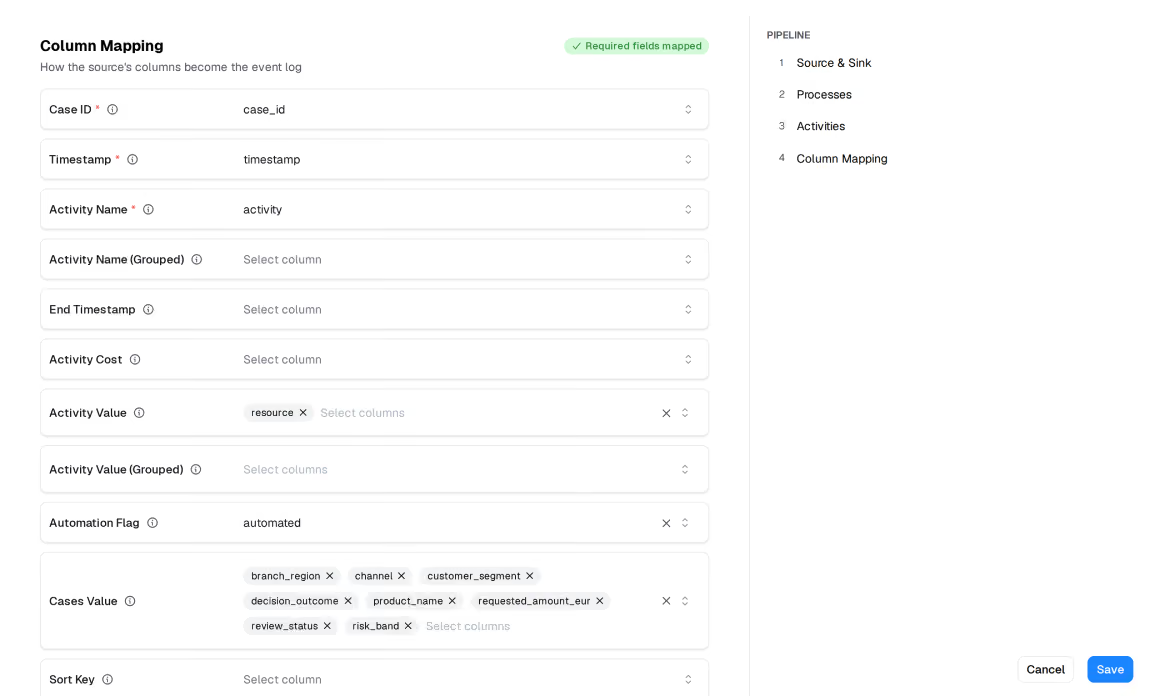
Benutzeroberfläche mit einer Liste auswählbarer Aktivitäten innerhalb eines Workflows oder einer Pipeline. Jede Aktivität verfügt über ein Kontrollkästchen und umfasst die Schritte: Antrag eingereicht, Dokument erhalten, KYC-Prüfung abgeschlossen, Kreditwürdigkeit berechnet, manuelle Risikoprüfung, zusätzliche Dokumente angefordert, Angebot erstellt, Angebot versendet, Angebot angenommen, Angebot abgelehnt und Vertrag unterzeichnet. Jede Aktivität ist mit einem benutzerdefinierten Tag sowie Symbolen zum Bearbeiten oder Löschen versehen. Auf der rechten Seite befindet sich ein Pipeline-Navigationsmenü mit den Phasen: Quelle & Ziel, Prozesse, Aktivitäten, Spaltenzuordnung. Unten rechts befinden sich Schaltflächen mit der Aufschrift „Abbrechen“ und „Speichern“.

Das 80/20-Problem, umgedreht

Der größte Teil des Aufwands geht sonst in das Finden und Aufbereiten der Daten. Templates und automatische Anreicherung erledigen das einmal, zu Projektbeginn.

Das Systemlabyrinth, schon kartiert

ERP-, CRM- und ITSM-Systeme haben Zehntausende Tabellen. Für die gängigen Prozesse haben wir die relevanten entschlüsselt. Niemand sucht mehr den Zeitstempel.

Mehr als Fall, Aktivität, Zeitstempel

Ein nacktes Event Log reicht nicht. Jeder Lauf kommt mit Stammdaten, Dauern, Varianten, Kosten und Automatisierungsgrad. Sie analysieren, statt zu modellieren.
Die Process.Science Formel

Weniger Data Engineering,mehr Prozessanalyse

Manuelles SQL-Scripting

Funktioniert, bis sich das Quellsystem ändert. Schwer zu dokumentieren, schwer zu übergeben, und ein Schema-Update kann die gesamte Logik zerlegen.

Schwere ETL-Suiten

Gebaut für Data Warehousing, nicht für Process Mining. Sie bewegen Daten zuverlässig, aber sie wissen nicht, was eine Aktivität, ein Fall oder eine Variante ist.

Process.Science Data Preparation Tool

Gebaut für eine Aufgabe: aus operativen Daten Event Logs zu machen. Es kennt die Prozesse, reichert sie mit Stammdaten an und liefert für jeden Prozess und jedes Quellsystem dieselbe Ausgabestruktur.
Bereit für die Analyse? Wählen Sie Ihr Zielsystem:

In drei Schritten von Rohdatenzum fertigen Event Log

System verbinden, Prozess wählen, Zeitplan setzen. Ab da liefert jeder Lauf dasselbe vollständige Event Log.

01. Verbinden

Wählen Sie Ihr System: Microsoft SQL Server oder Azure SQL, PostgreSQL, MySQL oder MariaDB, Microsoft Dynamics 365 oder einen einfachen CSV-Upload. Verbindungsdaten eintragen, testen und speichern, dann festlegen, wohin die Ergebnisse gehen sollen.

02. Prozess wählen

Starten Sie mit einem fertigen Template wie SAP Purchase-to-Pay und wählen Sie die Aktivitäten aus, die für Sie zählen. Die Templates wissen bereits, in welchen Spalten Fall, Aktivität und Zeit stehen.

03. Starten oder einplanen

Starten Sie die Pipeline einmal, oder lassen Sie sie stündlich, täglich, wöchentlich, monatlich oder nach Ihrer eigenen Cron-Regel laufen. Über die API können Sie einen Lauf auch aus Ihren eigenen Werkzeugen heraus auslösen.
Out-of-the-box setup

Erprobte Templates, offen bis zur letzten Zeile SQL

Fangen Sie nicht bei null an. Wir haben die Tabellenstrukturen der Systeme entschlüsselt, mit denen die meisten Unternehmen starten, und jedes Template bleibt Ihres zum Ändern.
Bereit für Ihre Kernprozesse:SAP und Microsoft Dynamics 365, Purchase-to-Pay und Order-to-Cash. Für SAP P2P zusätzlich eine objektzentrische Variante.
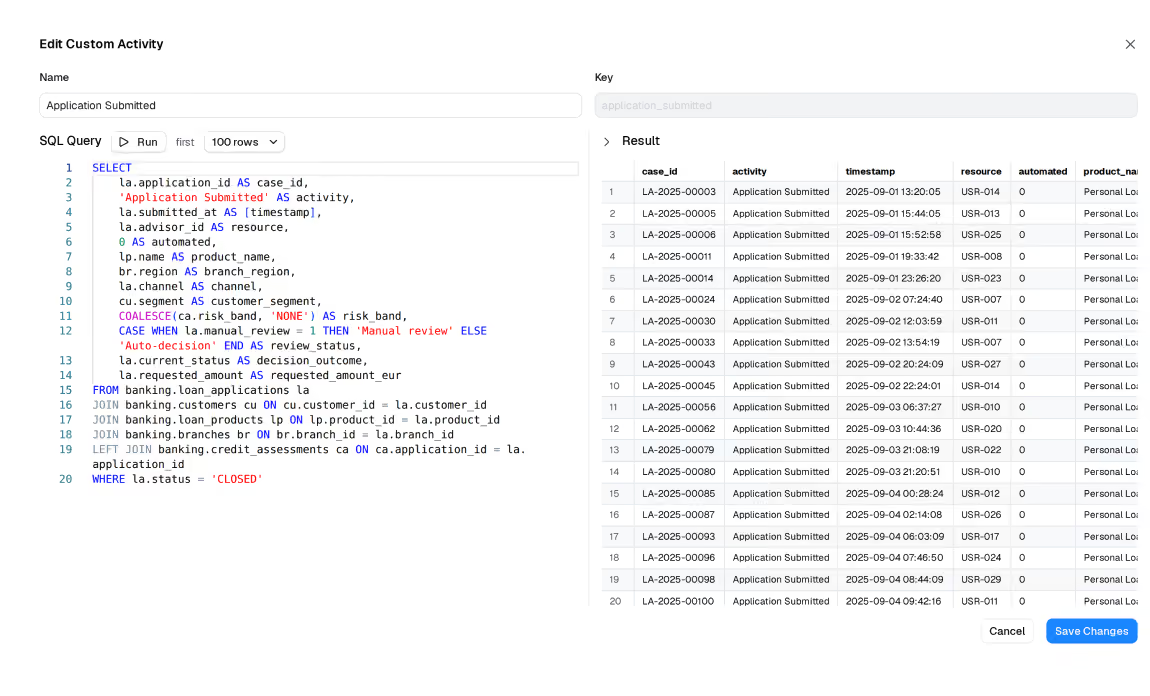
Nichts ist verriegelt:Aktivitäten ein- oder ausschalten, das SQL dahinter bearbeiten, eigene ergänzen. Nicht im Katalog? Bauen Sie es von Grund auf.
Einmal geschrieben, überall lauffähig:Ein Template läuft auf jeder unterstützten Datenbank. Das Tool übersetzt das SQL in den jeweiligen Dialekt.
Vorlagenkatalog im Data Preparation Tool mit fertigen Prozessen für SAP Purchase-to-Pay und Dynamics 365
Angereichertes Ereignisprotokoll aus dem Data Preparation Tool mit Fall, Aktivität und Zeitstempel sowie Durchlaufzeit, Variante und Kosten
Was Sie bekommen

Ein Event Log, das analysebereit ist

Ein typisches Event Log hat drei Spalten: Fall, Aktivität, Zeitstempel. Genau dort fängt unseres an.
Angereichert statt nackt:Jeder Fall kommt mit Durchlaufzeit, Variante, Schleifen, Kosten und Automatisierungsgrad. Jeder Schritt trägt seine Dauer, Wartezeit und sein Rework-Kennzeichen. Fallattribute wie Lieferant, Werk oder Zahlungsbedingungen wandern mit, und Variantenfilter sind vorberechnet.
Zwei Detailstufen, zwei Sprachen:Wechseln Sie zwischen der Detailsicht („Wareneingang erfassen") und der Managementsicht („Waren- & Rechnungseingang").
Eine Struktur für jeden Prozess:Purchase-to-Pay, Order-to-Cash oder ein eigener Prozess, aus SAP, Dynamics oder einer beliebigen Datenbank: Die Ausgabetabellen haben jedes Mal dasselbe Layout. Reports und Dashboards funktionieren über alle hinweg, ohne Nacharbeit je Projekt.
Automatisierte Qualitätssicherung

Nichts Halbfertiges erreicht jemals Ihre Reports

Schmutzige Daten melden sich nicht an, sie verzerren einfach das Dashboard. Das Data Preparation Tool ist der Türsteher vor Ihrer Analyse.
Vollständig oder gar nicht:Ein neues Event Log geht in einem einzigen Schritt live, und nur wenn es vollständig ist. Ihre Analyse liest nie ein halb geschriebenes Log, und ein fehlgeschlagener Lauf lässt die vorherige Version unangetastet. Veraltete Tabellen werden automatisch entfernt.
Robust gebaut:Scheitert eine Aktivität, bekommen Sie eine Warnung und trotzdem alles Übrige, statt den ganzen Lauf zu verlieren.
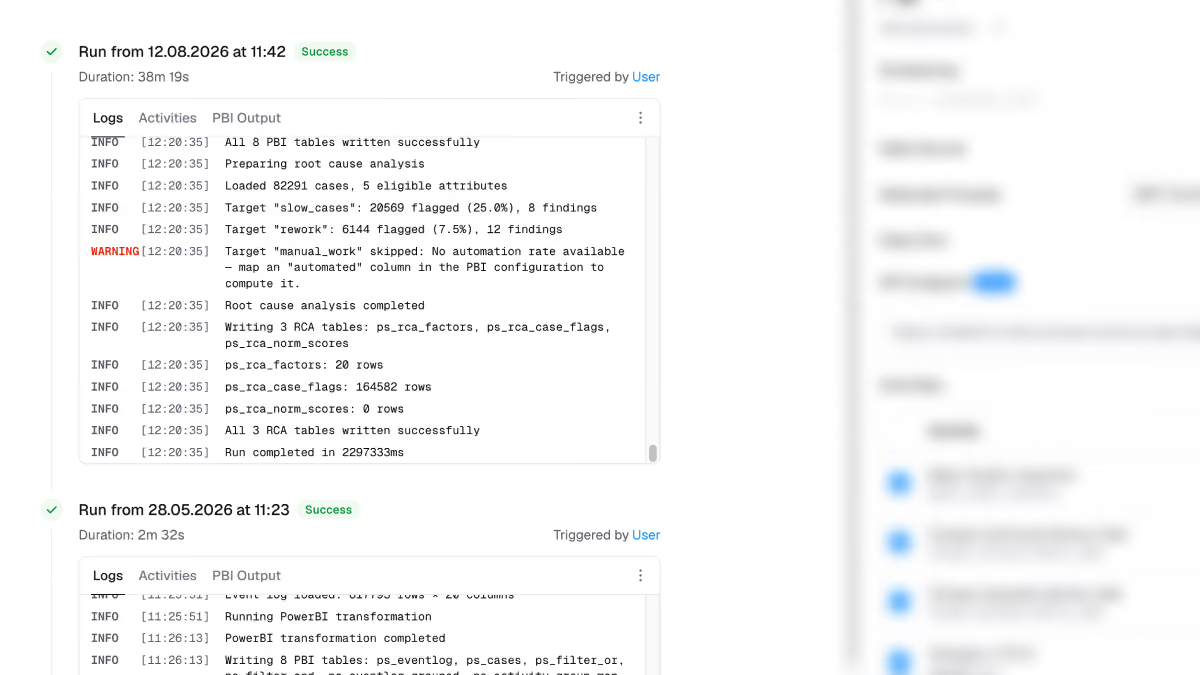
Jeder Lauf ist nachvollziehbar:Vollständige Lauf-Historie und Logs, mit Event-Anzahl und Dauer je Aktivität. So sehen Sie, was ein Lauf erzeugt hat und was sich seit dem letzten verändert hat.
Qualitätsprüfung im Data Preparation Tool, die ein Ereignisprotokoll vor der Freigabe validiert
Ausführungshistorie im Data Preparation Tool mit Ereignisanzahl und Dauer je Aktivität
In jedem Lauf enthalten

Jedes Event Log kommt mit einem ersten Befund

Während das Tool Ihre Daten aufbereitet, sieht es bereits, welche Fälle sich anders verhalten. Es markiert sie und benennt die Faktoren, die sie gemeinsam haben.
Problemfälle, automatisch markiert:Langsame Fälle, Rework-Schleifen, niedrige Automatisierungsgrade und Verstöße gegen Ihre Prozessnormen, über fünf Regeltypen hinweg.
Einflussfaktoren statt Vermutungen:Jedes Fallattribut wird geprüft und in eine Rangfolge gebracht, mit Effektstärke, Fallzahlen und Signifikanz hinter jedem einzelnen.
Wohin es führt:Die Befunde landen neben Ihren Power BI Tabellen und in Process.Science Intelligence. Dort verfolgen Sie sie im Prozessgraf, vergleichen Populationen und behalten als Insight, was standhält, samt seiner Evidenz.
Was als Nächstes kommt

Beschreiben Sie Ihren Prozess, und das Tool findet ihn

Wir bringen die Mustererkennung hinter unserem IoT Miner in die Datenaufbereitung. Sie beschreiben in einem Satz, worum es in Ihren Daten geht, etwa „Einkauf, von der Bestellanforderung bis zur Rechnungszahlung", und das Tool schlägt Prozesskandidaten mit echten Aktivitäten aus Ihren eigenen Tabellen vor.
An Ihren Daten geprüft, nicht geraten:Existieren die Spalten, gibt es genug Zeilen, sind die Zeitstempel plausibel, passen die Fall-IDs zusammen?
Es fragt nur dort, wo es unsicher ist:Jede Aktivität trägt einen Konfidenzwert aus mehreren Signalen, und Sie schärfen das Ergebnis im Gespräch nach, bevor daraus eine lauffähige Pipeline wird.
Es lernt von Ihren Experten:Was Ihr Team bestätigt, wird behalten. Die nächste Erkennung auf demselben System startet damit von einer besseren Position.
Automatische Prozesserkennung im Data Preparation Tool, die Aktivitäten aus den eigenen Datenbanktabellen vorschlägt
Verbindungen

Aus Ihren Systemen lesen,
dorthin schreiben, wo Sie arbeiten

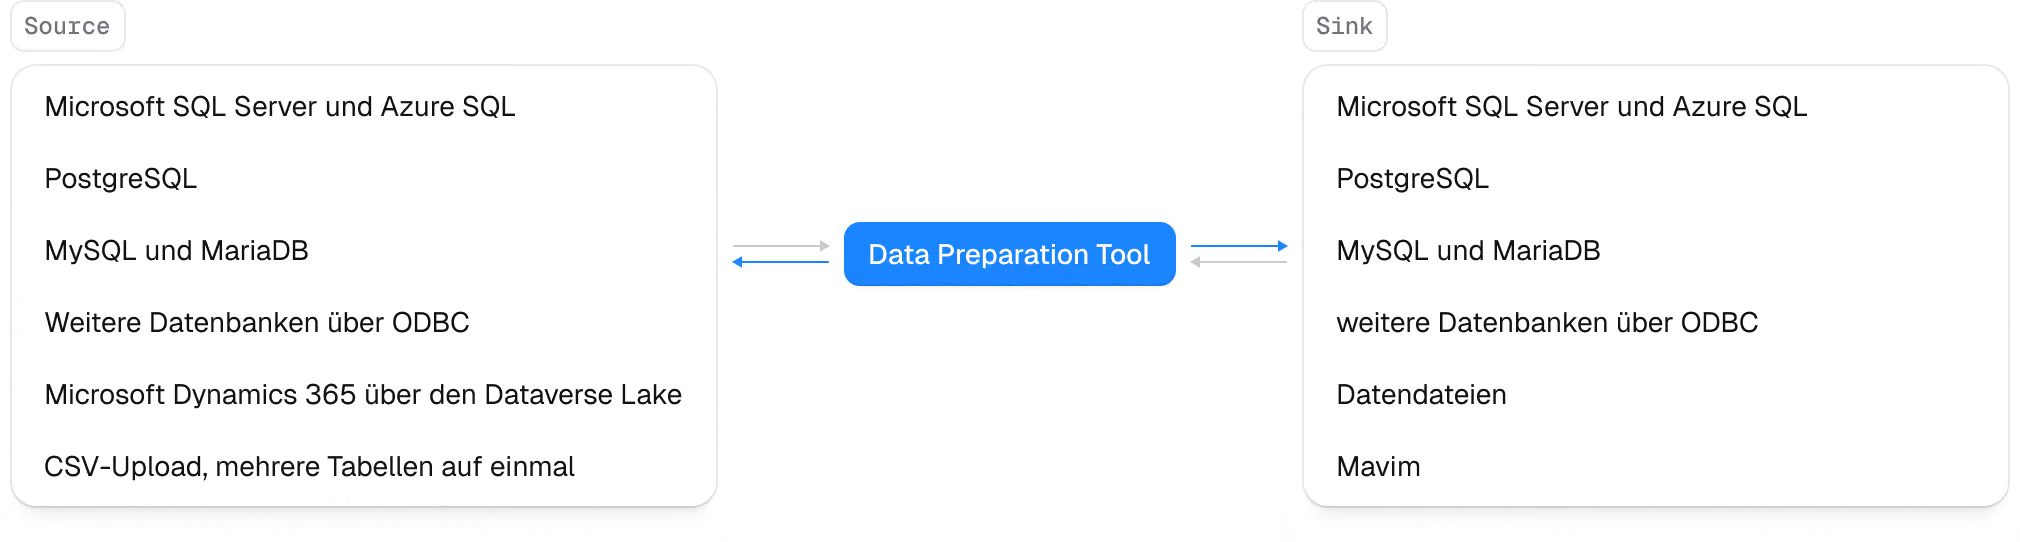
Eine Source ist, woraus das Tool liest, eine Sink, wohin es schreibt. Jede Datenbankverbindung funktioniert in beide Richtungen.
Diagramm der Quell- und Zielverbindungen des Data Preparation Tool zu Datenbanken, Dynamics 365, Power BI und Process.Science Intelligence
Ihr System fehlt?
Das perfekte Setup

Gebaut für IhrPower BIundIntelligence

Das Data Preparation Tool ist der Maschinenraum Ihres Process Mining. Die Event Logs, die es erzeugt, fließen in das System, in dem Sie arbeiten, ohne einen zusätzlichen Modellierungsschritt dazwischen.

Power BI integration

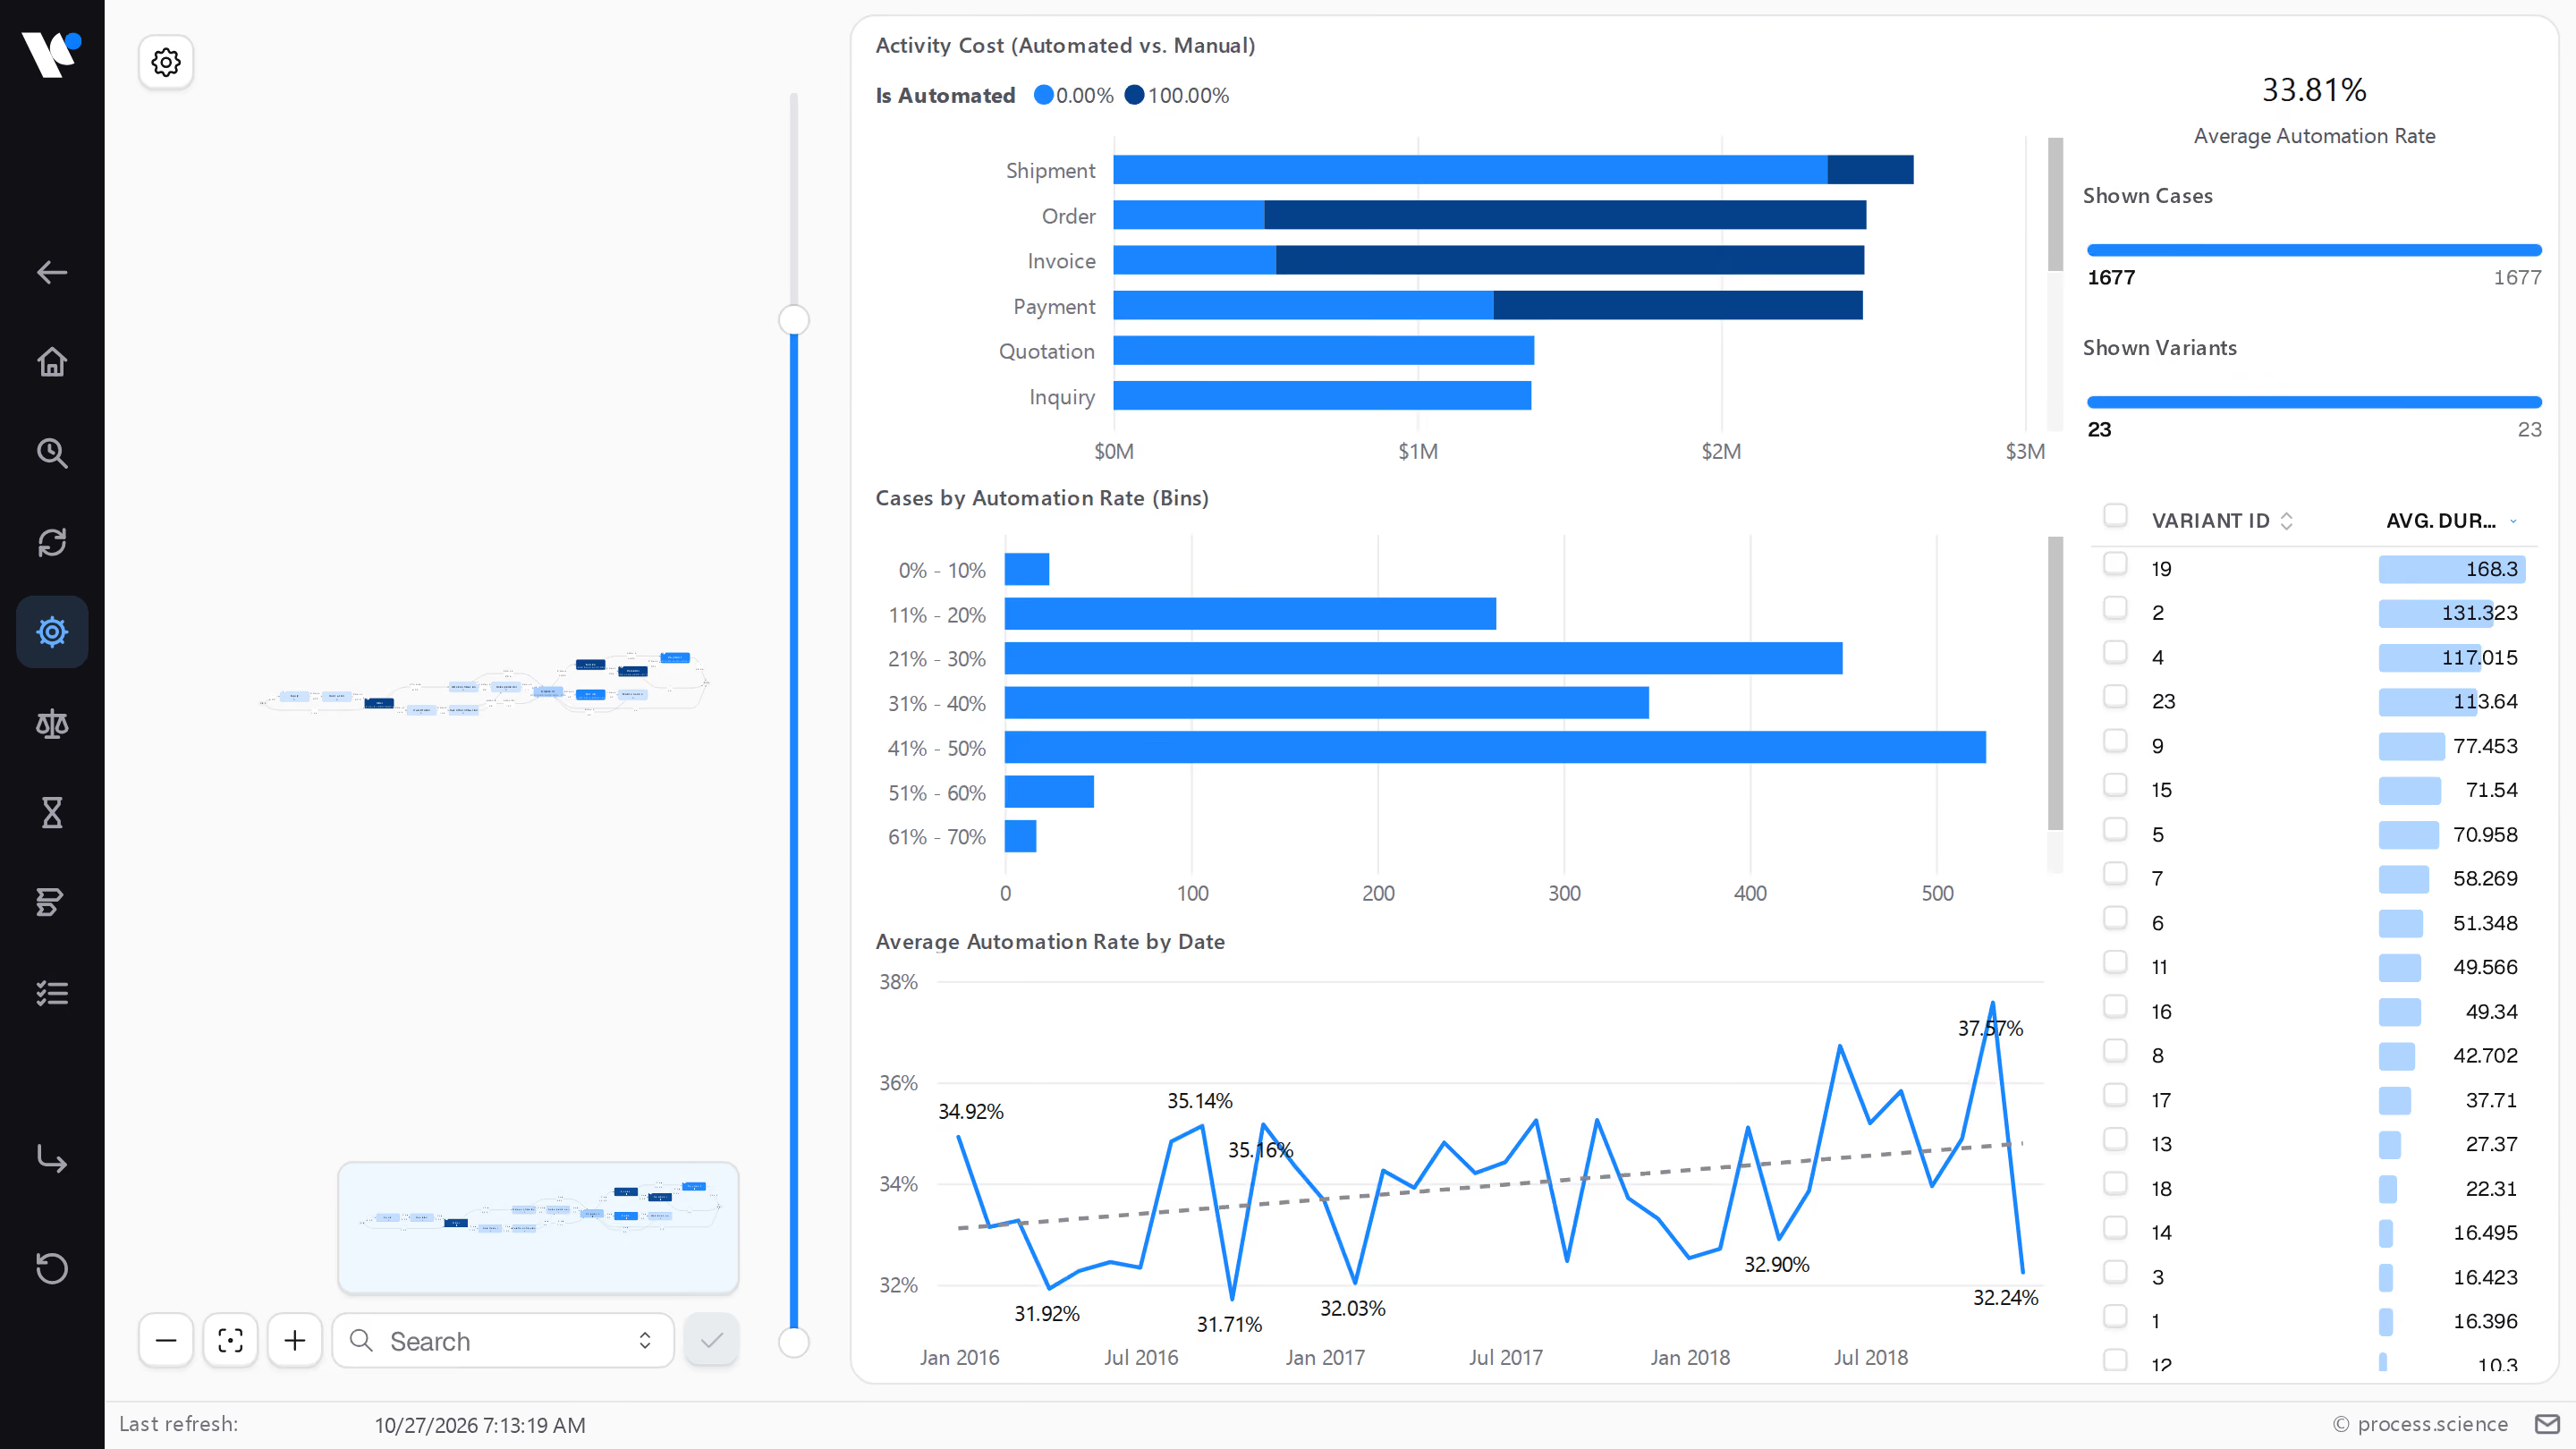
Die Ausgabetabellen haben das Layout, das unsere Power BI Report-Templates erwarten. Ihr Event Log landet in Ihrem Modell, neben Ihren Dimensionen, und die Dashboards funktionieren ohne Nacharbeit.
Dashboard mit einem Kostenvergleich zwischen automatisierten und manuellen Prozessen für Versand, Bestellung, Rechnung, Zahlung und Anfrage, wobei die Balken Kosten von bis zu 3 Millionen Dollar anzeigen. Ein Balkendiagramm stellt die Fälle nach Automatisierungsgrad in Intervallen von 0 % bis 70 % mit einer Anzahl von bis zu 500 dar. Ein Liniendiagramm zeigt den durchschnittlichen Automatisierungsgrad nach Datum von Januar 2016 bis Juli 2018, wobei die Raten zwischen etwa 32 % und 38 % schwanken. Der durchschnittliche Automatisierungsgrad liegt bei 33,81 %. Eine vertikale Liste auf der rechten Seite zeigt Varianten-IDs mit den entsprechenden durchschnittlichen Bearbeitungszeiten in Sekunden, die von etwa 10 bis 168 Sekunden reichen. Die Gesamtzahl der angezeigten Fälle beträgt 1677 bei 23 Varianten.

Process.Science Intelligence

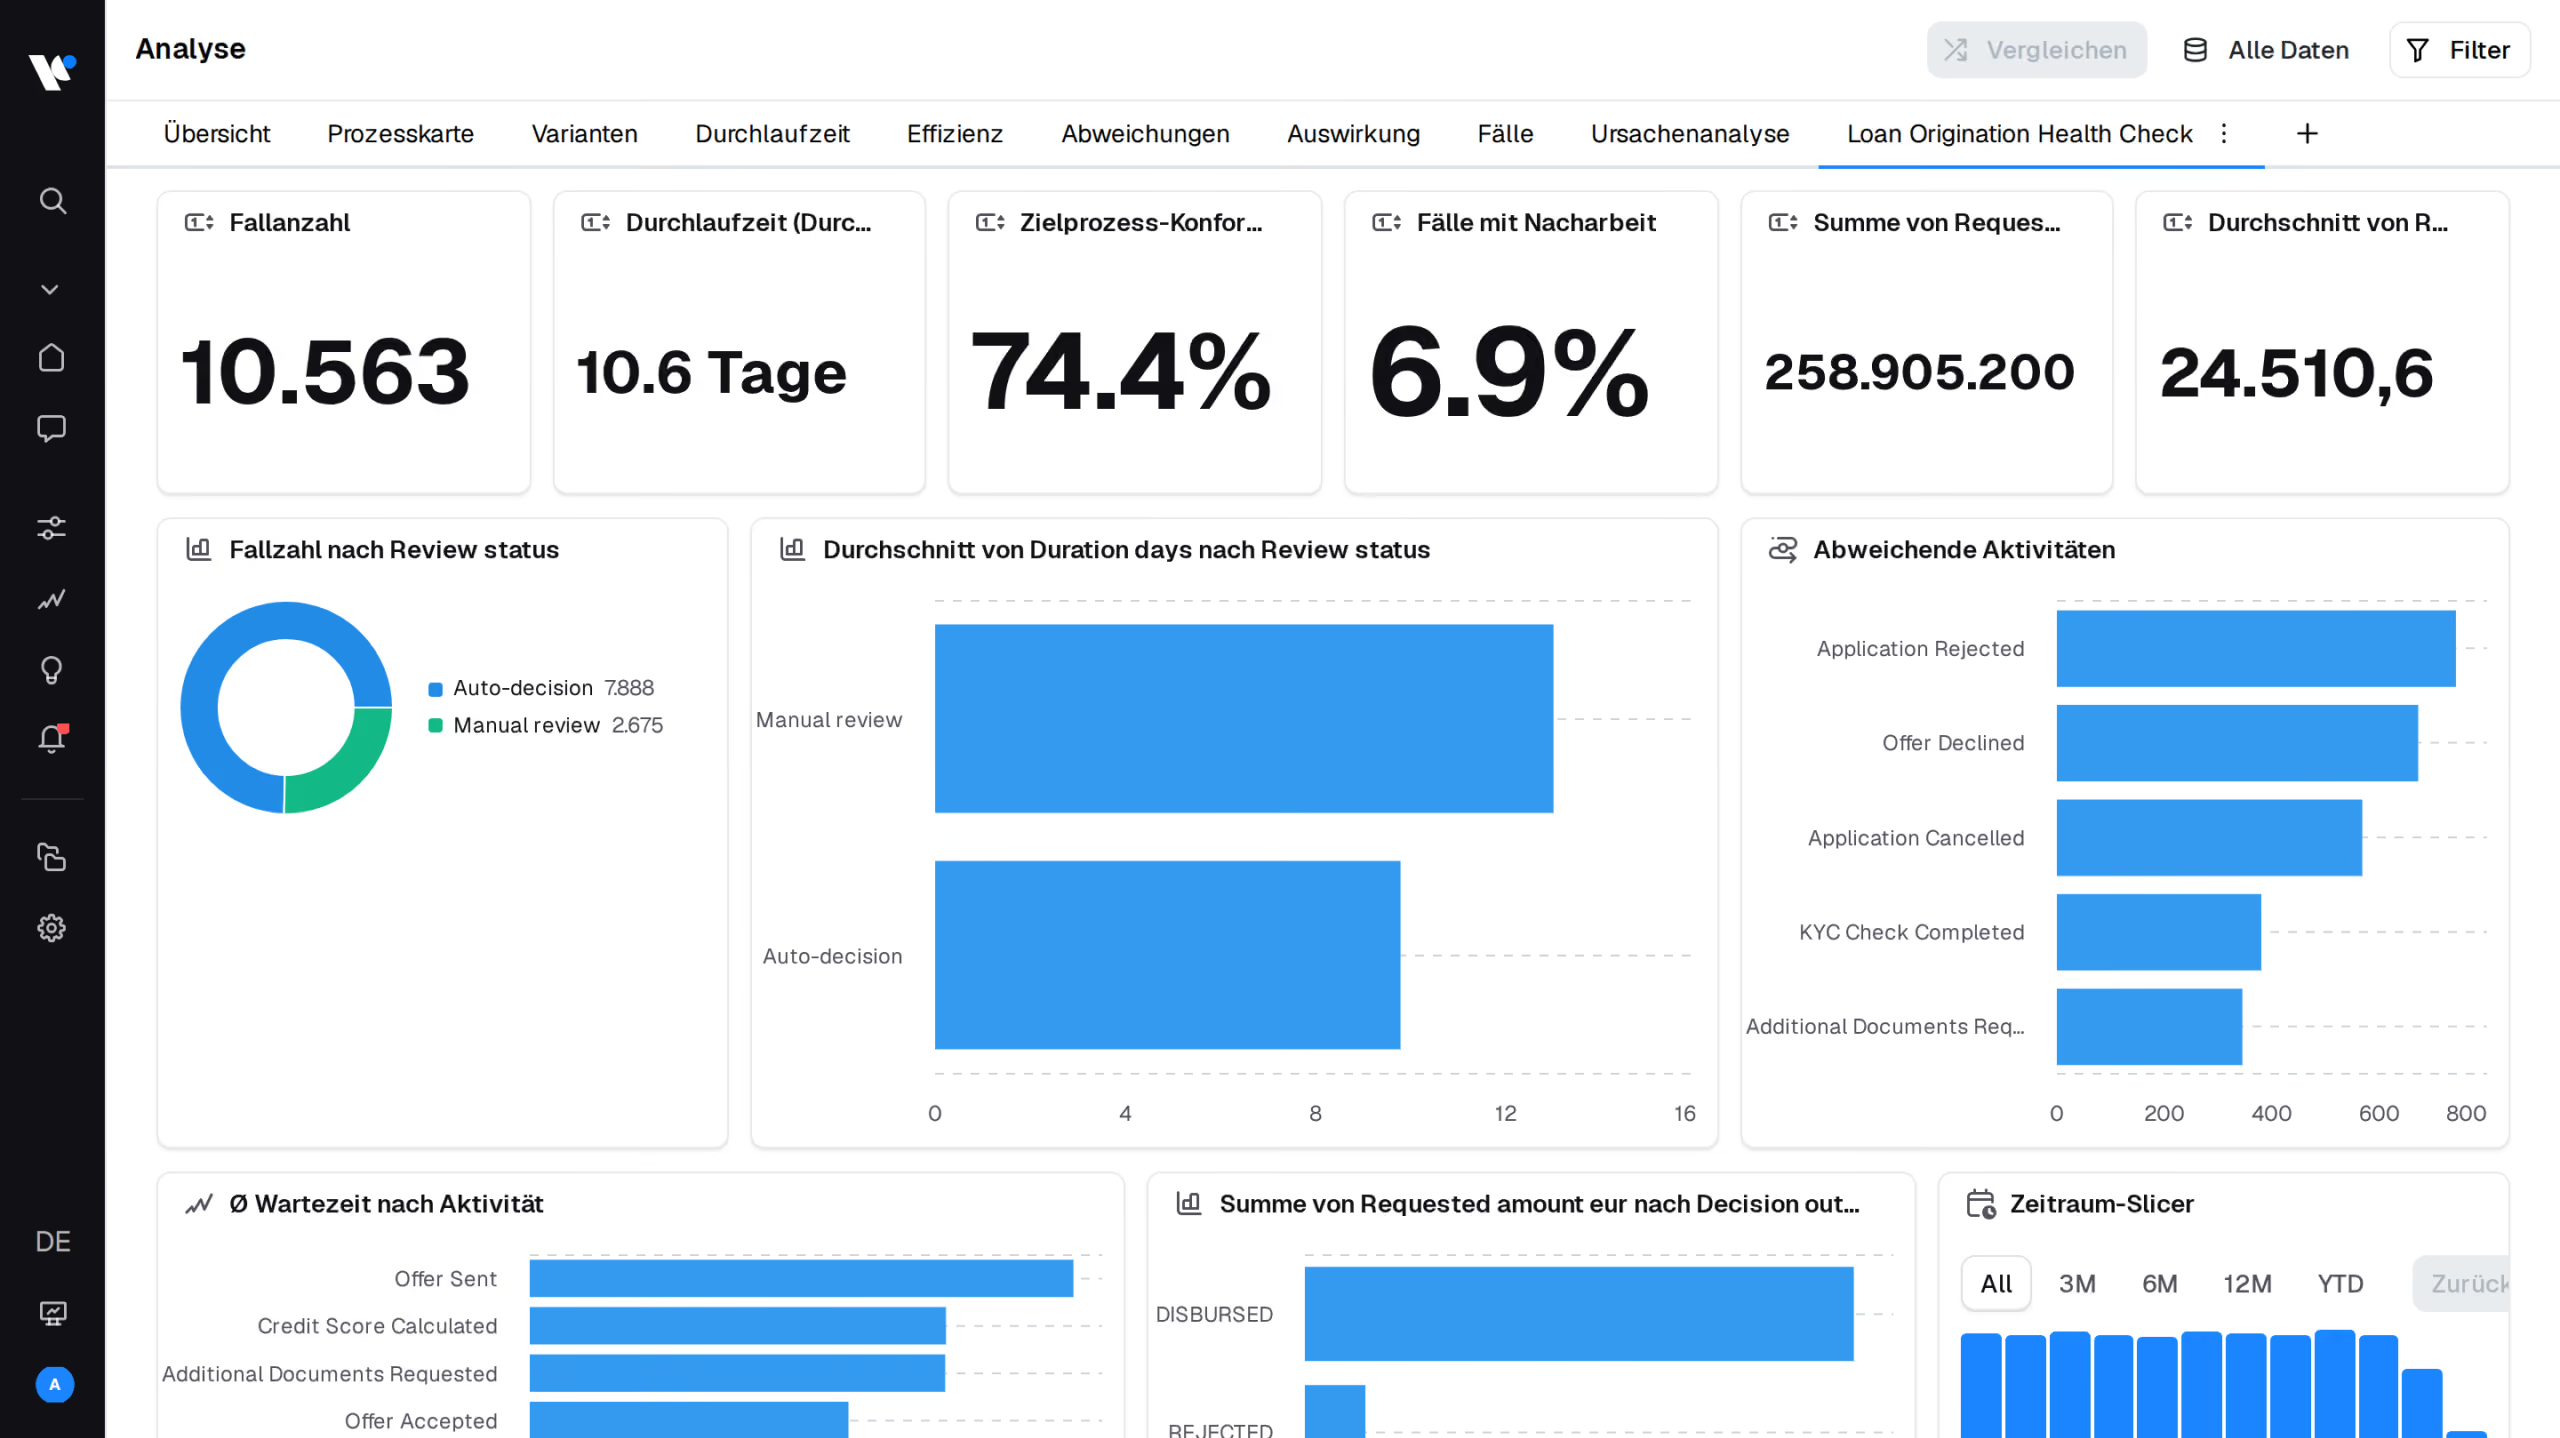
Ein abgeschlossener Lauf wird zu dem Data Set, auf dem Ihre Intelligence-Projekte arbeiten, und aktualisiert die Analyse automatisch. Darauf setzen Setup, Analysis, Insights, Chat und Alerts auf.
Loslegen

Sehen Sie Ihr eigenes Event Log, keine Demo

Verbinden Sie ein System, wählen Sie einen Prozess, und sehen Sie, was herauskommt. Wir machen das gemeinsam auf Ihren Daten, damit am Ende Ihr Prozess steht und kein Beispieldatensatz.
Läuft auf Ihren eigenen Systemen und Datenbanken
Fertige Templates für Ihre Kernprozesse
Kein handgeschriebenes ETL nötig
Mit dem Absenden der Anfrage stimmen Sie der Datenschutzerklärung von process.science zu.
Vielen Dank! Ihre Nachricht wurde erfolgreich übermittelt!
Sie erhalten eine E-Mail mit einem Bestätigungslink.
Hoppla! Beim Absenden des Formulars ist ein Fehler aufgetreten.
Noch Fragen?

FAQ:Technologie & Architektur

Die Antworten, nach denen IT-Administratoren und Data Engineers zuerst suchen
Welche Quellsysteme werden unterstützt?

Microsoft SQL Server und Azure SQL, PostgreSQL, MySQL und MariaDB direkt, weitere Datenbanken über ODBC, Microsoft Dynamics 365 über den Dataverse-Lake-Export und CSV-Upload für mehrere Tabellen auf einmal. SAP wird über seine Datenbank gelesen, weshalb die SAP-Templates unabhängig von Ihrem SAP-Release funktionieren. Die Ergebnisse lassen sich in jede dieser Datenbanken zurückschreiben, als Datendateien übergeben oder an Mavim senden.

Muss die Datenaufbereitung in der Cloud stattfinden?

Nein. Das Tool liest aus Ihren eigenen Datenbanken und schreibt in sie zurück, die Daten bleiben also in der Umgebung, die Sie betreiben. Passwörter und Zugangstoken werden verschlüsselt gespeichert, Zugriffe sind über Workspaces organisiert, und bei wachsenden Datenmengen verteilen sich die Läufe über mehrere Worker.

Ersetzt das Tool Power Query?

Es ist kein allgemeines ETL-Werkzeug und will auch keines sein. Power Query und ähnliche Werkzeuge bewegen und formen Daten, ohne zu wissen, was ein Prozess ist. Das Data Preparation Tool ist für eine Aufgabe gebaut: aus operativen Tabellen ein Event Log zu machen, mit Aktivitäten, Fällen, Varianten und Stammdaten bereits darin. Für alles andere nutzen Sie Power Query weiter.

Wie lange dauert das erste Event Log?

Sobald die Verbindung steht und Sie ein Template gewählt haben, ist der erste Lauf eine Sache von Minuten statt Wochen, weil die Zuordnungsarbeit bereits erledigt ist. Zeit braucht die Abstimmung, welche Aktivitäten zu Ihrem Prozess gehören, und das ist ein Gespräch mit Ihren eigenen Leuten, keine Data-Engineering-Aufgabe.

Was passiert, wenn sich unser Quellsystem ändert?

Ein Template ist eine Folge von SQL-Schritten, die Sie lesen und bearbeiten können. Wandert ein Feld oder wird eine Tabelle umbenannt, passen Sie diesen einen Schritt an, statt eine Pipeline neu zu bauen. Jeder Lauf wird mit Event-Anzahl und Dauer je Aktivität protokolliert, eine Änderung in der Quelle zeigt sich also als Änderung in den Zahlen.

Können wir einen Prozess bauen, der nicht im Katalog ist?

Ja. Sie können von einem Template ausgehen und eigene Aktivitäten und Aufbereitungsschritte ergänzen, oder einen eigenen Prozess von Grund auf bauen. In beiden Fällen hat die Ausgabe dieselbe Struktur wie jedes andere Event Log, Ihre Reports funktionieren also weiter.