Komplettlösung für Microsoft Power BI

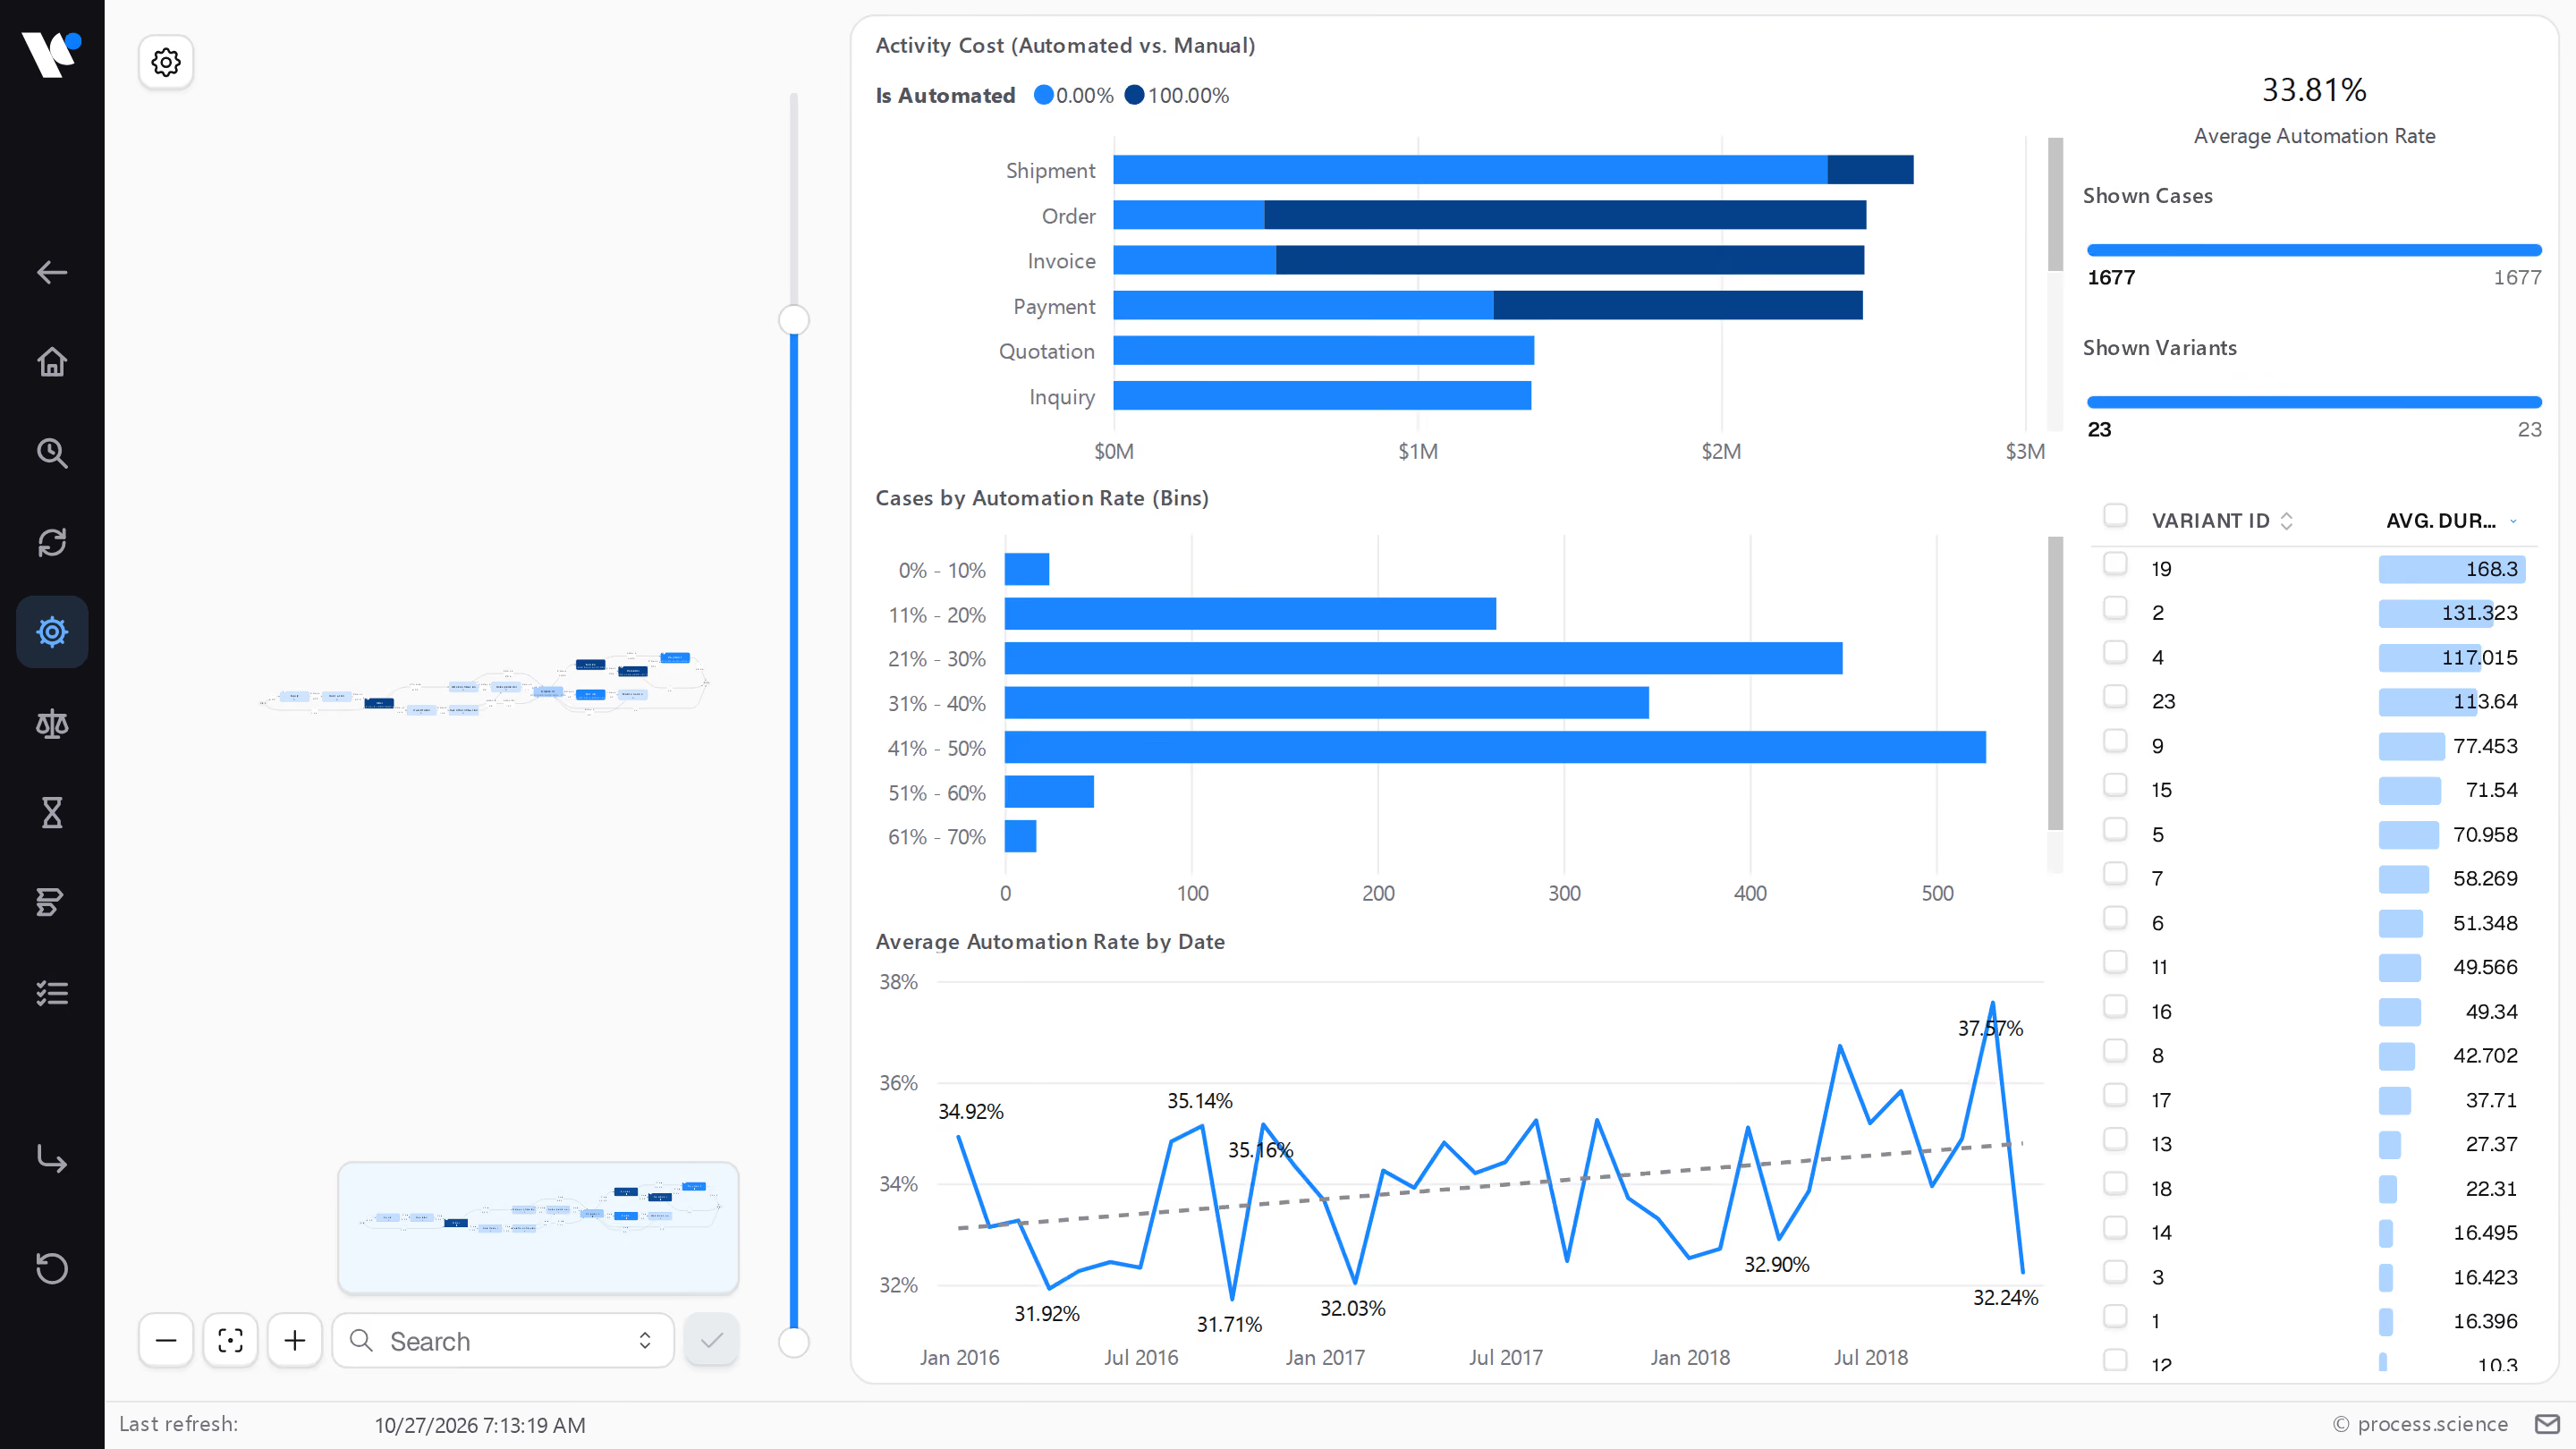
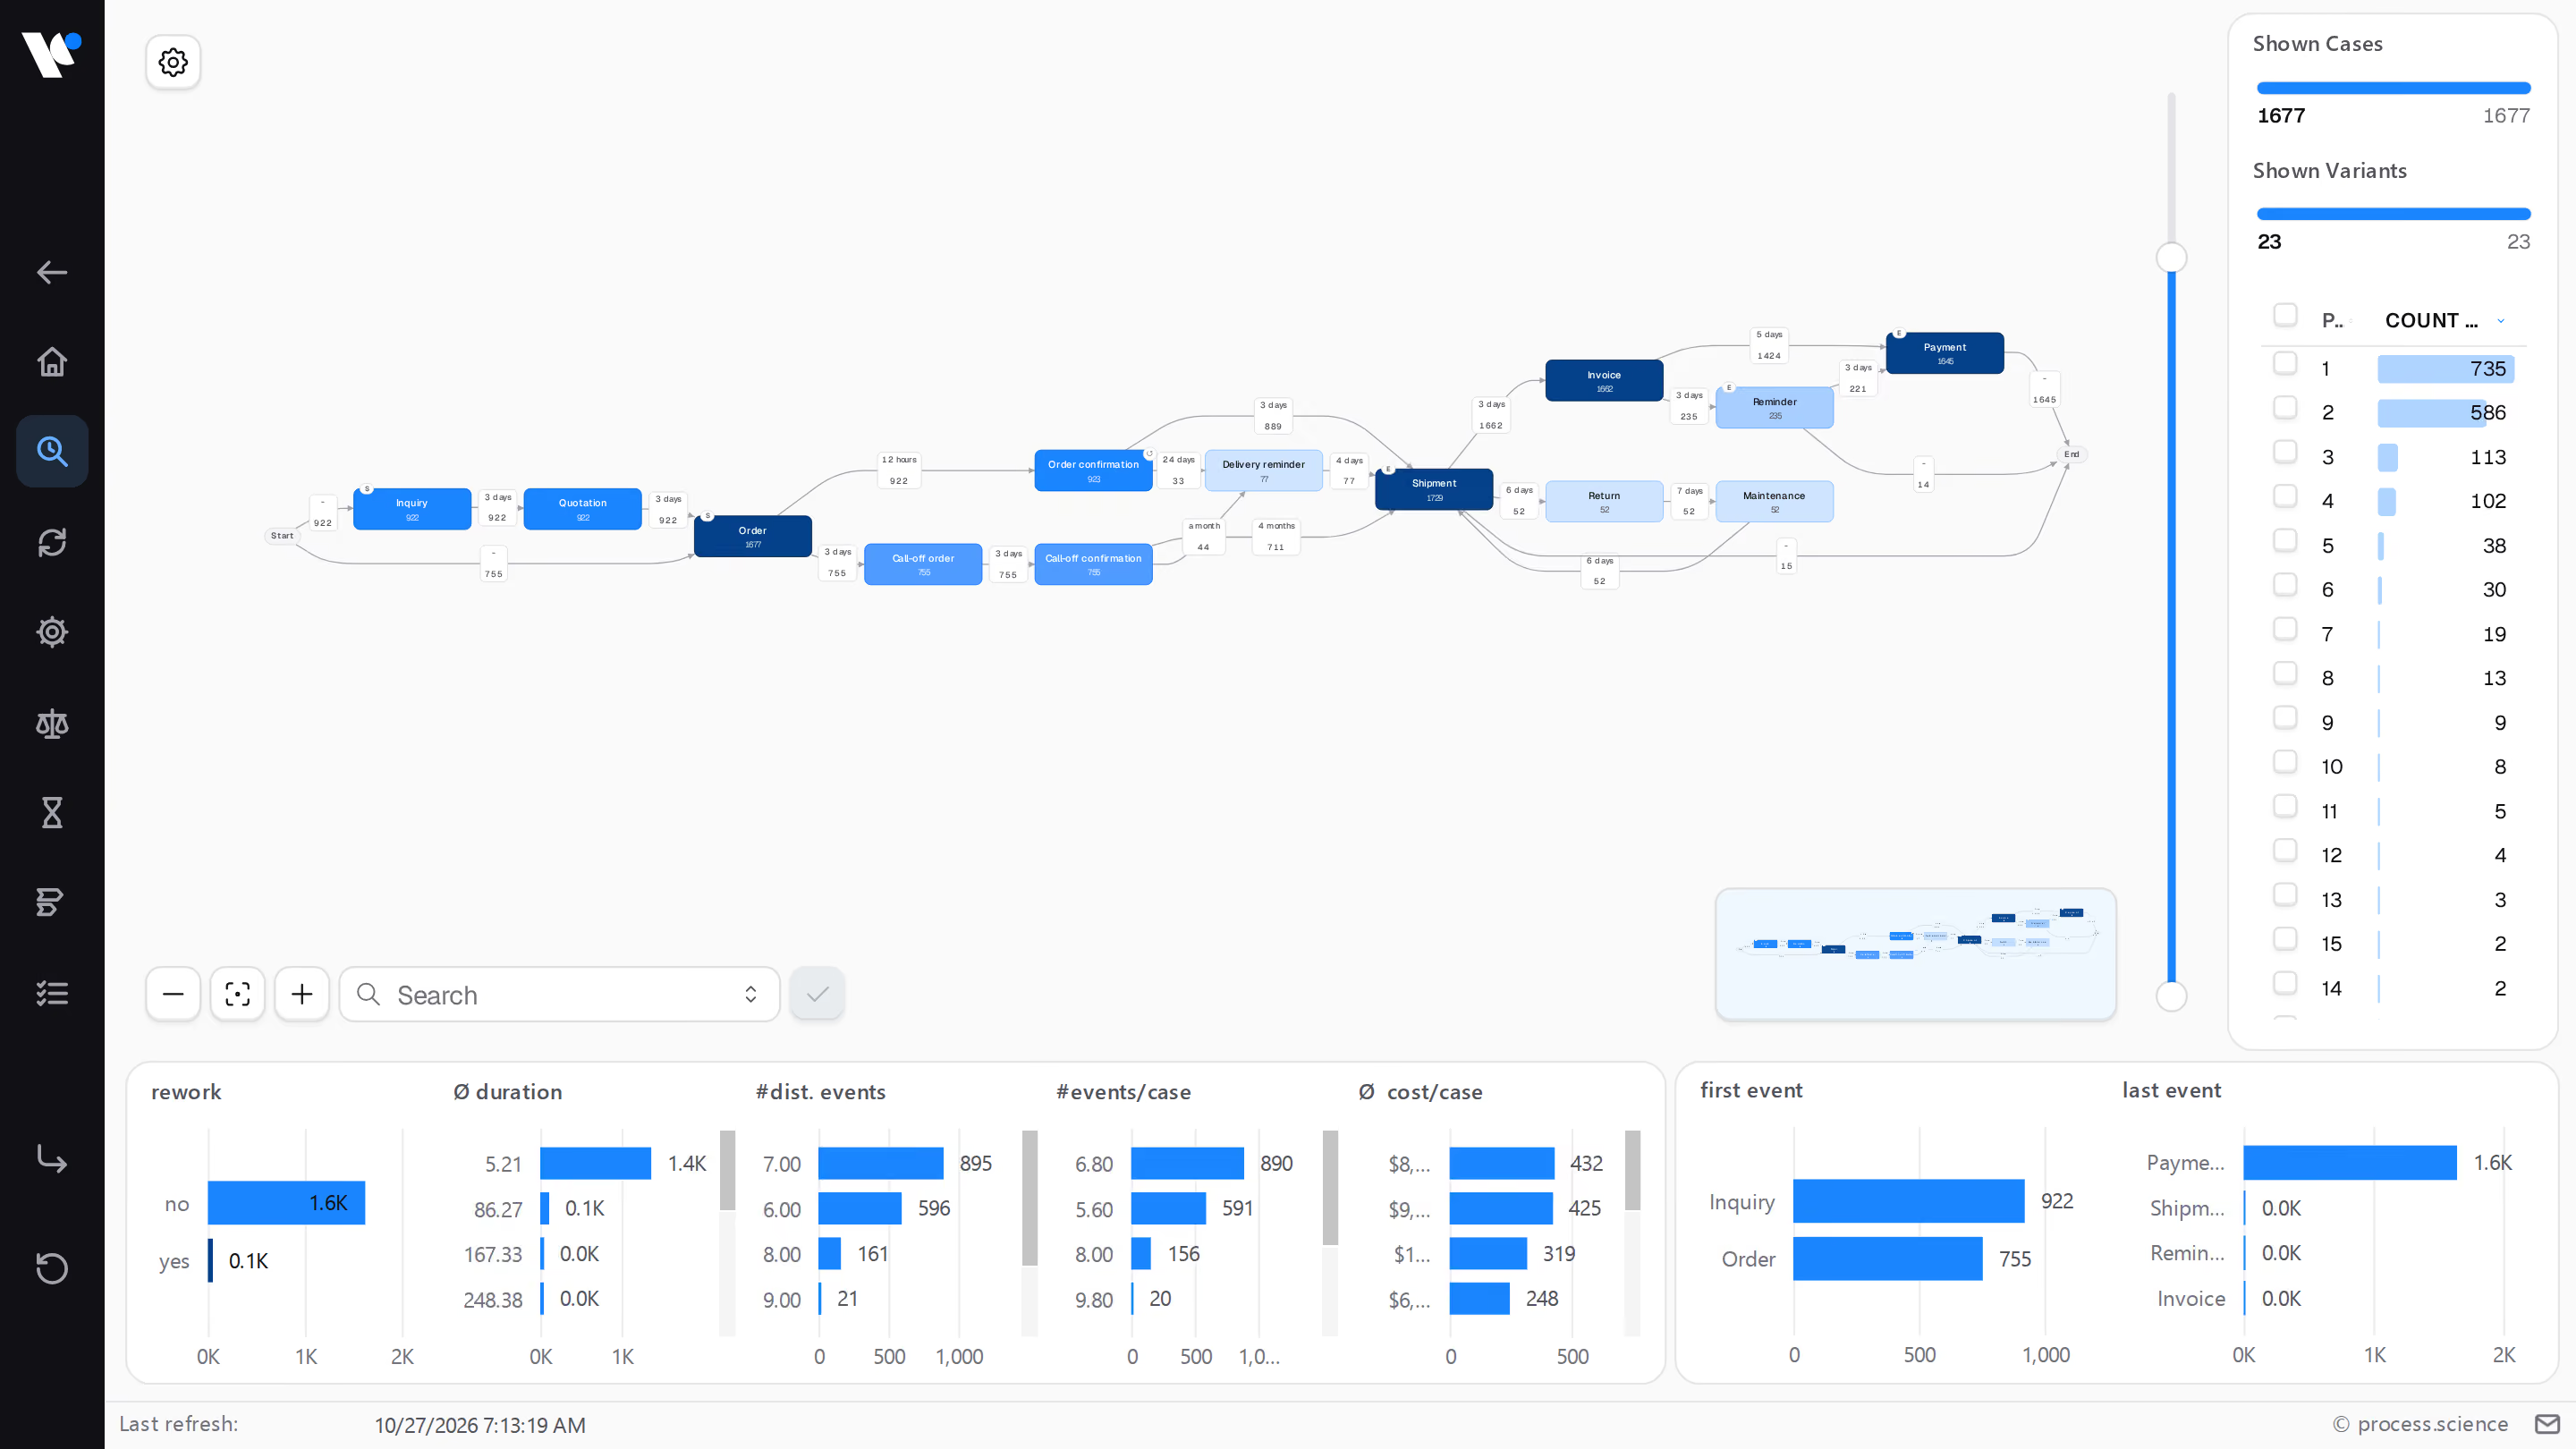
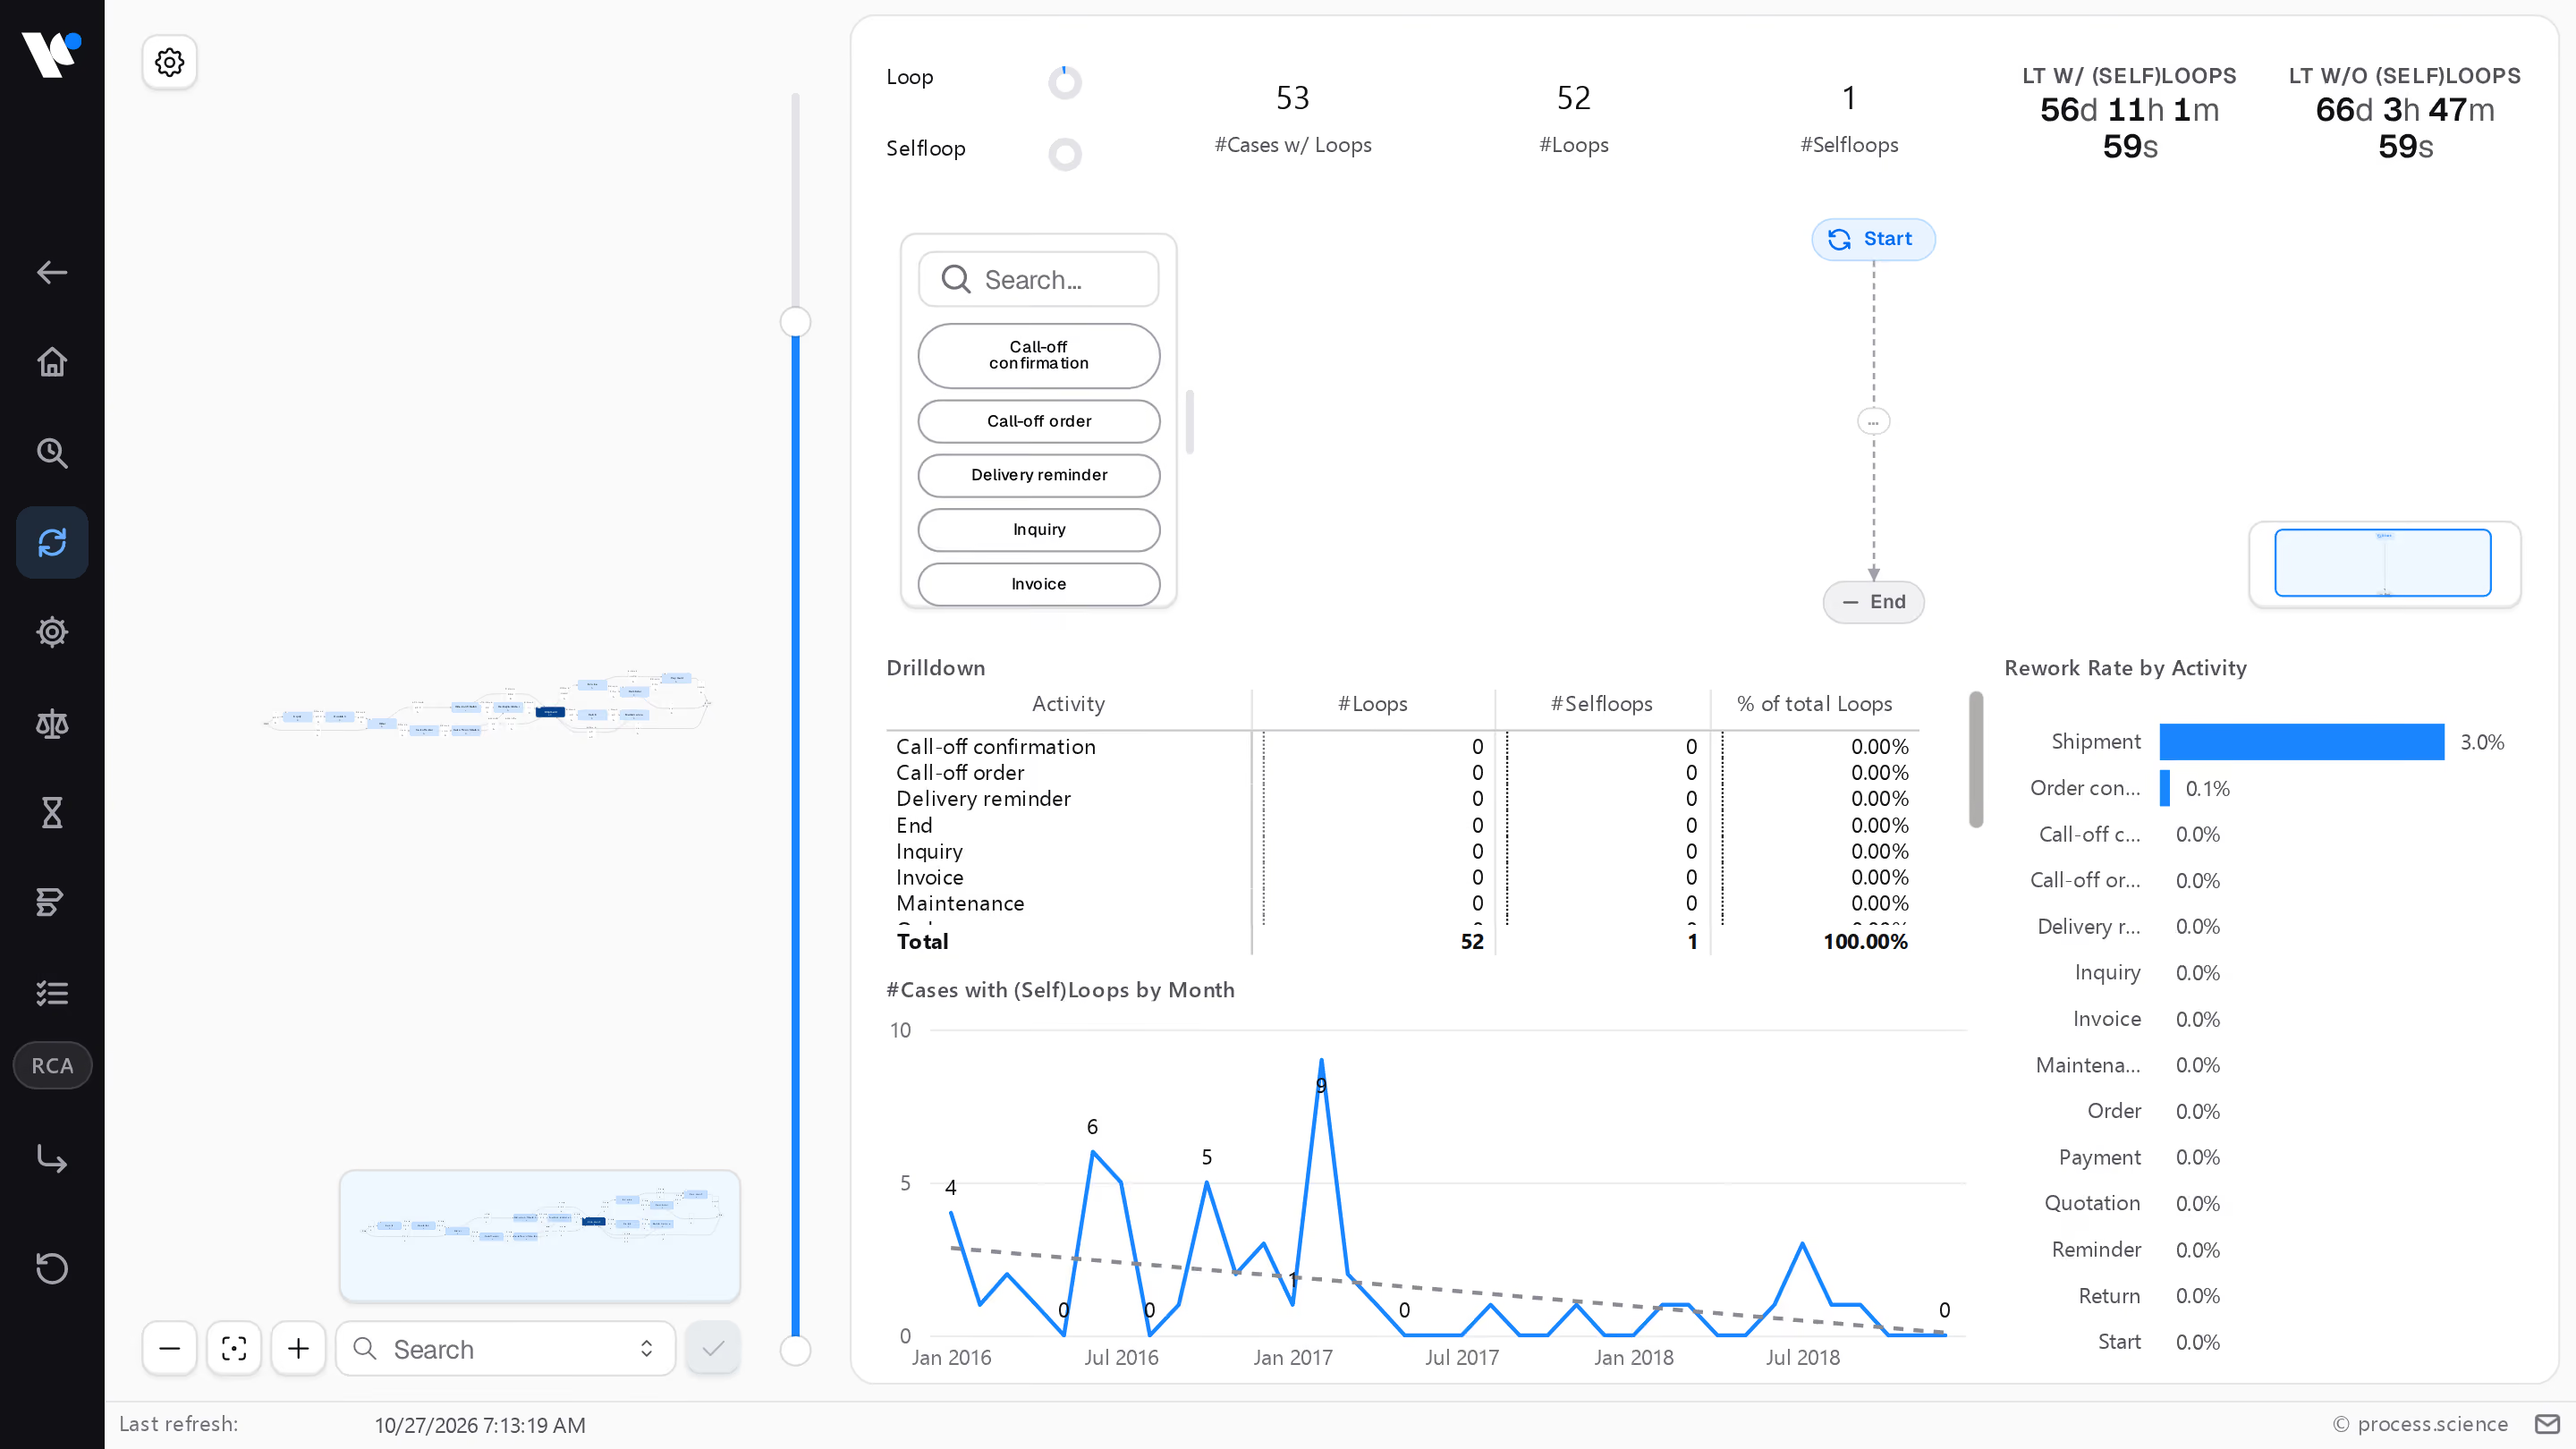
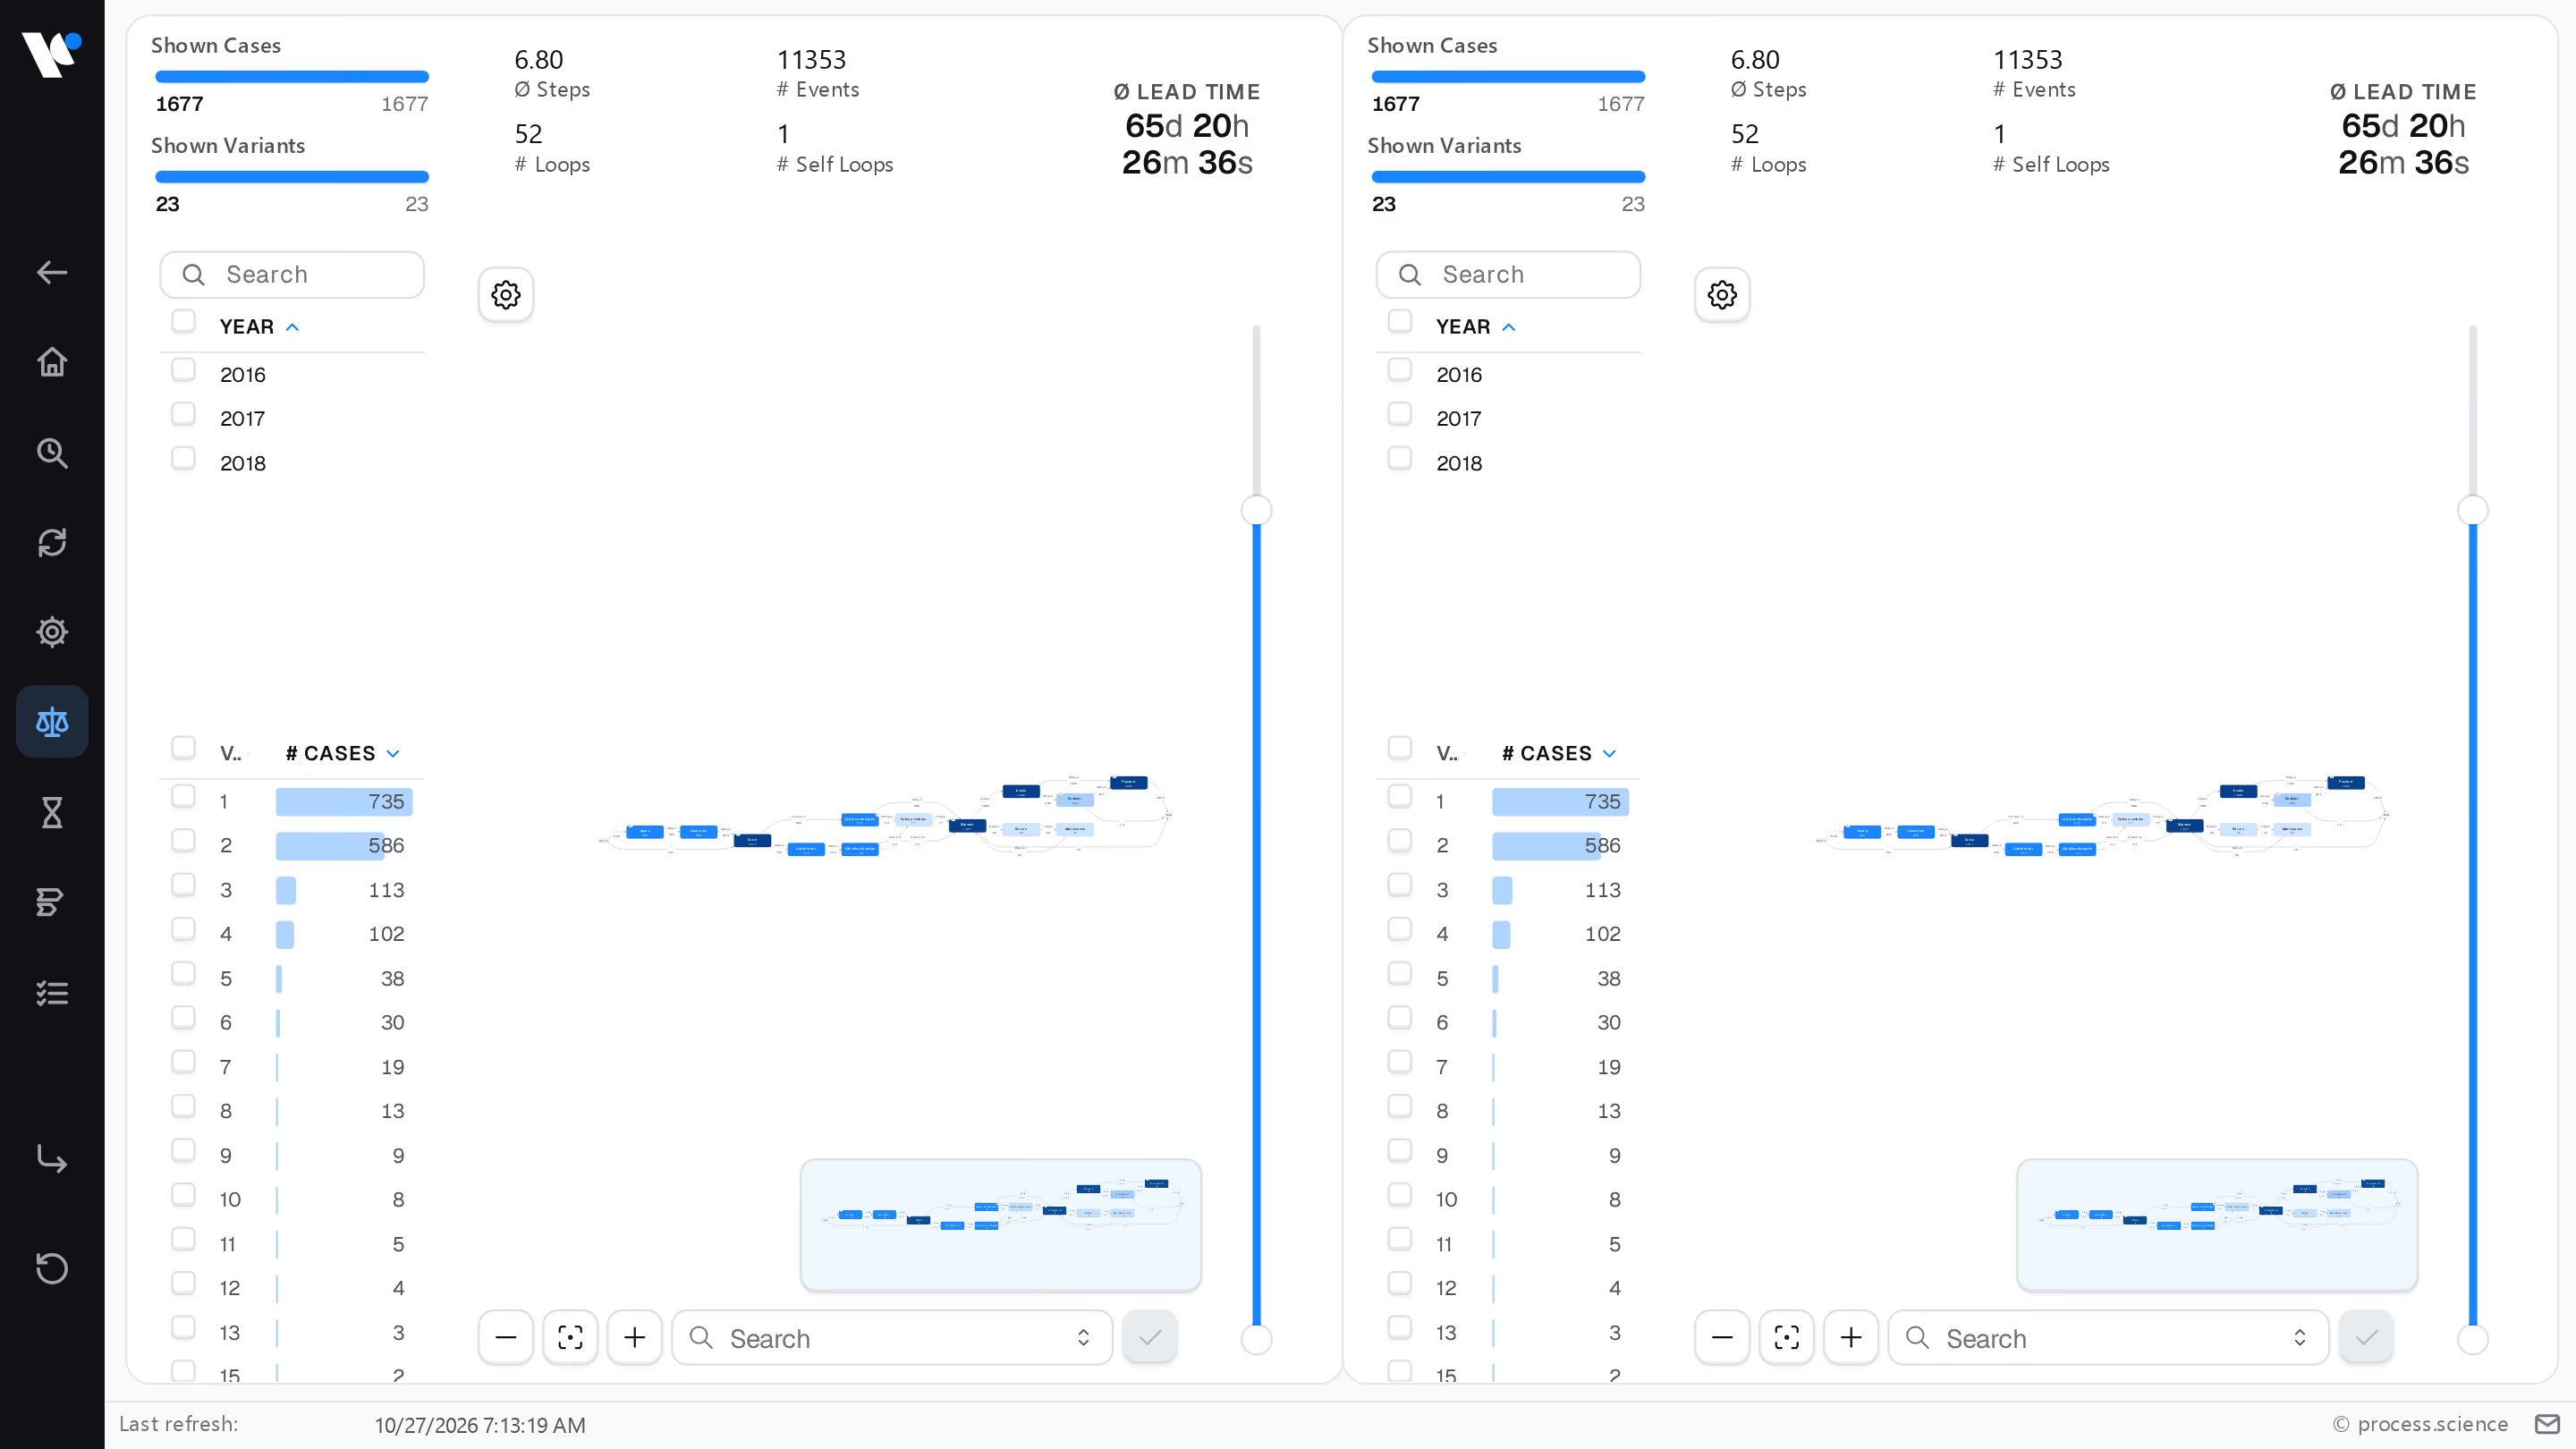
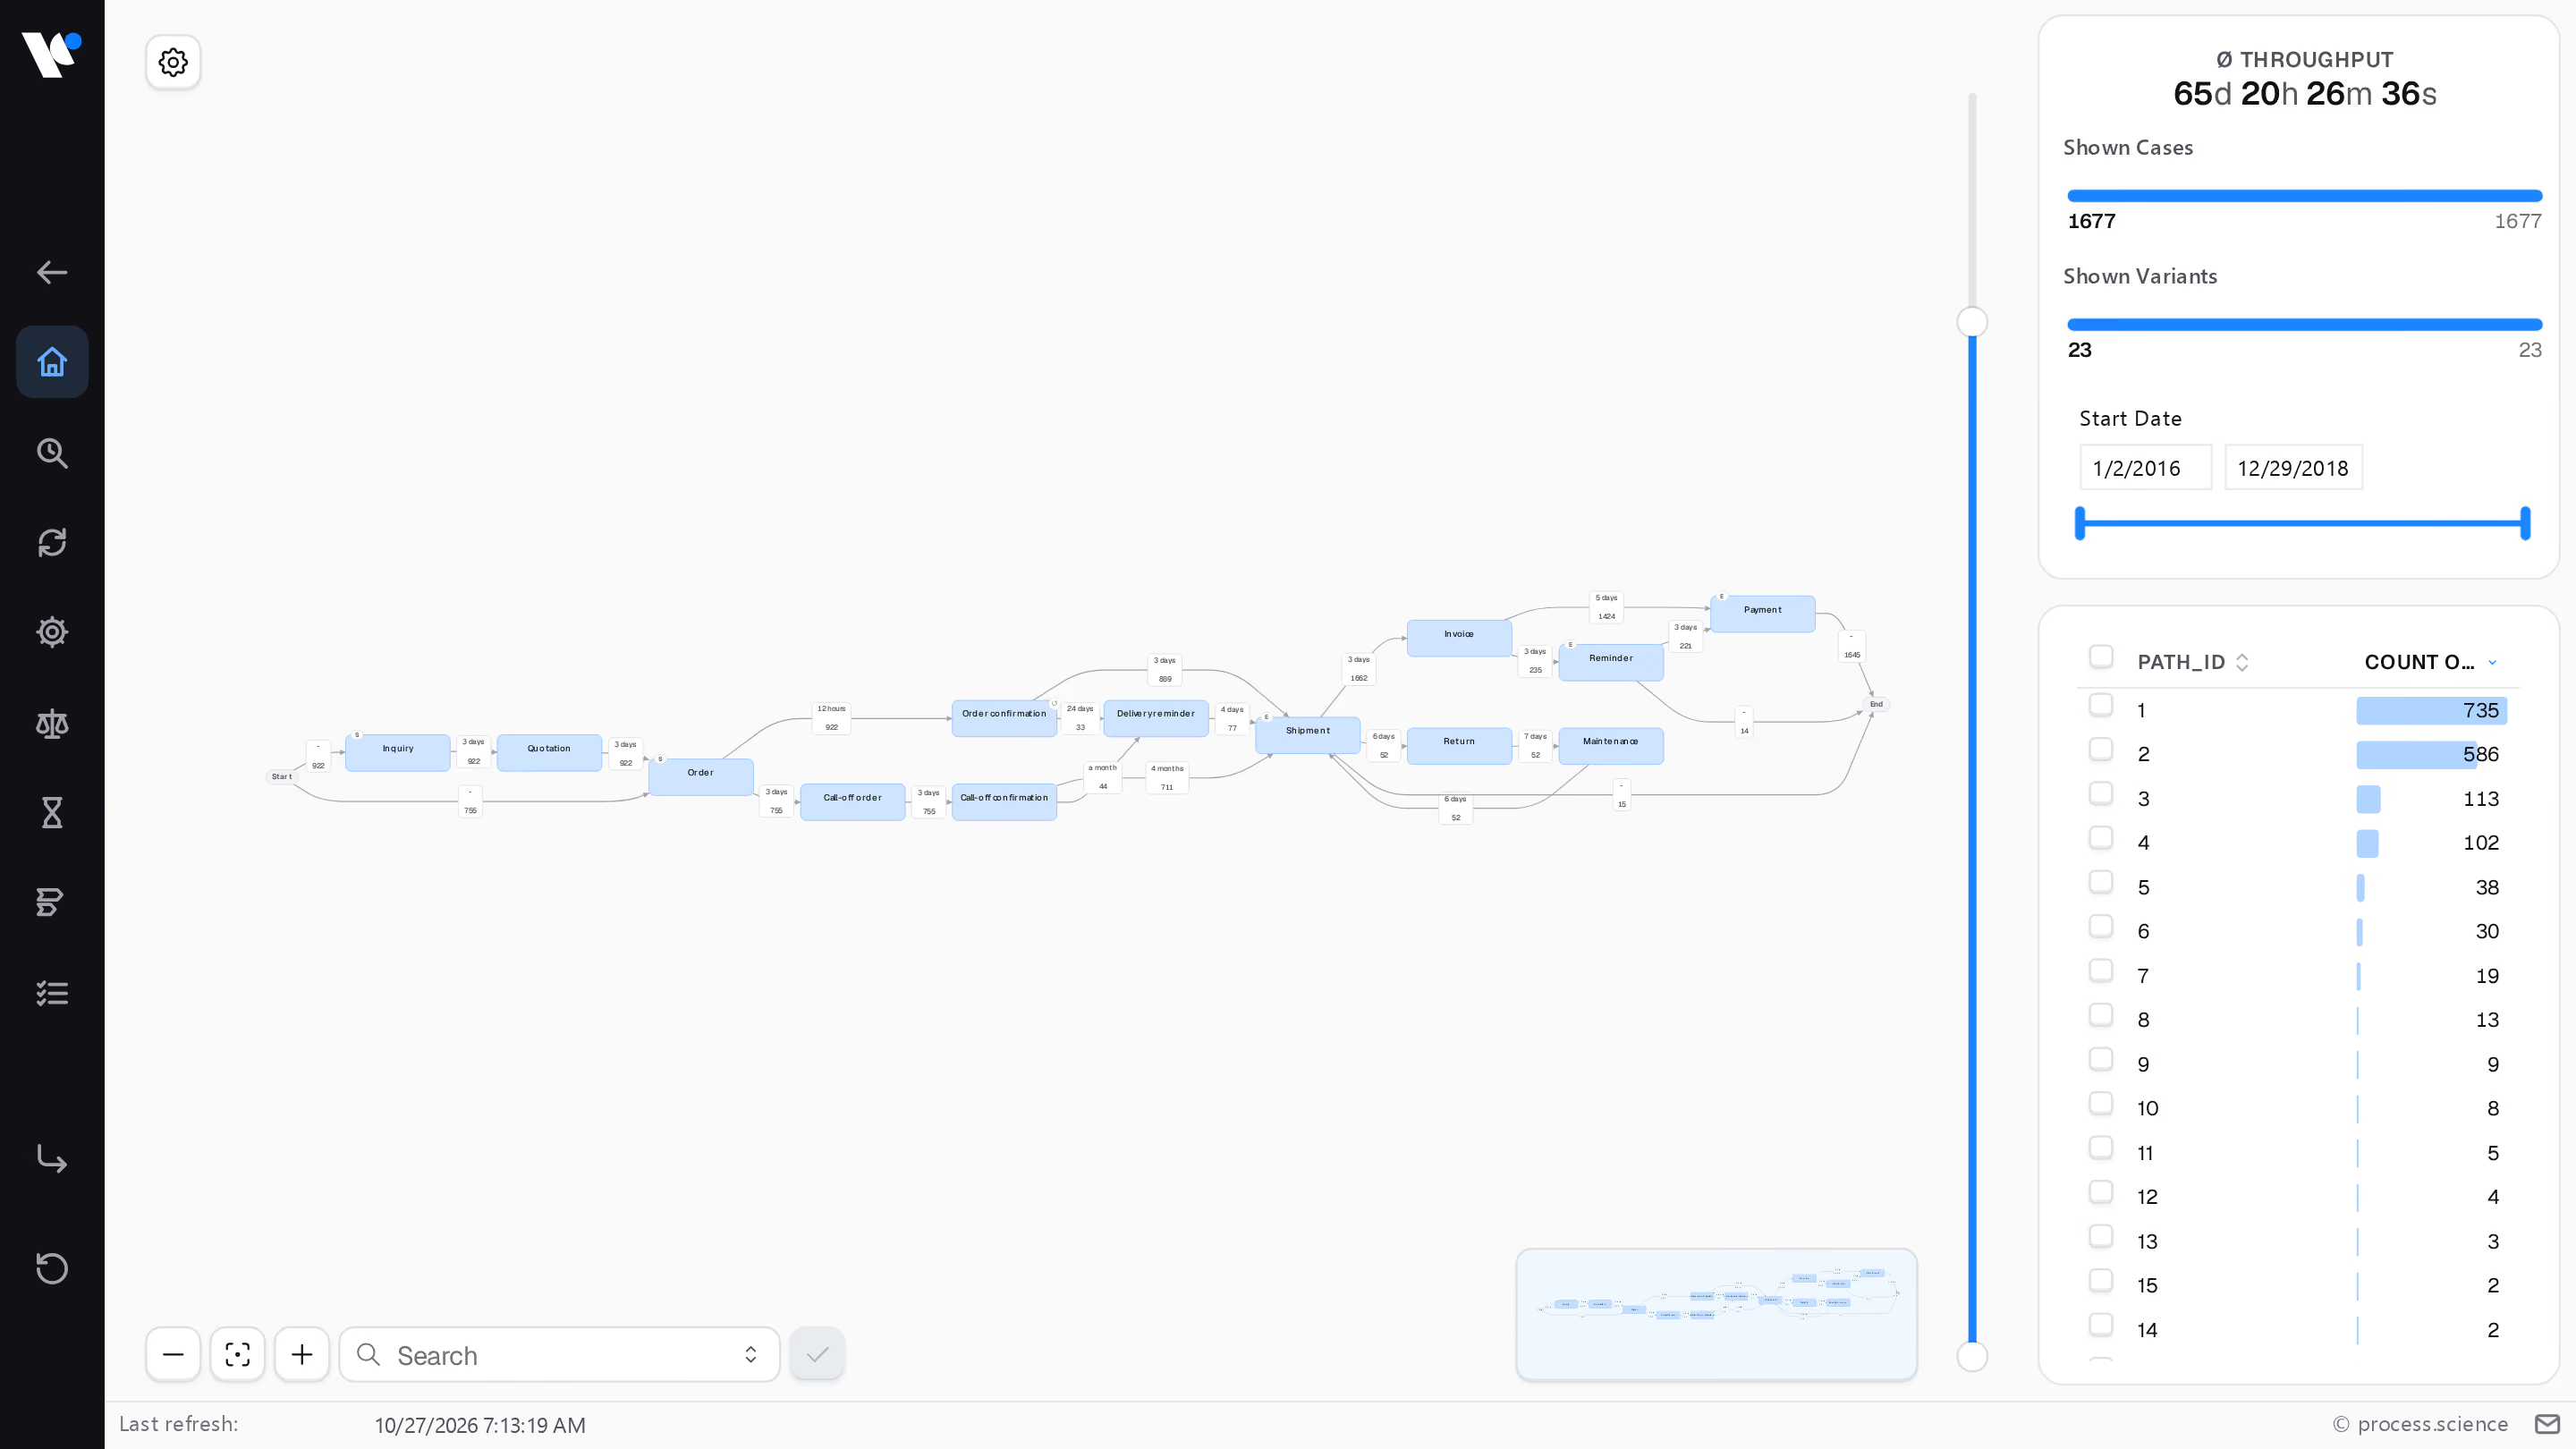

Nein, Sie benötigen keine komplett neue Infrastruktur. Die Datentransformation (ELT) läuft ressourcenschonend auf Ihrer bestehenden SQL-Datenbank (z. B. Azure SQL, MS SQL Server). Die Visualisierung und Analyse finden vollständig in Ihrer vorhandenen Power BI Umgebung über unsere Custom Visuals statt. Es gibt keine versteckte process.science Cloud.
Um Process Mining zu starten, erzeugen wir aus Ihren Quellsystemen ein sogenanntes Event Log. Das ist im Grunde eine flache Tabelle mit drei zwingenden Kern-Spalten:
1. Case ID (z. B. eine Bestellnummer)
2. Activity Name (z. B. "Rechnung freigegeben")
3. Timestamp (z. B. "2026-03-20 14:30:00")
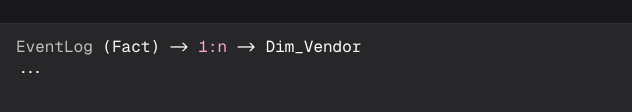
Alle weiteren Metadaten (Nutzer, Abteilung, Rechnungswert) können über Standard-Power-BI-Beziehungen im Sternschema verknüpft werden.
Unsere Komplettlösung funktioniert einwandfrei mit Power BI Pro, Premium per User (PPU) und Premium-Kapazitäten (Microsoft Fabric). Da wir die rechenintensive Datentransformation in Ihre SQL-Datenbank auslagern, bleibt Power BI performant – unabhängig von Ihrer Lizenzstufe.
Grundsätzlich ja. Unser Visual ist kompatibel mit dem Power BI Report Server für reine On-Premises-Szenarien. Da Microsoft dort jedoch teils ältere Versionen der Visual-Engine verwendet, prüfen wir im Vorfeld eines PoC gerne die Kompatibilität mit Ihrer spezifischen Server-Version.
Da unsere Dashboards und Visuals nahtlos in das Power BI Datenmodell integriert sind, greifen alle Ihre bestehenden RLS-Regeln automatisch. Wenn ein Einkäufer nur die Daten für Werk A sehen darf, rendert der Prozessgraph vollautomatisch auch nur den Prozessfluss für Werk A. Es ist kein doppelter Pflegeaufwand der Rechte nötig.