Solution complète pour Microsoft Power BI

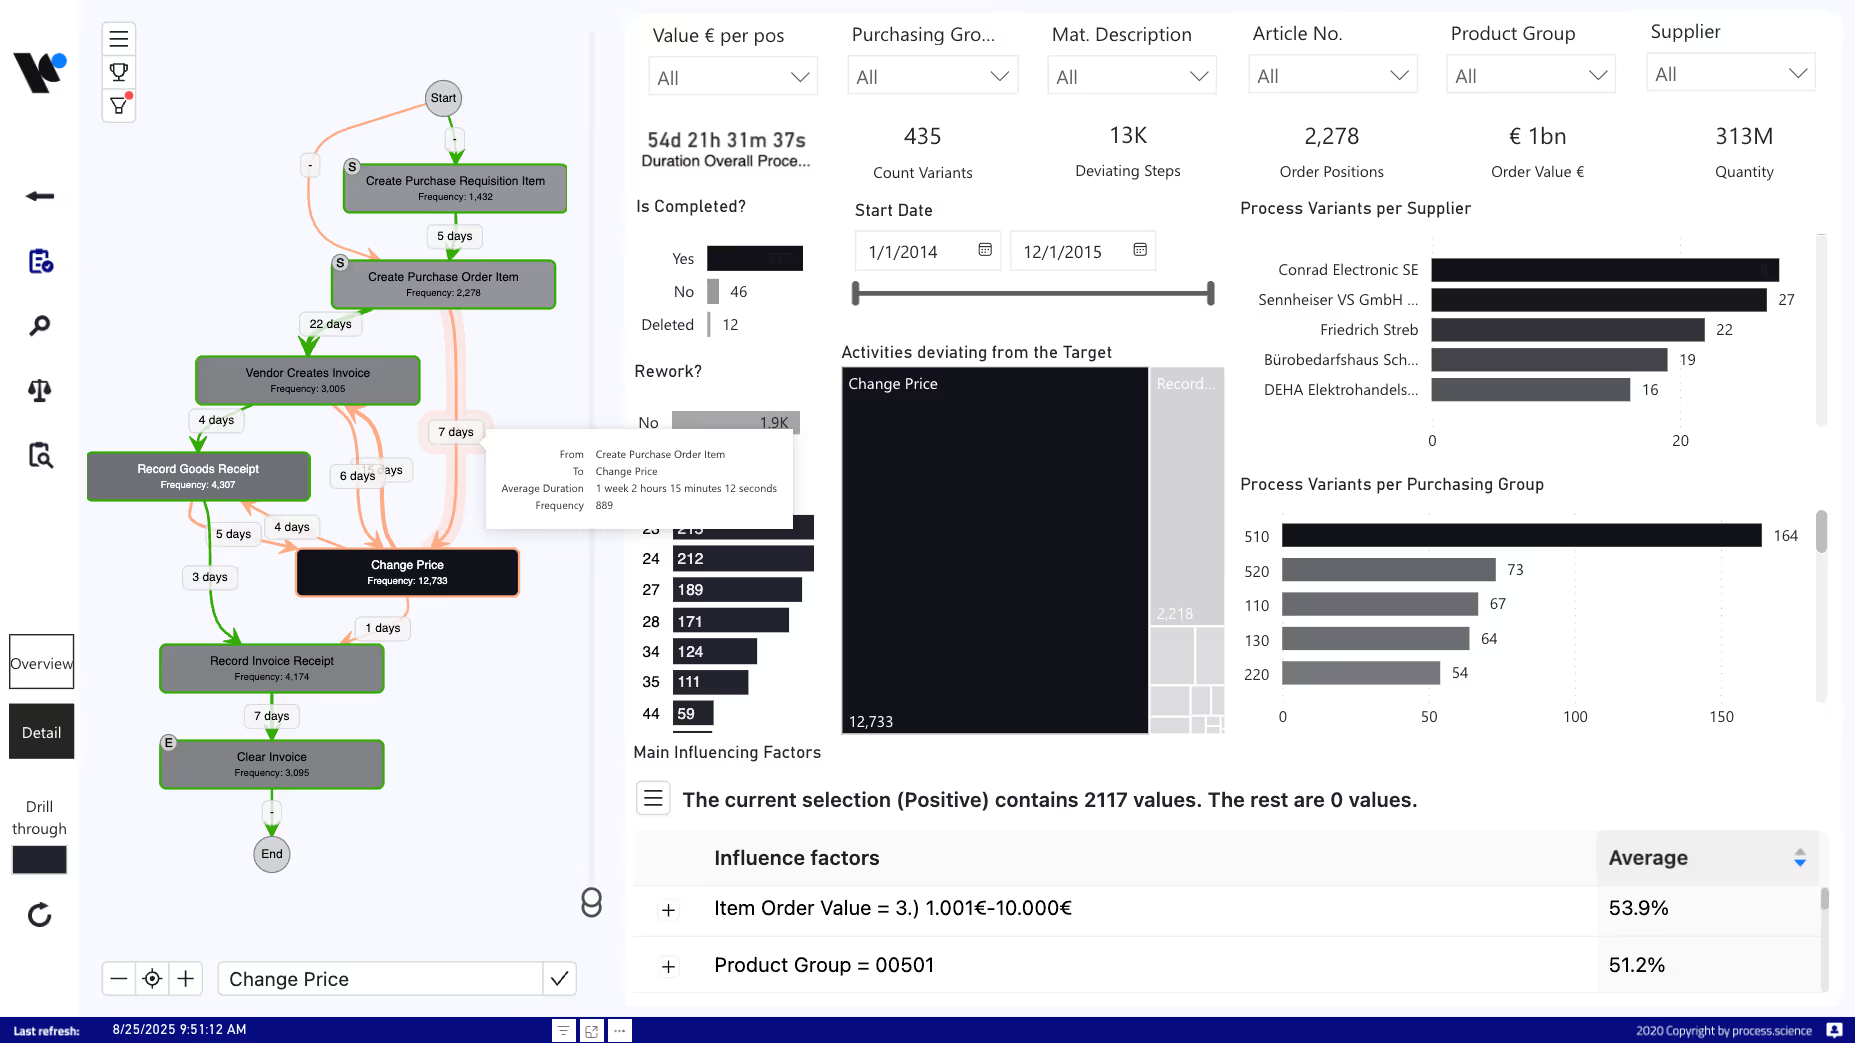
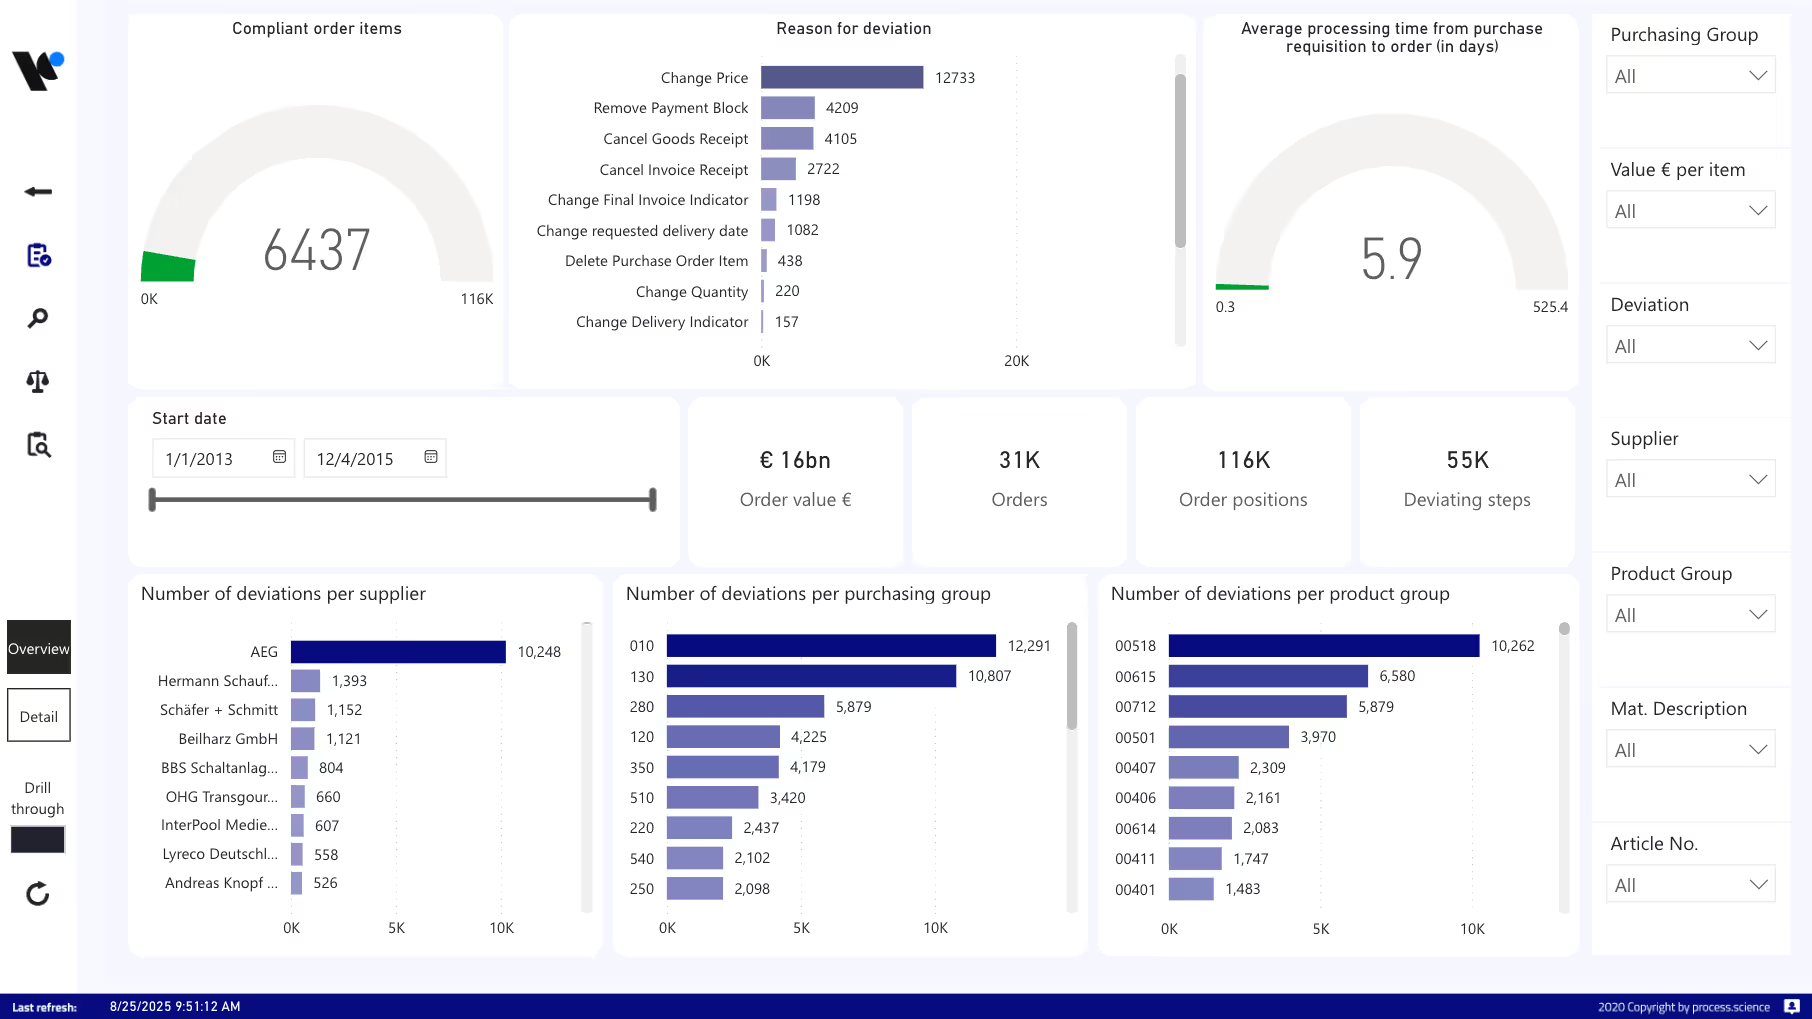

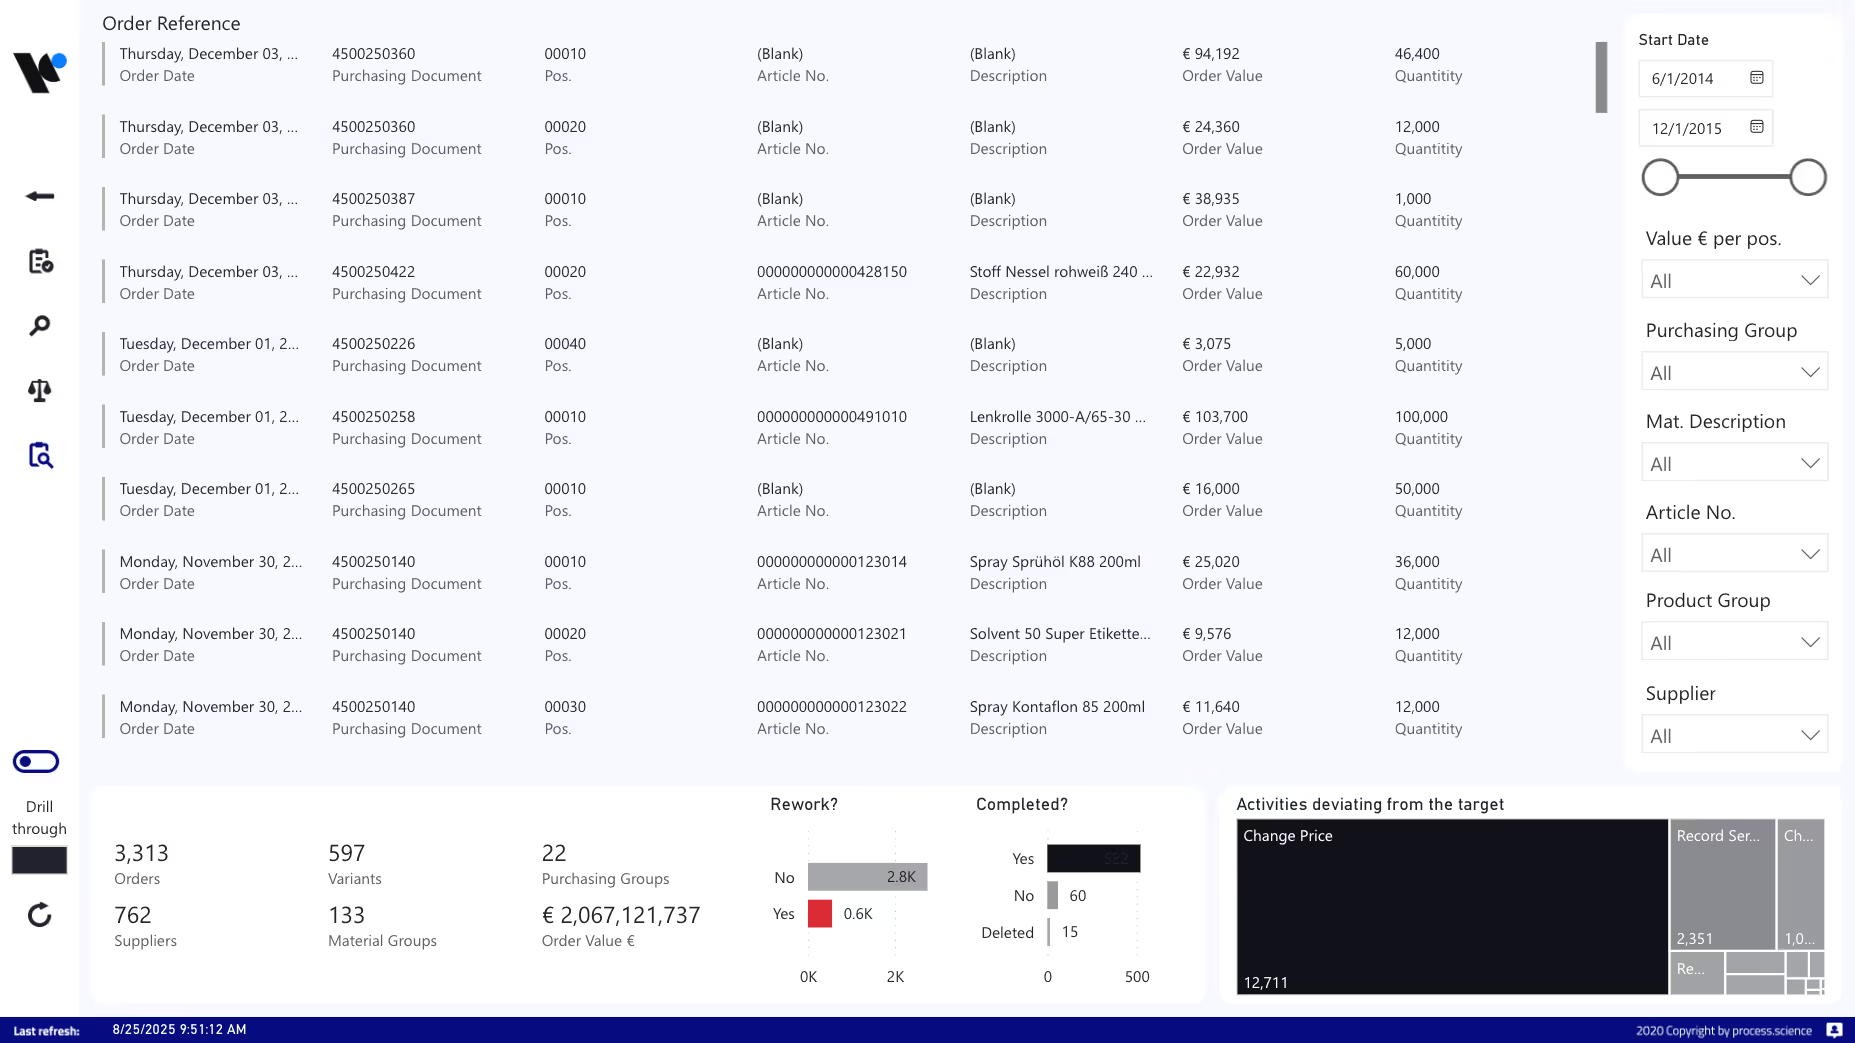

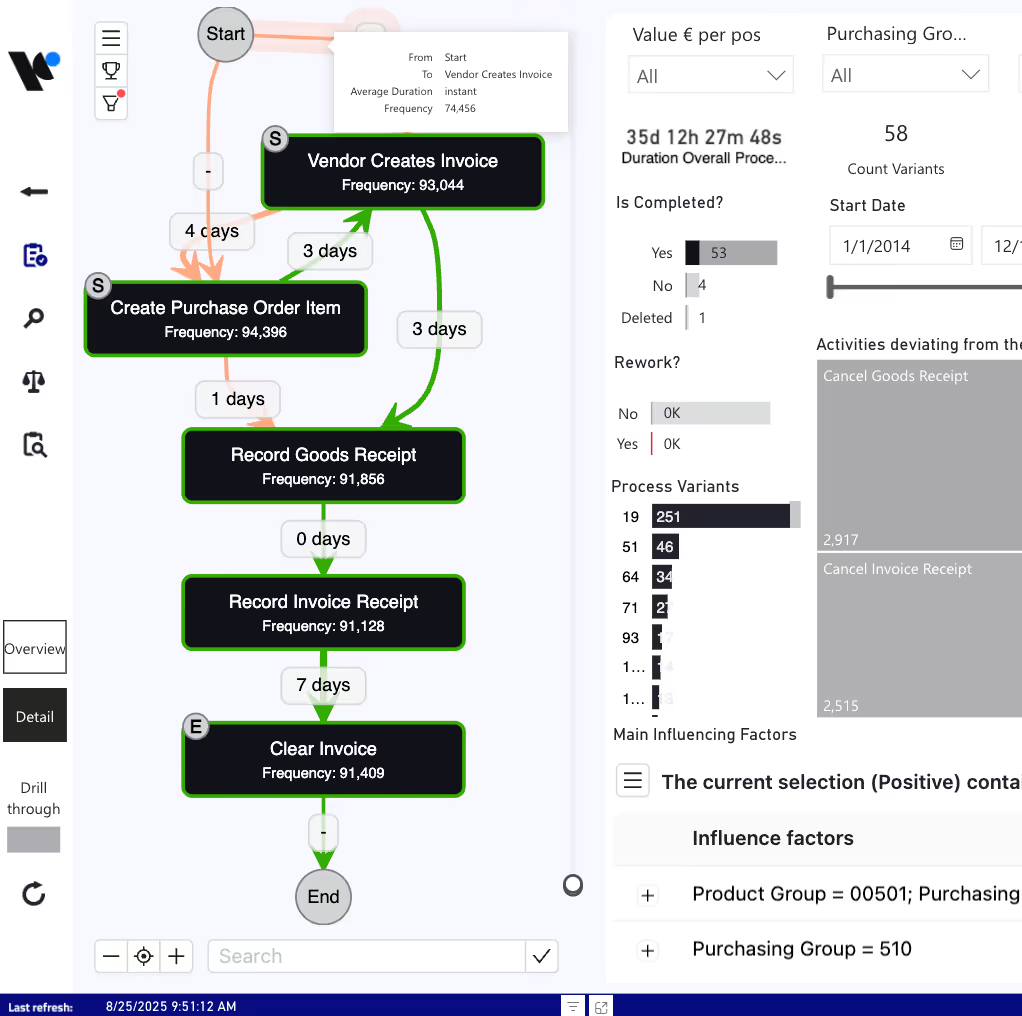

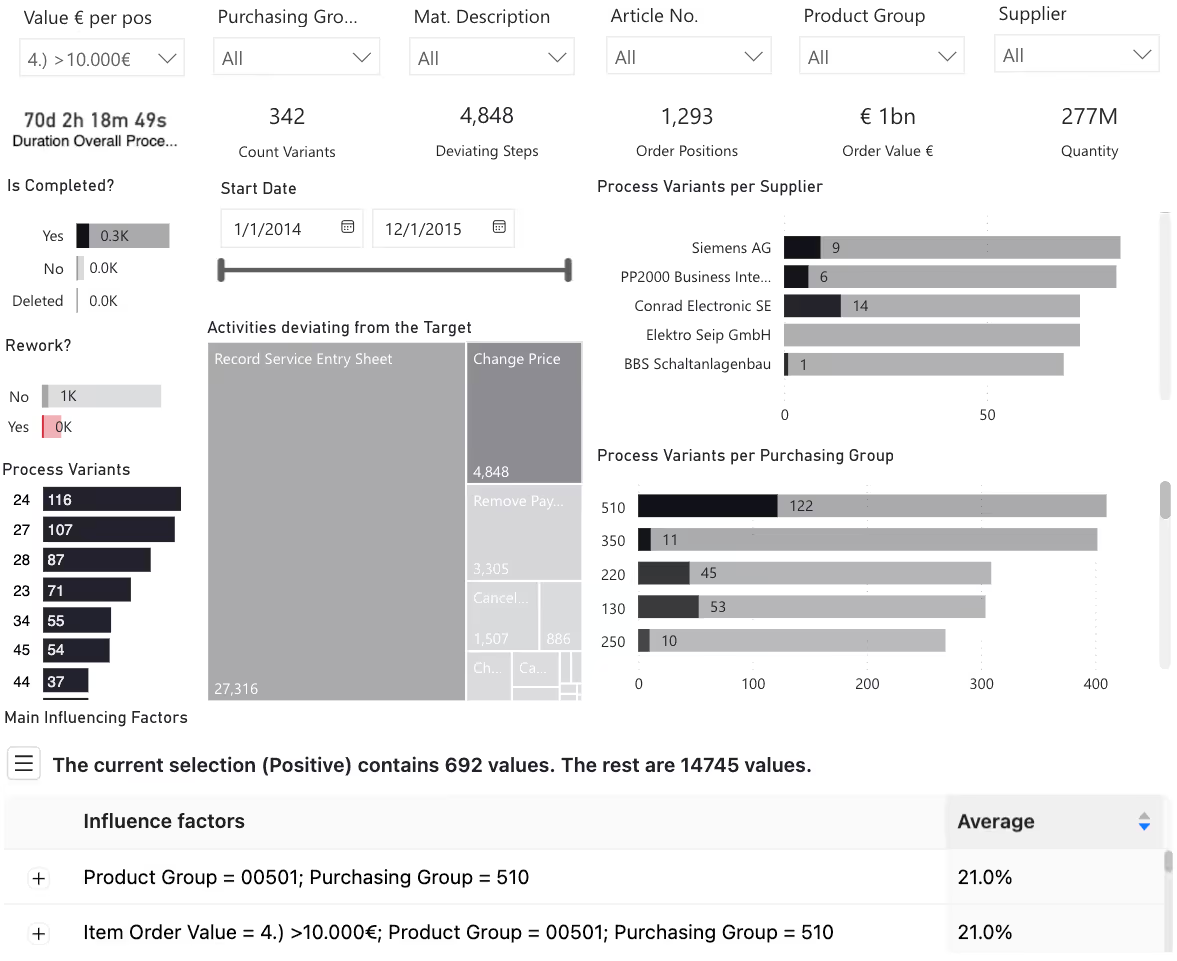
Non, vous n'avez pas besoin d'une infrastructure entièrement nouvelle. La transformation des données (ELT) s'exécute de manière efficace sur votre base de données SQL existante (par ex. Azure SQL, MS SQL Server). La visualisation et l'analyse s'effectuent entièrement au sein de votre environnement Power BI actuel grâce à nos visuels personnalisés. Il n'y a pas de cloud process.science caché.
Pour démarrer le Process Mining, nous générons un journal d'événements à partir de vos systèmes sources. Il s'agit essentiellement d'une table plate comportant trois colonnes principales obligatoires :
1. ID de dossier (par ex. un numéro de commande)
2. Nom de l'activité (par ex. « Facture approuvée »)
3. Horodatage (par ex. « 2026-03-20 14:30:00 »)
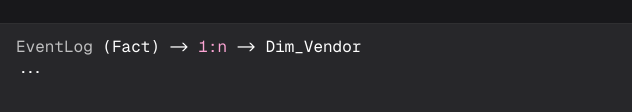
Toutes les autres métadonnées (utilisateur, département, valeur de la facture) peuvent être liées via des relations Power BI standard dans un schéma en étoile.
Notre solution complète fonctionne parfaitement avec Power BI Pro, Premium par utilisateur (PPU) et les capacités Premium (Microsoft Fabric). Comme nous déportons la transformation de données intensive vers votre base de données SQL, Power BI reste performant quel que soit votre niveau de licence.
En principe, oui. Notre visuel est compatible avec Power BI Report Server pour les scénarios purement sur site. Cependant, comme Microsoft utilise parfois des versions plus anciennes du moteur visuel dans ce cadre, nous vérifions volontiers la compatibilité avec votre version de serveur spécifique avant une preuve de concept.
Comme nos tableaux de bord et visuels s'intègrent parfaitement au modèle de données Power BI, toutes vos règles RLS existantes s'appliquent automatiquement. Si un acheteur n'est autorisé à voir que les données de l'usine A, le graphique de processus n'affichera automatiquement que le flux de travail de l'usine A. Aucune gestion des droits en double n'est nécessaire.