Solución completa para Microsoft Power BI

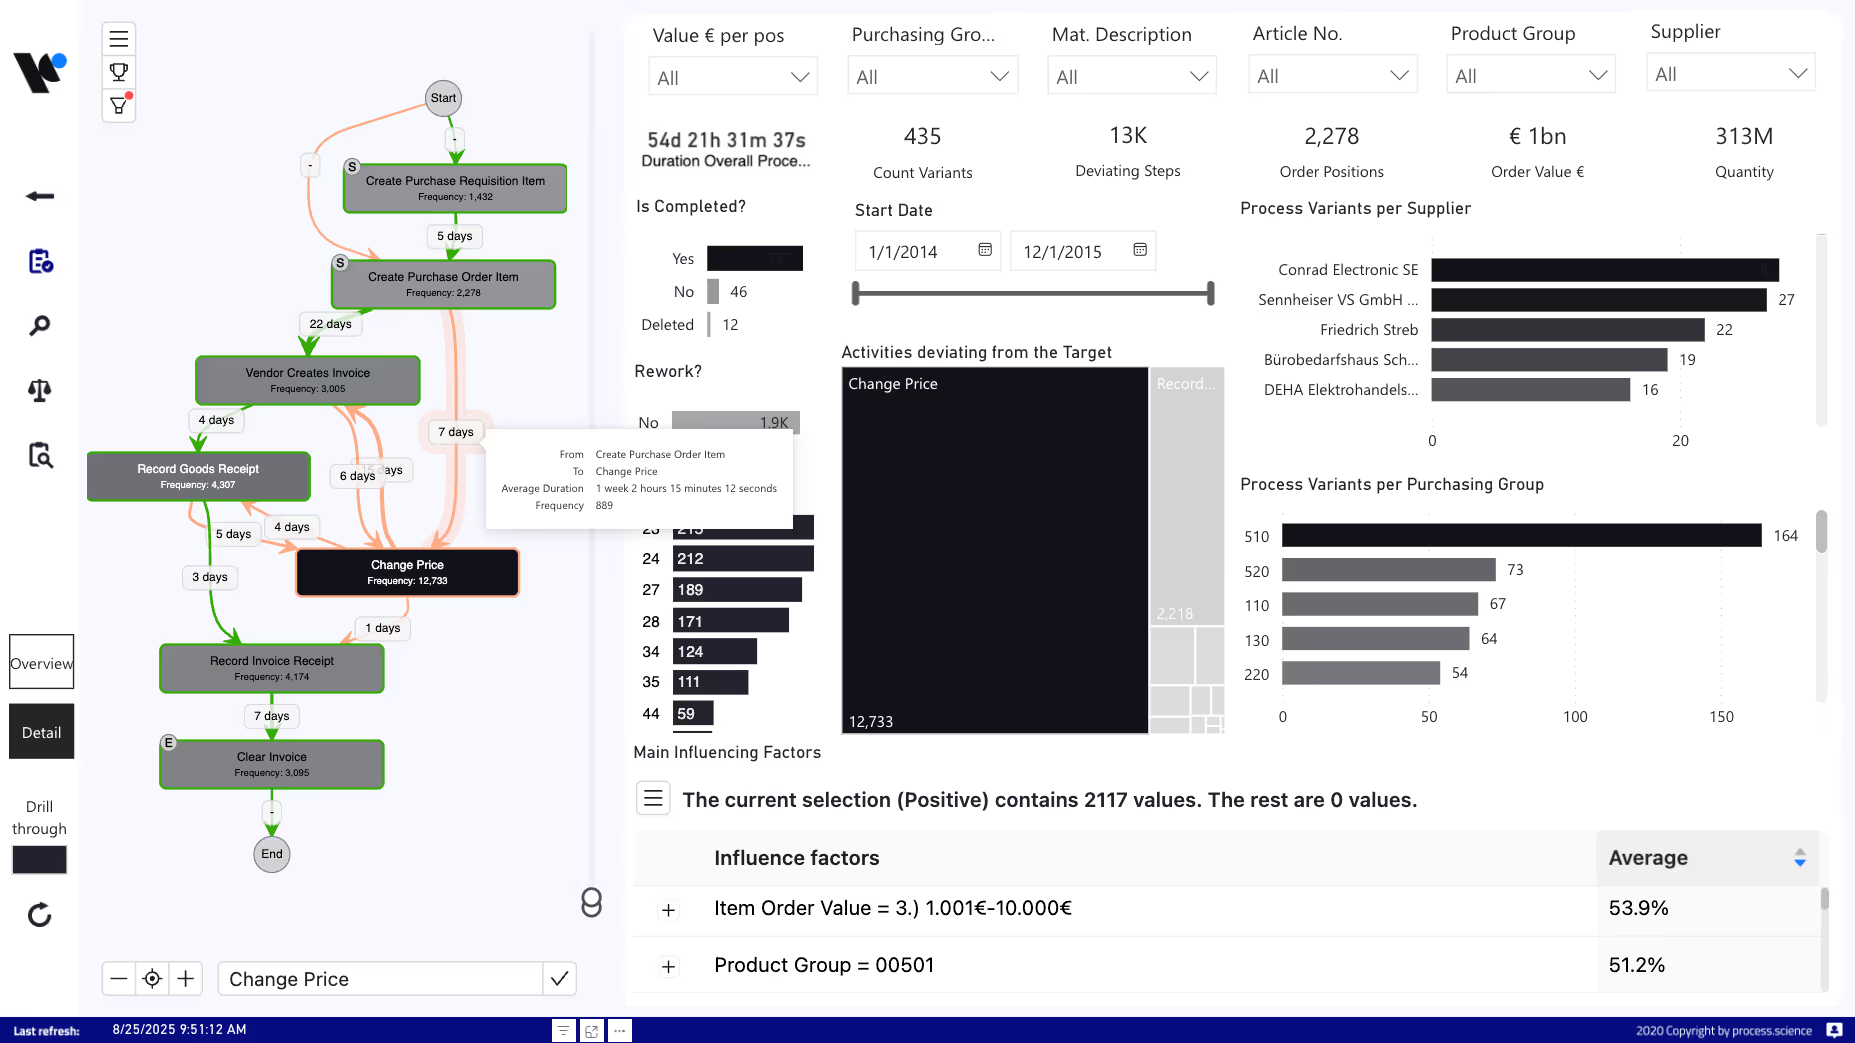
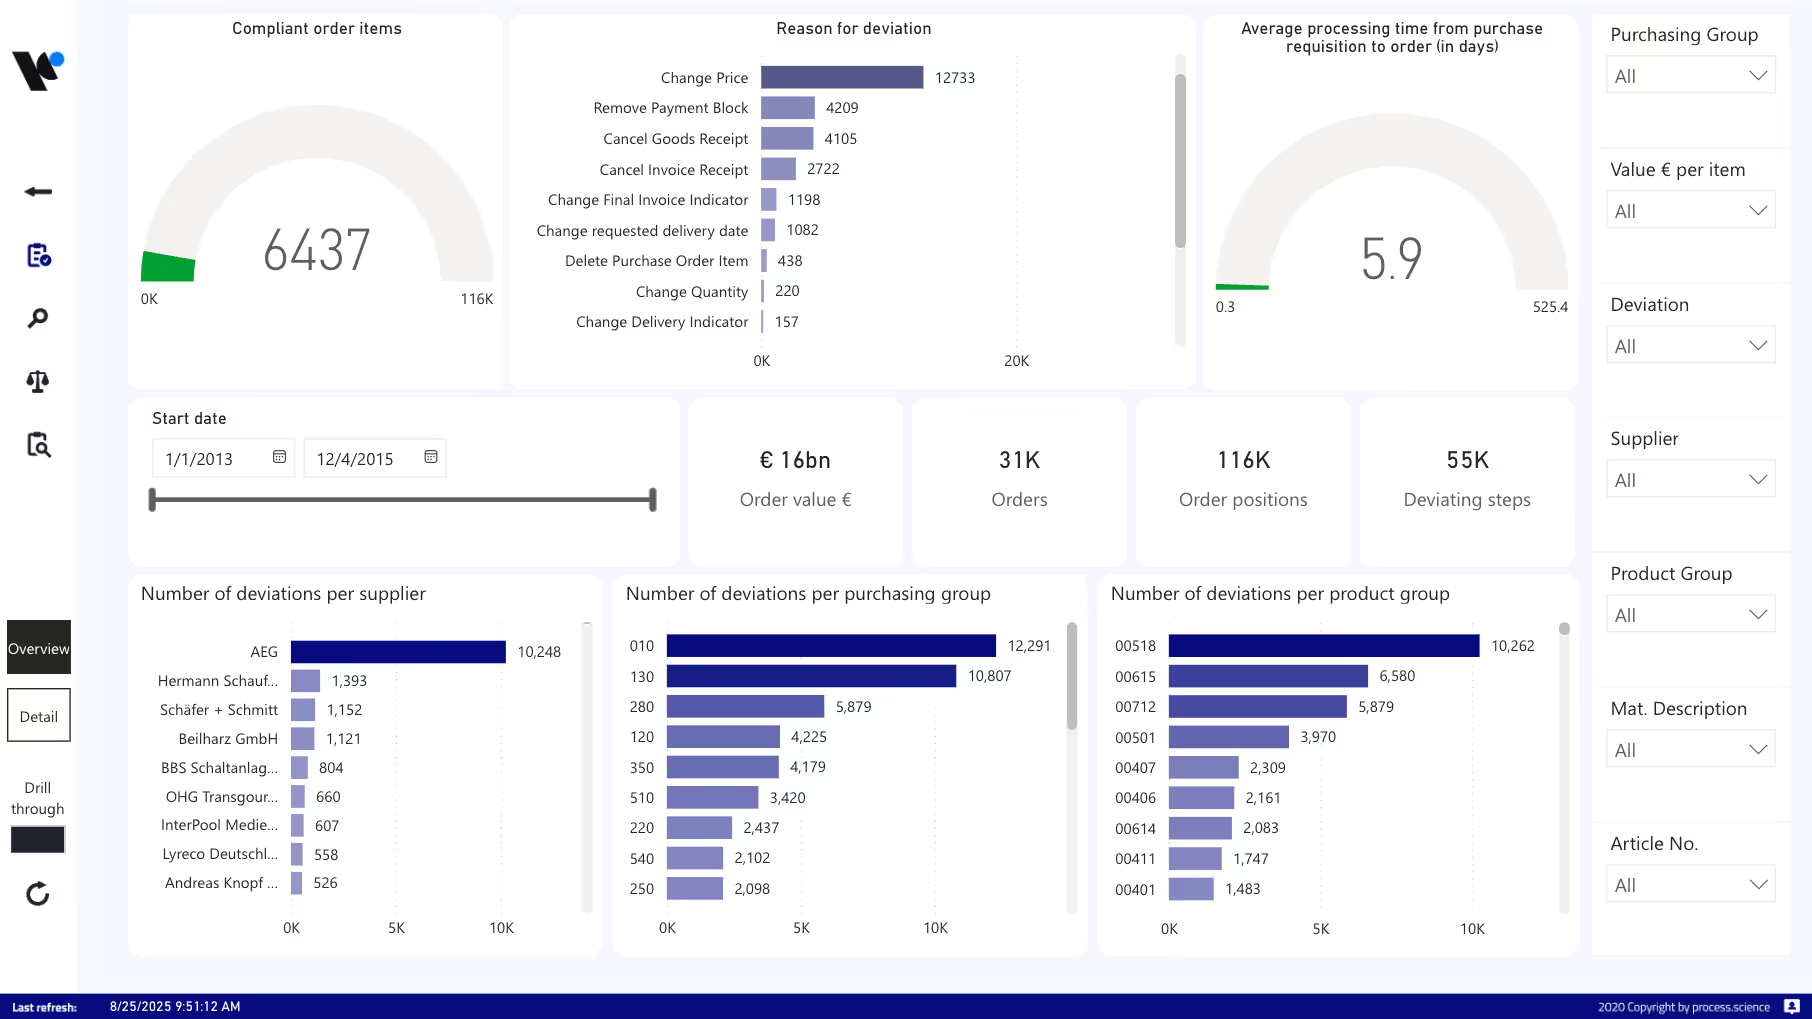

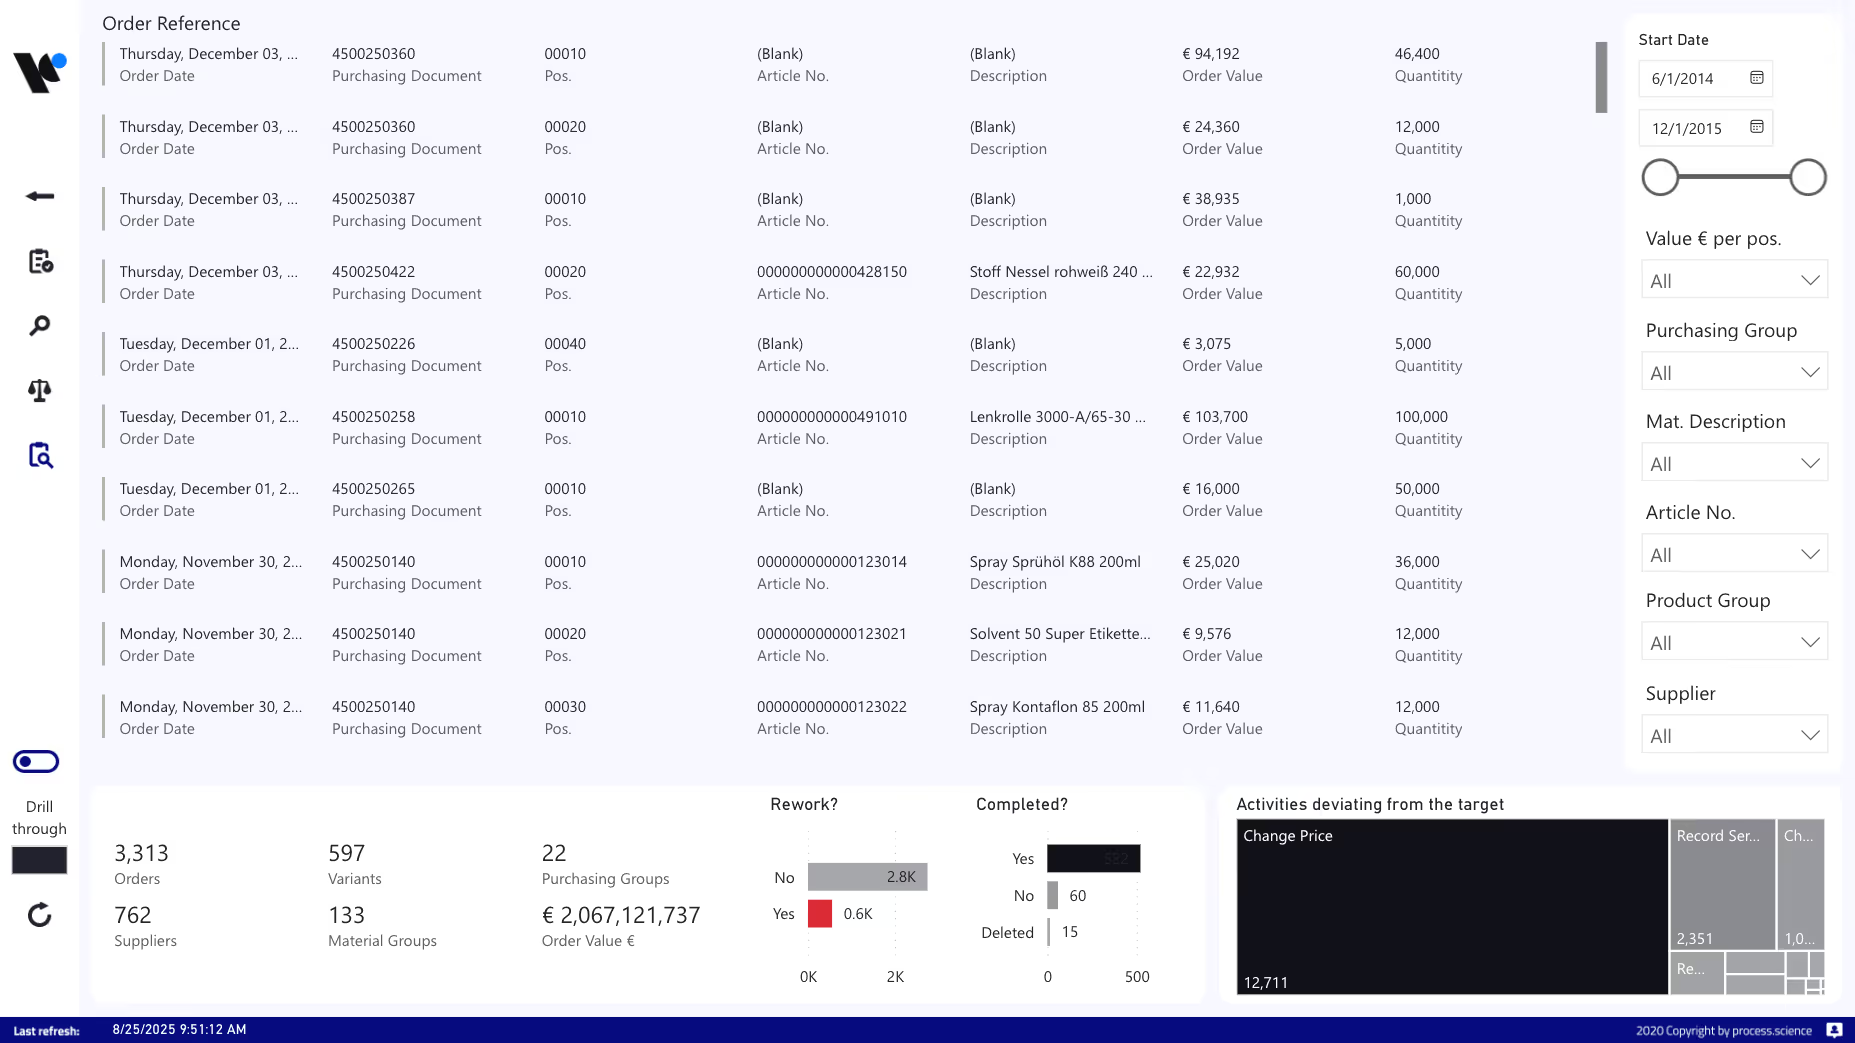

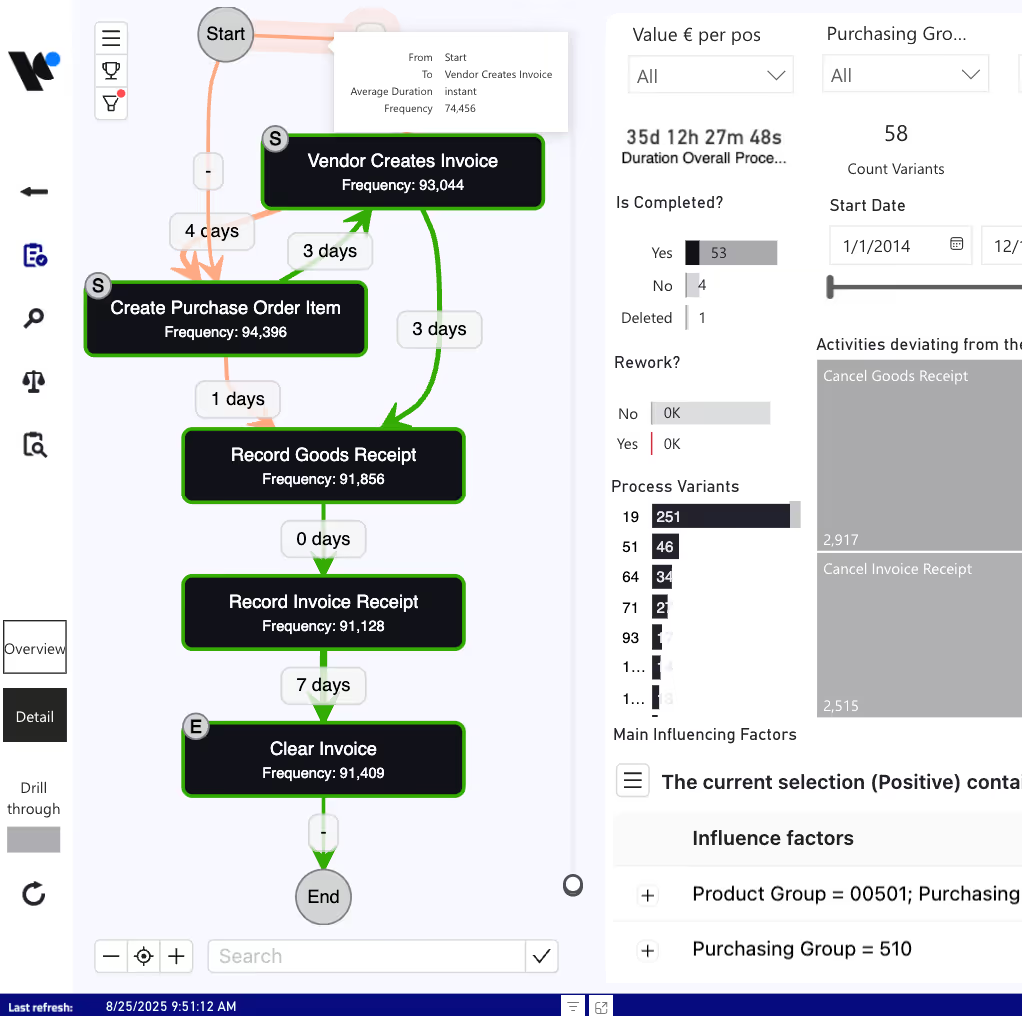

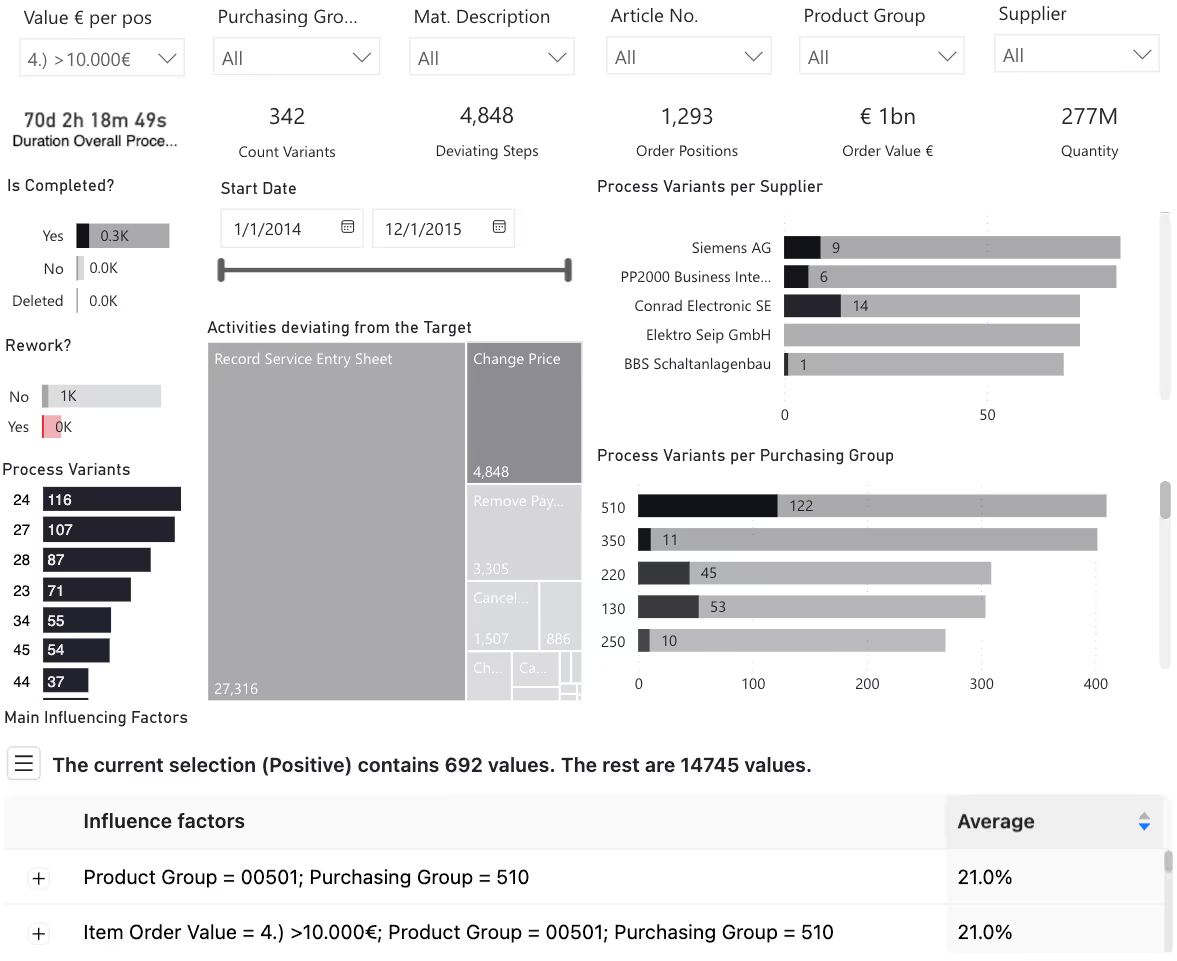
No, no necesita una infraestructura completamente nueva. La transformación de datos (ELT) se ejecuta de forma eficiente en su base de datos SQL existente (por ejemplo, Azure SQL, MS SQL Server). La visualización y el análisis se realizan íntegramente dentro de su entorno de Power BI actual mediante nuestros objetos visuales personalizados. No existe ninguna nube oculta de process.science.
Para comenzar con la minería de procesos, generamos un registro de eventos a partir de sus sistemas de origen. Básicamente, se trata de una tabla plana con tres columnas principales obligatorias:
1. ID del caso (p. ej., un número de pedido)
2. Nombre de la actividad (p. ej., "Factura aprobada")
3. Marca de tiempo (p. ej., "2026-03-20 14:30:00")
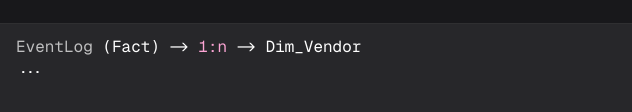
El resto de los metadatos (usuario, departamento, valor de la factura) pueden vincularse mediante relaciones estándar de Power BI en un esquema en estrella.
Nuestra solución completa funciona perfectamente con Power BI Pro, Premium por usuario (PPU) y capacidades Premium (Microsoft Fabric). Como delegamos la transformación de datos intensiva en recursos a su base de datos SQL, Power BI mantiene su rendimiento independientemente de su nivel de licencia.
En principio, sí. Nuestro objeto visual es compatible con Power BI Report Server para escenarios puramente locales (on-premises). Sin embargo, dado que Microsoft a veces utiliza versiones anteriores del motor visual en esos casos, estaremos encantados de comprobar la compatibilidad con su versión específica de servidor antes de realizar una PdC.
Dado que nuestros paneles y elementos visuales se integran a la perfección en el modelo de datos de Power BI, todas sus reglas de RLS existentes se aplican automáticamente. Si un comprador solo tiene permiso para ver los datos de la Planta A, el gráfico de proceso mostrará automáticamente solo el flujo de trabajo de la Planta A. No es necesario duplicar el mantenimiento de permisos.